语音接入已经能出声,接下来常会遇到另一个决策:如果声音断续,要不要把缓冲加大?更多缓冲能多接住一些暂时处理不完的音频,却也可能让设备继续处理更早的内容。要判断该不该加,得先知道队列里存的是什么,以及装满之后代码会做什么。
小智客户端给出了一个具体对照。同一份 AudioService 中,待编码队列和待发送队列装满时,会扔掉最旧的数据再接收新数据;接收解码队列在默认调用方式下装满时,却会直接返回失败,留住已经排队的内容。这是两种不同的拥塞取舍,不能笼统归为“有缓冲,所以更稳定”。
本文核验 78/xiaozhi-esp32 固定提交 6240b777aaa2bc0cad43a4ce25b30de23f36ad00,日期为 2026-09-10。以下来自官方源码阅读和明确标注的算术推演,没有设备、网络、延迟或音质实测。文中的“队列满”是代码分支允许出现的情境,不是本次复现的故障。
先看队列里是 PCM,还是 Opus 包
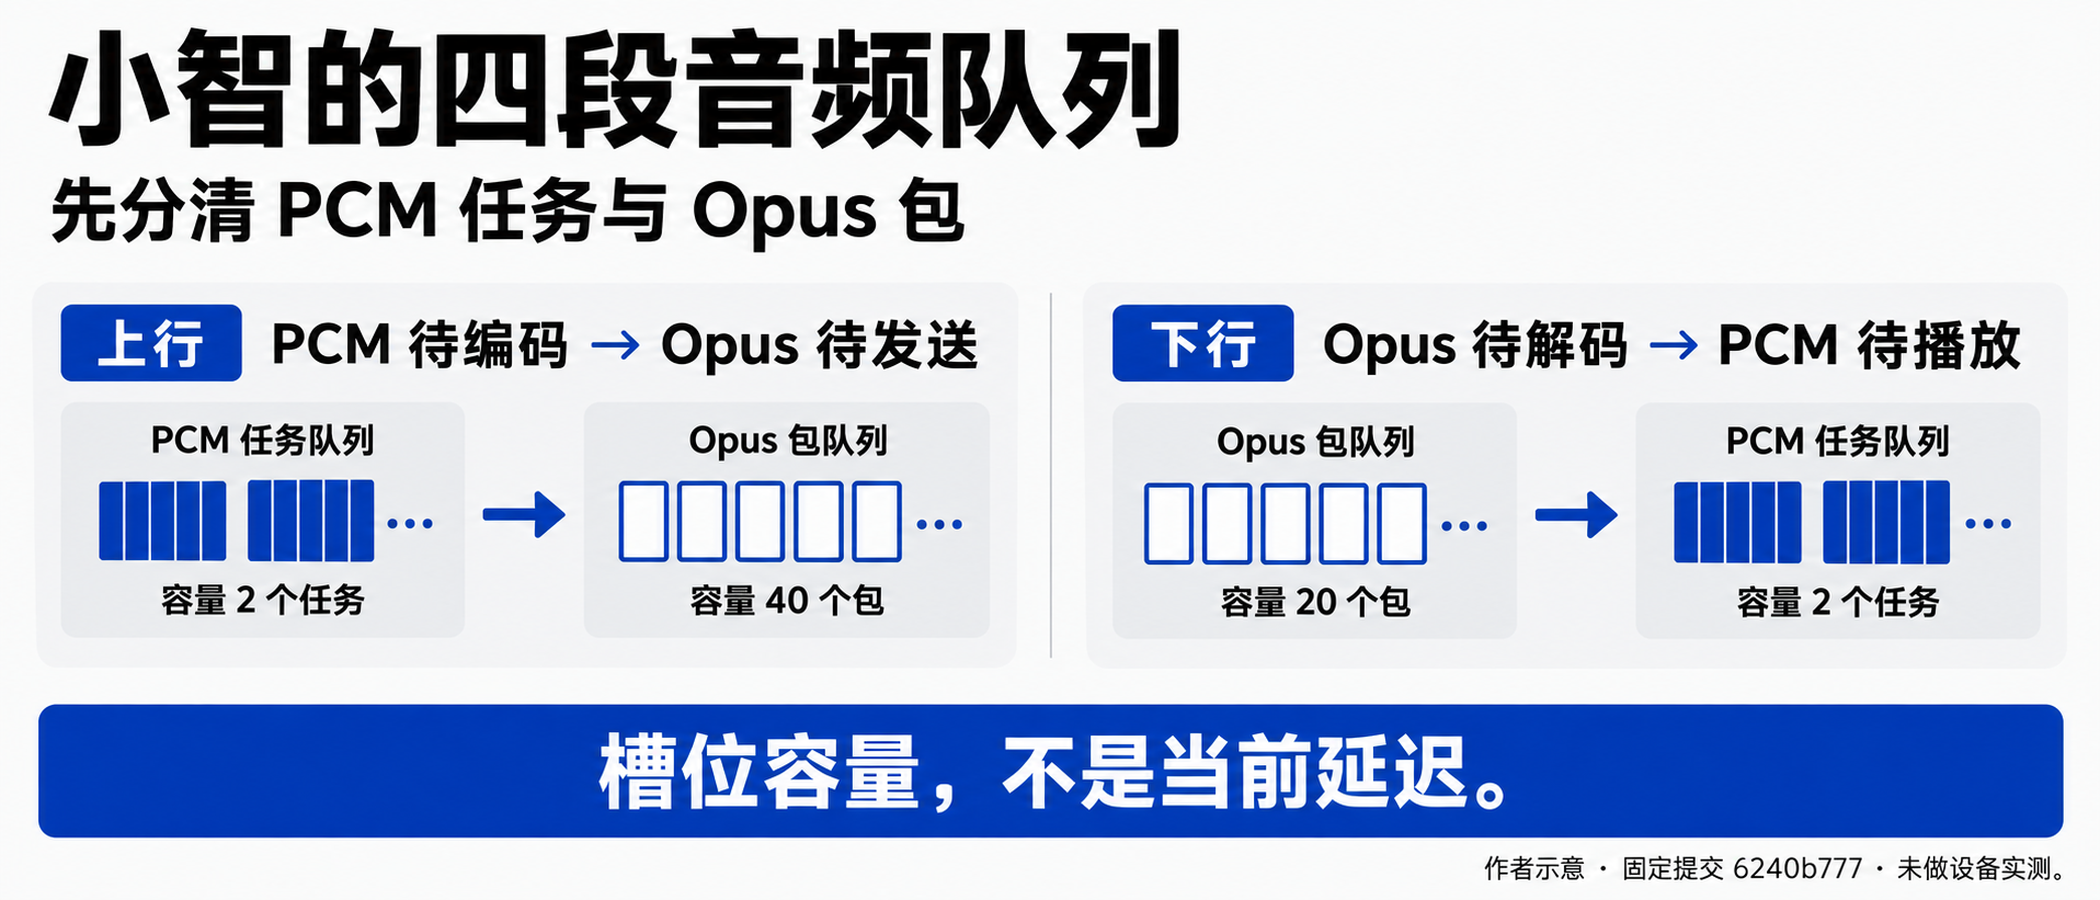
PCM 是一串未压缩的音频采样值;Opus 是将音频编码成压缩载荷的格式。小智的上行流程先把麦克风数据交给音频引擎处理,PCM 经待编码队列进入 Opus 编码器,编码后的包再进入发送队列。下行则反过来:收到的 Opus 包先排队解码,得到 PCM 后进入播放队列,再交给音频输出接口。
上行:音频引擎 → PCM 编码队列 → Opus 编码 → Opus 发送队列 → 服务端
下行:服务端 → Opus 解码队列 → 解码及必要的重采样 → PCM 播放队列 → 输出
这一区分决定了为什么几个队列并不一样大。头文件明确把压缩包队列作为主要缓存,PCM 任务队列则更短。当前宏定义为:
| 队列 | 等待的数据 | 容量定义及结果 |
|---|---|---|
| 编码队列 | 待编码 PCM 任务 | 2 个任务 |
| 发送队列 | 编码后的 Opus 包 | 2400 / 60,40 个包 |
| 解码队列 | 收到的 Opus 包 | 1200 / 60,20 个包 |
| 播放队列 | 解码后的 PCM 任务 | 2 个任务 |
这里的 60 来自 OPUS_FRAME_DURATION_MS。它参与编译期容量计算,也用于当前上行编码配置。编码配置指定 16 kHz、单声道、16 位 PCM 输入,帧时长为 60 ms。音频服务头文件
按这些参数,一份覆盖 60 ms 的单声道 PCM 有 16000 × 0.06 = 960 个采样,纯采样数据占 960 × 2 = 1920 字节。这个算式没有包含容器、任务对象和分配器开销,也不表示编码队列里每个任务必然恰好只有这么多字节。它只展示数据形态对内存的影响;Opus 压缩包的大小还与编码结果有关,不能用 1920 字节直接替代。
因此,给队列“加十格”不是统一的资源操作。给压缩包队列增加槽位和给 PCM 队列增加任务,涉及的内存及处理位置不同。
上行丢旧数据,是为了不让输入一直等
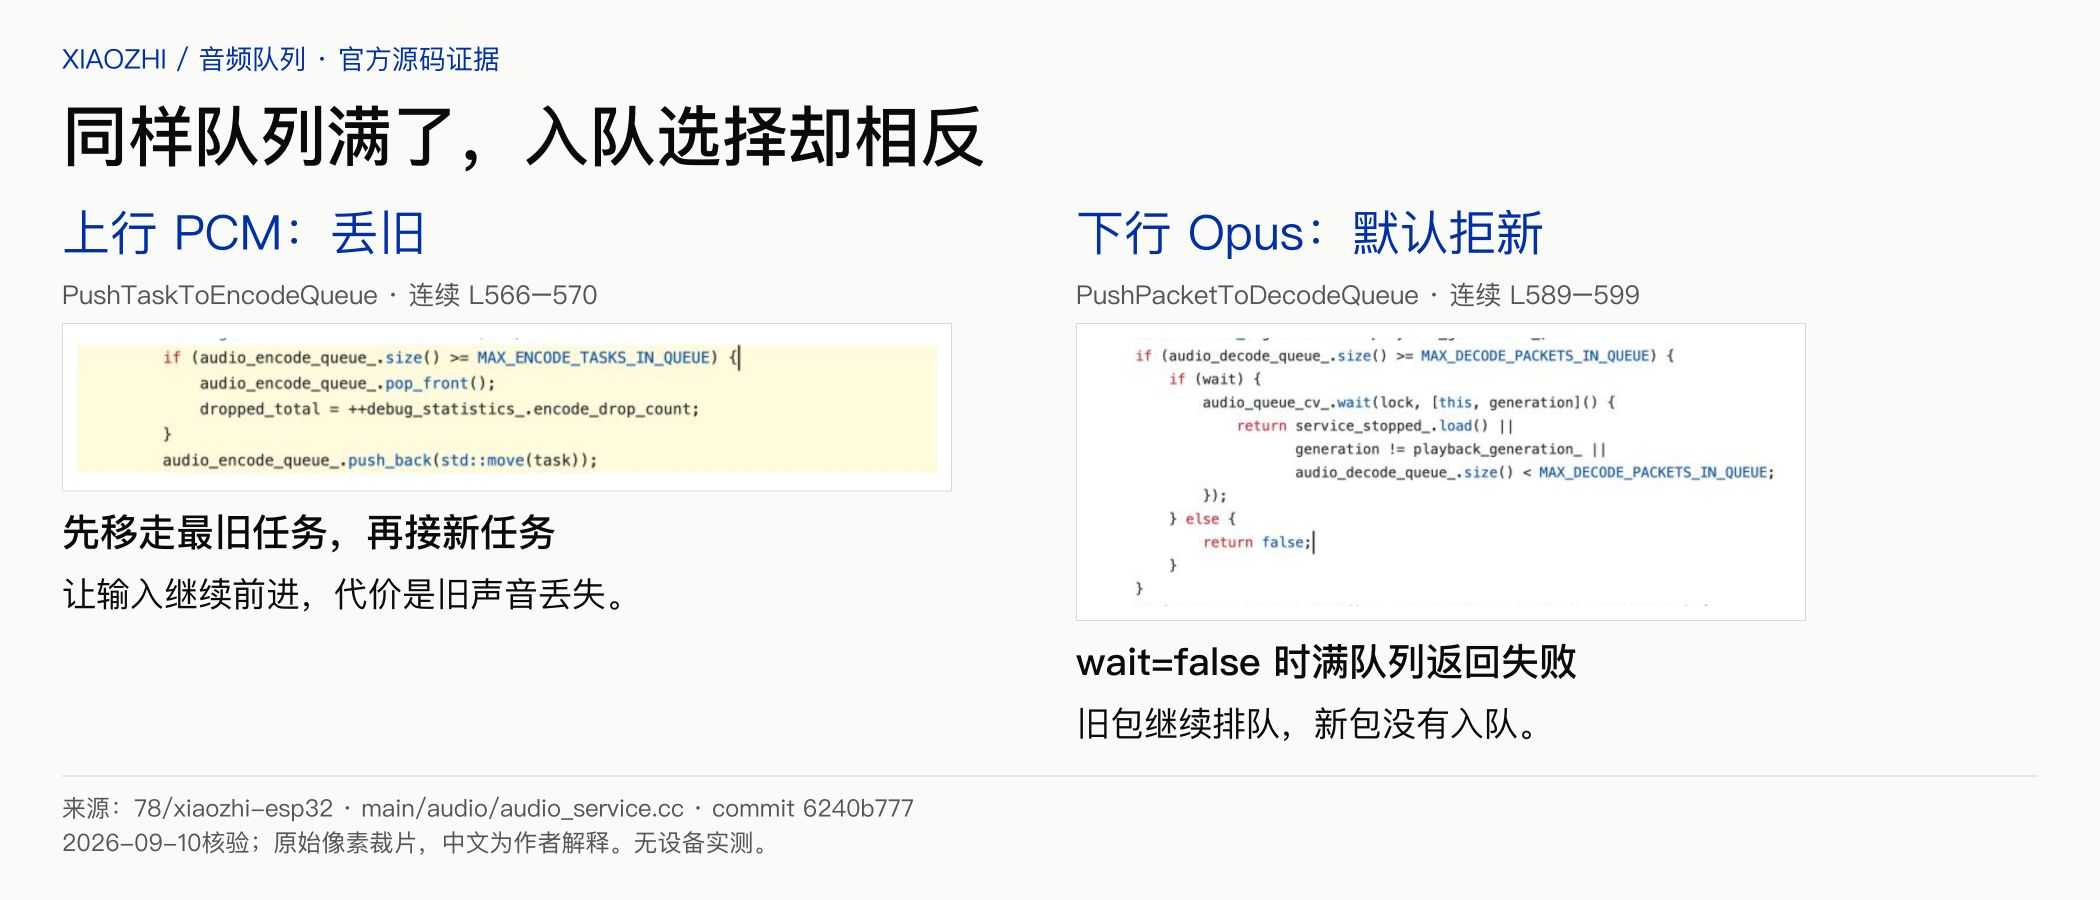
待编码队列由 PushTaskToEncodeQueue() 写入。它在锁内检查长度,满了便执行 pop_front(),然后把新任务放到队尾,并增加编码丢弃计数。源码注释明确解释了选择:麦克风输入具有实时性,如果这里阻塞,发送队列停止排出时可能把音频引擎的输入处理一起拖住。
发送队列也采用类似策略。Opus 编码成功后,如果发送队列已经达到上限,先丢弃最旧包,再追加新包。容量限制在这里并不意味着“满了就暂停录音,等网络恢复”。编码与发送入队实现
可以用一个小例子看清代价。假设编码队列已有较早的 A、B 两个任务,而消费者还没取走它们;C 到来时,代码留下 B、C,A 被丢弃。这是队列规则的示意,不是一次录音测试。它使输入侧能够继续接收较新的数据,但丢掉的那段语音内容不会因为“更实时”而自动回来。
如果在同样的消费速度下扩大队列,系统可以更久不触发丢弃,却也容许更多旧数据留在队里。这个结论是条件推导,不是说扩大缓冲必然增加每次请求的延迟。消费者原本就跟得上、队列一直很短时,上限变化可能根本没有参与运行。
源码为编码队列维护了 encode_drop_count,其日志还做了限频;发送队列的这段丢旧分支没有同步增加该计数。所以,看到编码丢弃计数为零,不能据此证明发送队列从未丢包。记录指标时必须说明它覆盖哪一段路径。
下行默认拒新包,播放满了会让解码停下来
下行入口 PushPacketToDecodeQueue() 的默认参数是 wait=false。当解码队列满时,这条路径直接 return false,不会先腾出一个旧包的位置。应用层的来音回调仅在设备处于 Speaking 状态时调用它,没有显式传入等待参数,也没有检查这次调用的返回值。解码入队实现、应用来音回调
这意味着,在上述条件下出现的新包并没有进入解码队列,而已经排队的包仍然保留。它与上行“给新内容让位置”相反。这里只能确认这个调用点没有处理失败返回,不能由此宣称整个系统绝无日志或其他观测手段。
同一函数还提供等待模式。PlaySound() 解析本地 Ogg 音频时会传入 true:满了就等待空槽,服务停止或播放代次变化也能让等待结束。结束后还会检查这两种状态,必要时仍返回失败。因此,等待模式表示调用方接受等待空间的行为,不是“本地音频保证全部播放”。
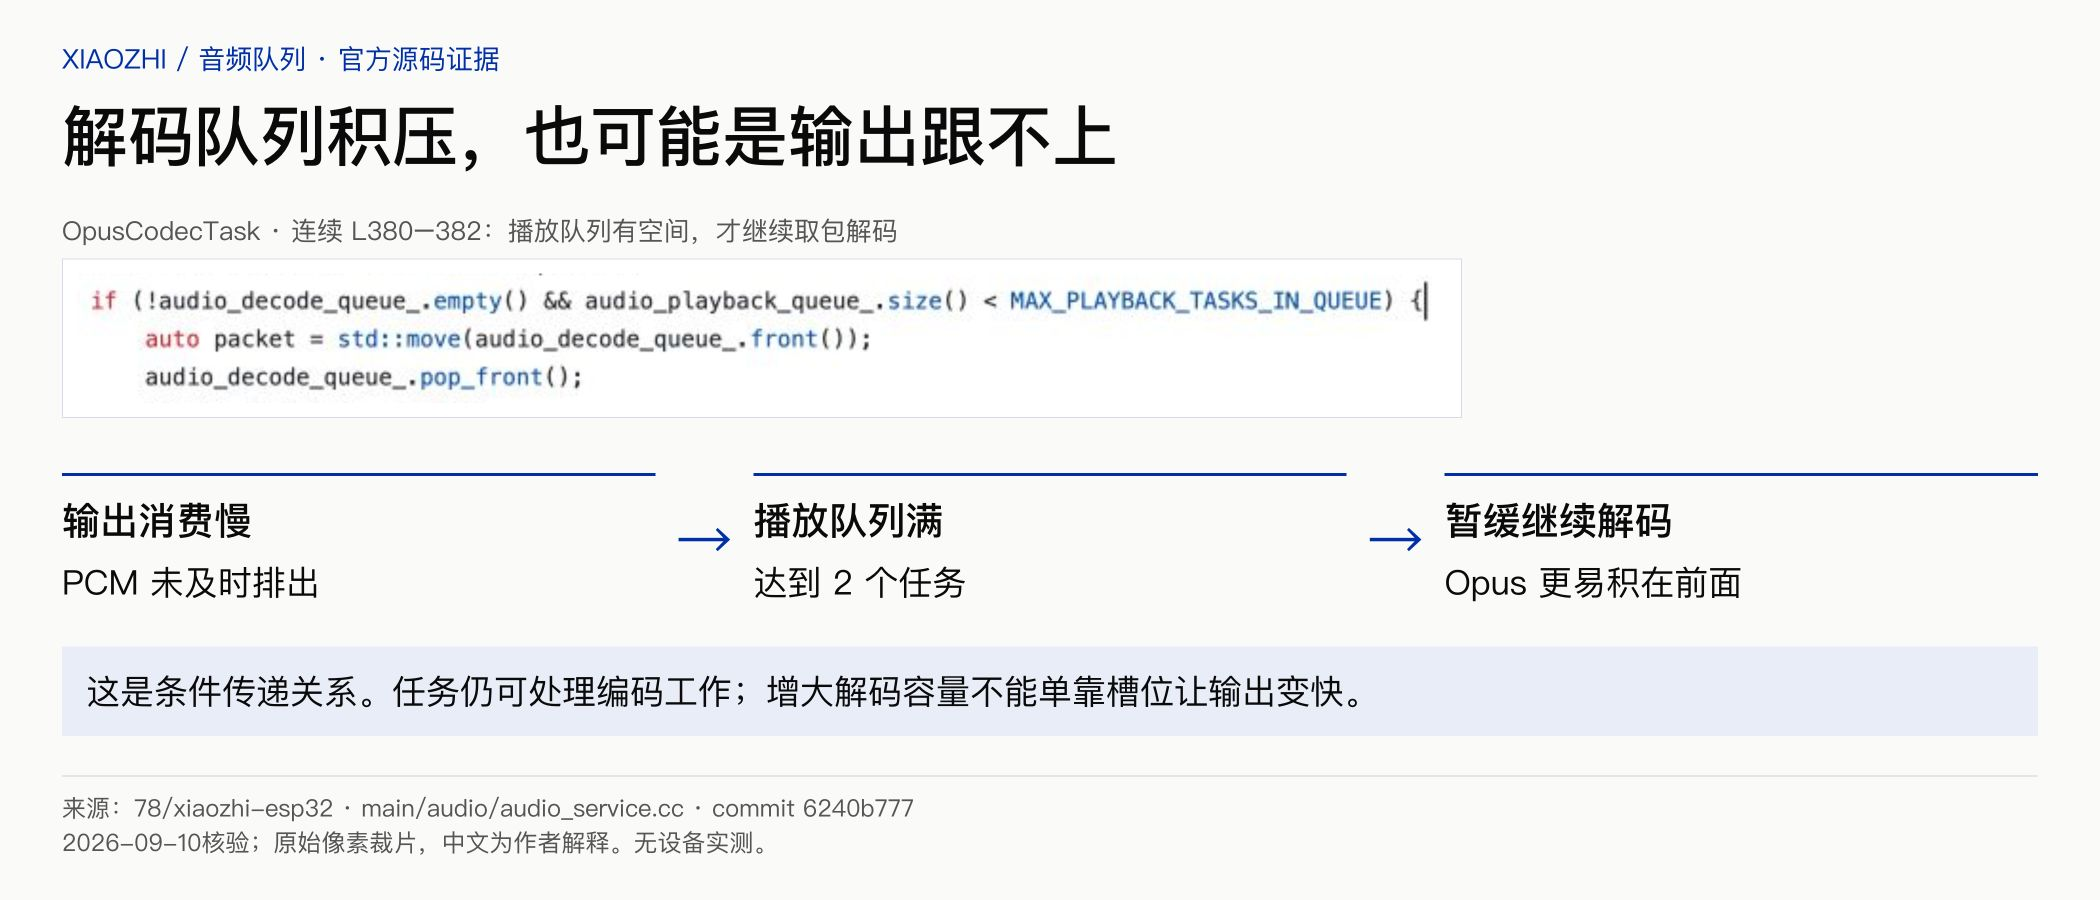
再向下看,Opus 解码任务只有在播放队列少于 2 个任务时,才会从解码队列继续取包。若输出跟不上,PCM 播放队列占满,解码便暂缓取包,压缩包更容易积在前面的解码队列。当前任务仍可能处理待编码工作,不能把“暂缓解码”说成整个音频任务停止。编解码任务与输出任务
这条传递关系对排障很有用:解码队列长,并不自动说明解码器太慢。也可能是后面的输出消费慢,播放队列先满,才限制了解码继续前进。扩大解码队列能延后拒收新包,却不能单凭容量变化提高输出的处理速度。
“20 个包”不能直接写成“延迟 1.2 秒”
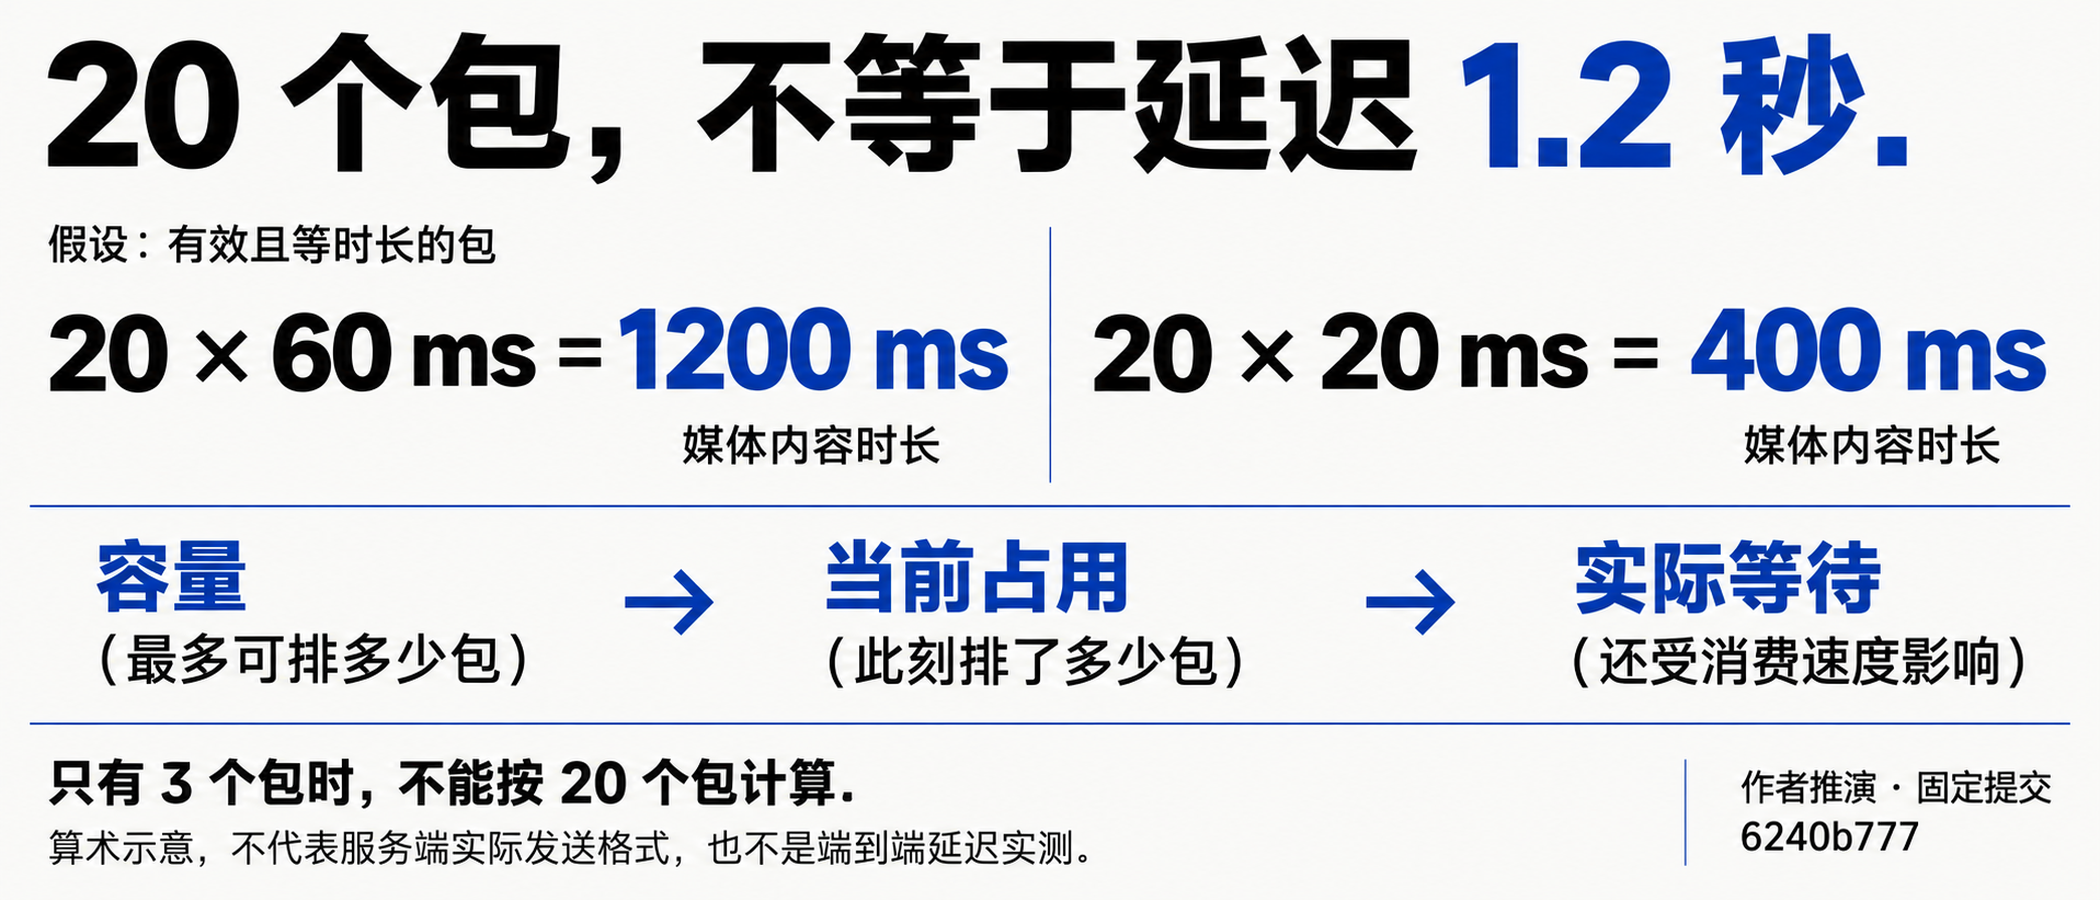
1200 / OPUS_FRAME_DURATION_MS 计算出的实际限制是包数。运行时,SetDecodeSampleRate(packet->sample_rate, packet->frame_duration) 又会依据来包的采样率和时长配置解码器。上行默认 60 ms,不等于所有下行包都必须按 60 ms 解读。解码配置切换
假设这些下行包格式正确、都代表相同的音频时长,那么 20 个 60 ms 包对应 1200 ms 的媒体内容,20 个 20 ms 包对应 400 ms。这只是对有效音频内容时长的计算,不证明当前服务端会发送其中任意一种格式,也不证明设备能够正确处理某个未核验的服务端组合。
还有一个更容易漏掉的区别:容量不是当前占用。即使包时长确实是 60 ms,队列只有 3 个包时,也不能按 20 个包估计已经积累的内容。
若要估计下行等待中的媒体量,可以把解码队列内各包的有效时长相加,再把播放队列里 PCM 的采样数按对应采样率与声道数换算为时长。解码中和输出中的任务要单列,避免它们已从队列取走后,在统计里凭空消失。即使这些项都记录了,它们仍不包含服务端生成、网络等待和底层硬件缓冲,不能直接当作端到端延迟。
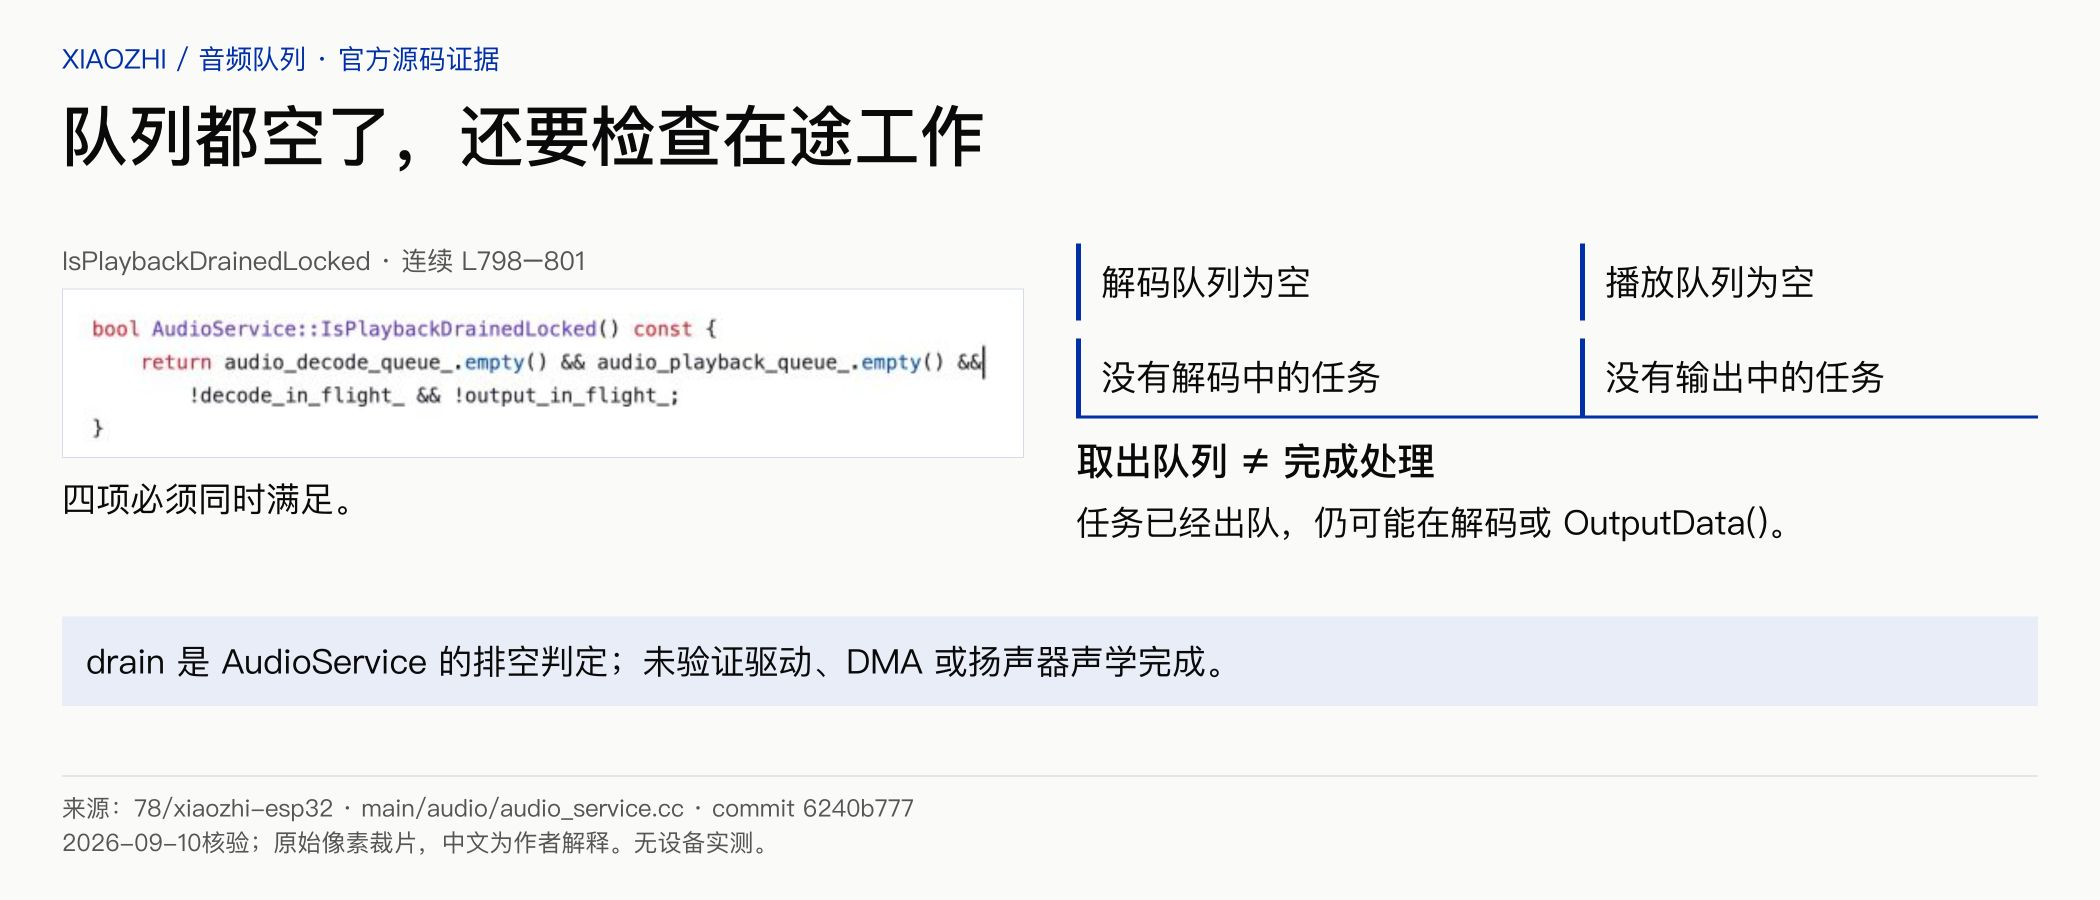
当前实现也没有用“两个队列都空了”简单判断播放处理结束。IsPlaybackDrainedLocked() 还要求 decode_in_flight_、output_in_flight_ 均为假。输出任务会先取走 PCM 任务,把输出中标志置为真,执行 OutputData(),之后再清除标志。播放排空判定
这解释了为什么队列长度可以已经为零,处理却仍未结束。这里的排空是 AudioService 对队列与在途工作的判定;本文没有继续验证不同开发板的输出驱动、DMA 或扬声器声学行为,所以不把回调当作“最后一个声音已经离开扬声器”的证明。
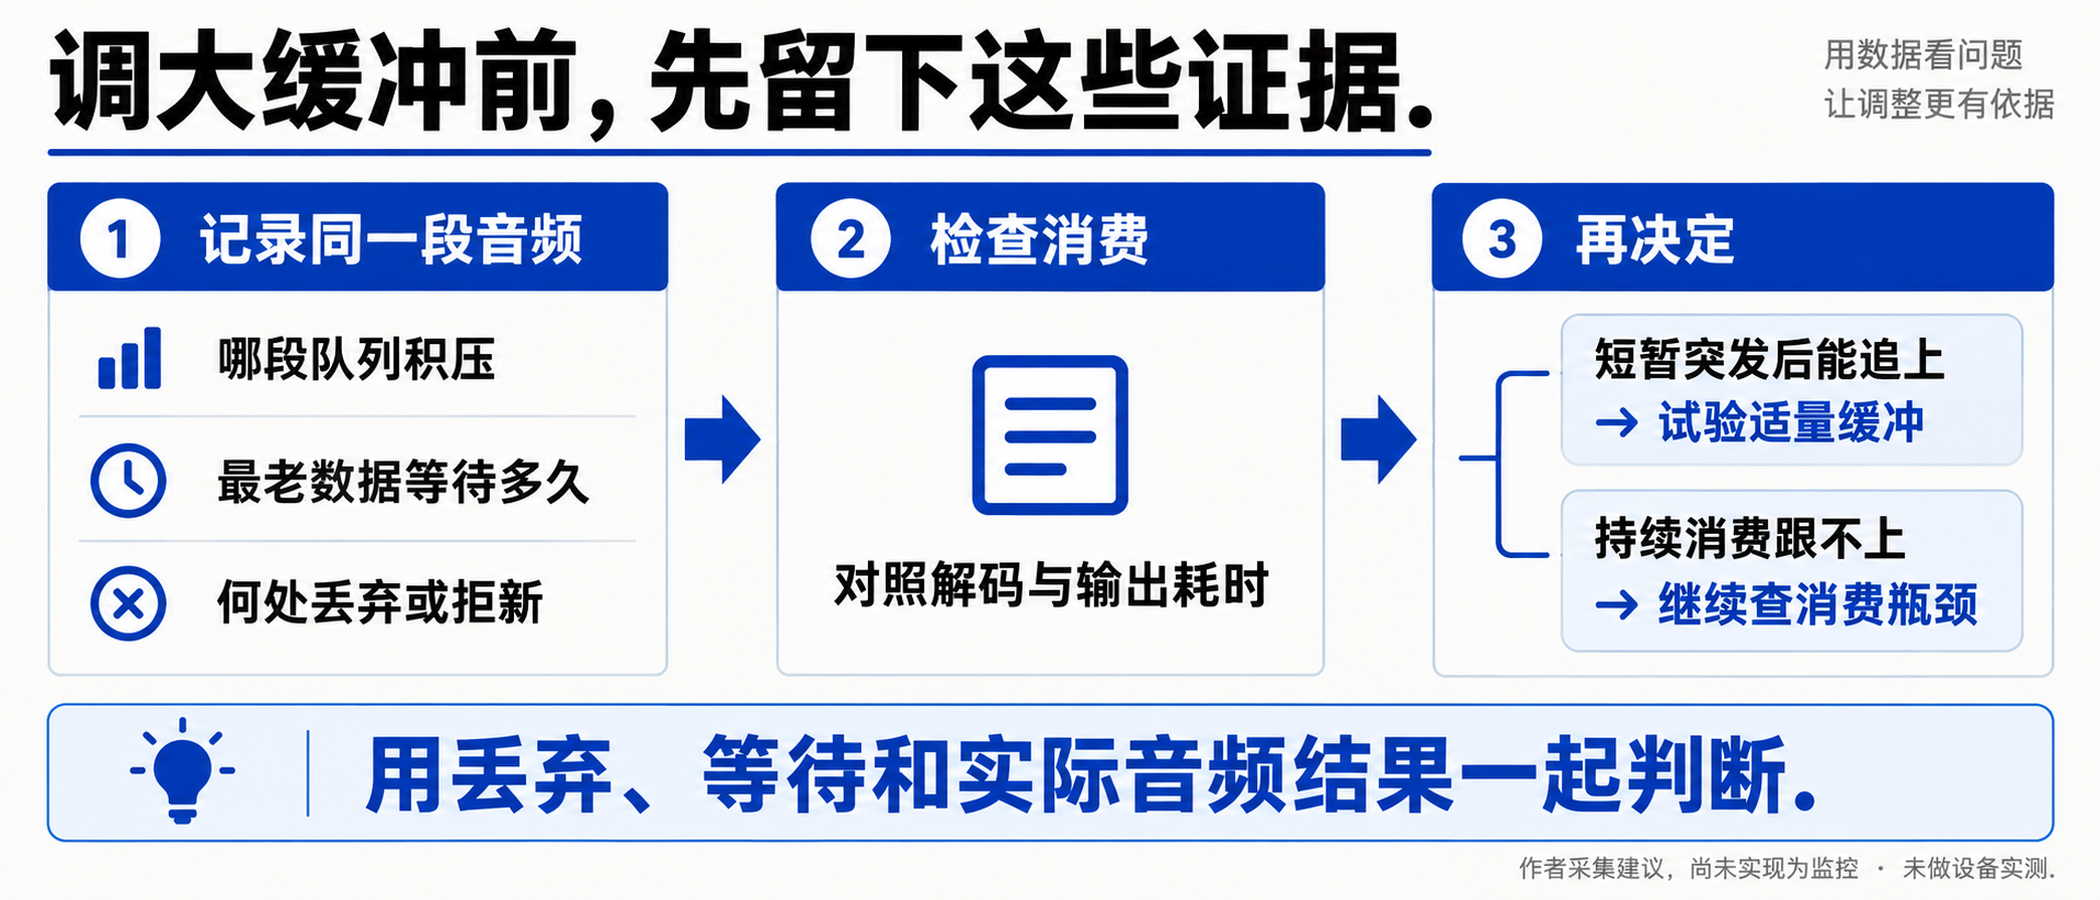
改缓冲前,记录同一段音频怎样积起来
面对断续或响应滞后,先沿同一次交换记录队列变化,比直接提高所有容量更能定位问题。下面是根据上述源码整理的采集建议,尚未实现为埋点,也不是已有监控面板。
| 位置 | 建议留下的证据 | 用来区分的问题 |
|---|---|---|
| PCM 编码队列 | 当前深度、最老任务等待时间、encode_drop_count | 输入是否持续超过编码处理能力 |
| Opus 发送队列 | 深度、包时长、最老包等待时间、该分支的丢旧次数 | 已编码的数据是否积在发送前;现有编码计数不覆盖这里 |
| Opus 解码入口 | 当前包数、有效包时长总量、入队失败次数及原因 | 是容量满拒收,还是停止、代次变化等原因拒收 |
| PCM 播放队列及在途任务 | PCM 对应时长、队列深度、解码和输出处理耗时 | 解码积压是否由后端输出消费速度限制 |
队列等待时间可以在同一设备的单调时钟下测量;媒体时长则来自音频内容,两者不要混用。一个包在队列里等待 100 ms,不意味着它包含 100 ms 的声音。打点还应避免把高频、耗时日志放进队列锁内,否则测量本身可能影响处理。
只有观察到短暂突发、随后消费者能追上,才有依据试验适量增加缓冲。若生产速度长期高于消费速度,增加上限只会推迟再次装满,需要继续查发送、解码或输出的消费瓶颈。比较修改前后时,在相同负载和网络条件下,同时看丢弃、等待时间和实际音频结果,不能只用“满队列次数变少”宣布改善。
小智这里最值得借鉴的不是 2、20、40 这些数字,而是数字背后的不同选择:上行允许用旧内容换输入持续前进,下行默认保留已排队内容而拒收新包,输出端又会反过来限制解码。把断续发生的位置和这些分支对应起来,才能判断该增加容量、提高消费速度,还是接受某种明确的数据丢弃代价。