用户发来一句话,页面过了好一会儿才开始显示;换一个问题,文字马上出现,却一小段一小段地往外挤。这两种“慢”,需要查的地方并不相同。
第一种先看首段内容出现之前发生了什么,第二种要看开始生成之后为什么跟不上。沿着一条请求走一遍,比只盯着 GPU 利用率更容易找到方向。
请求到了,并不代表 GPU 已经开始算
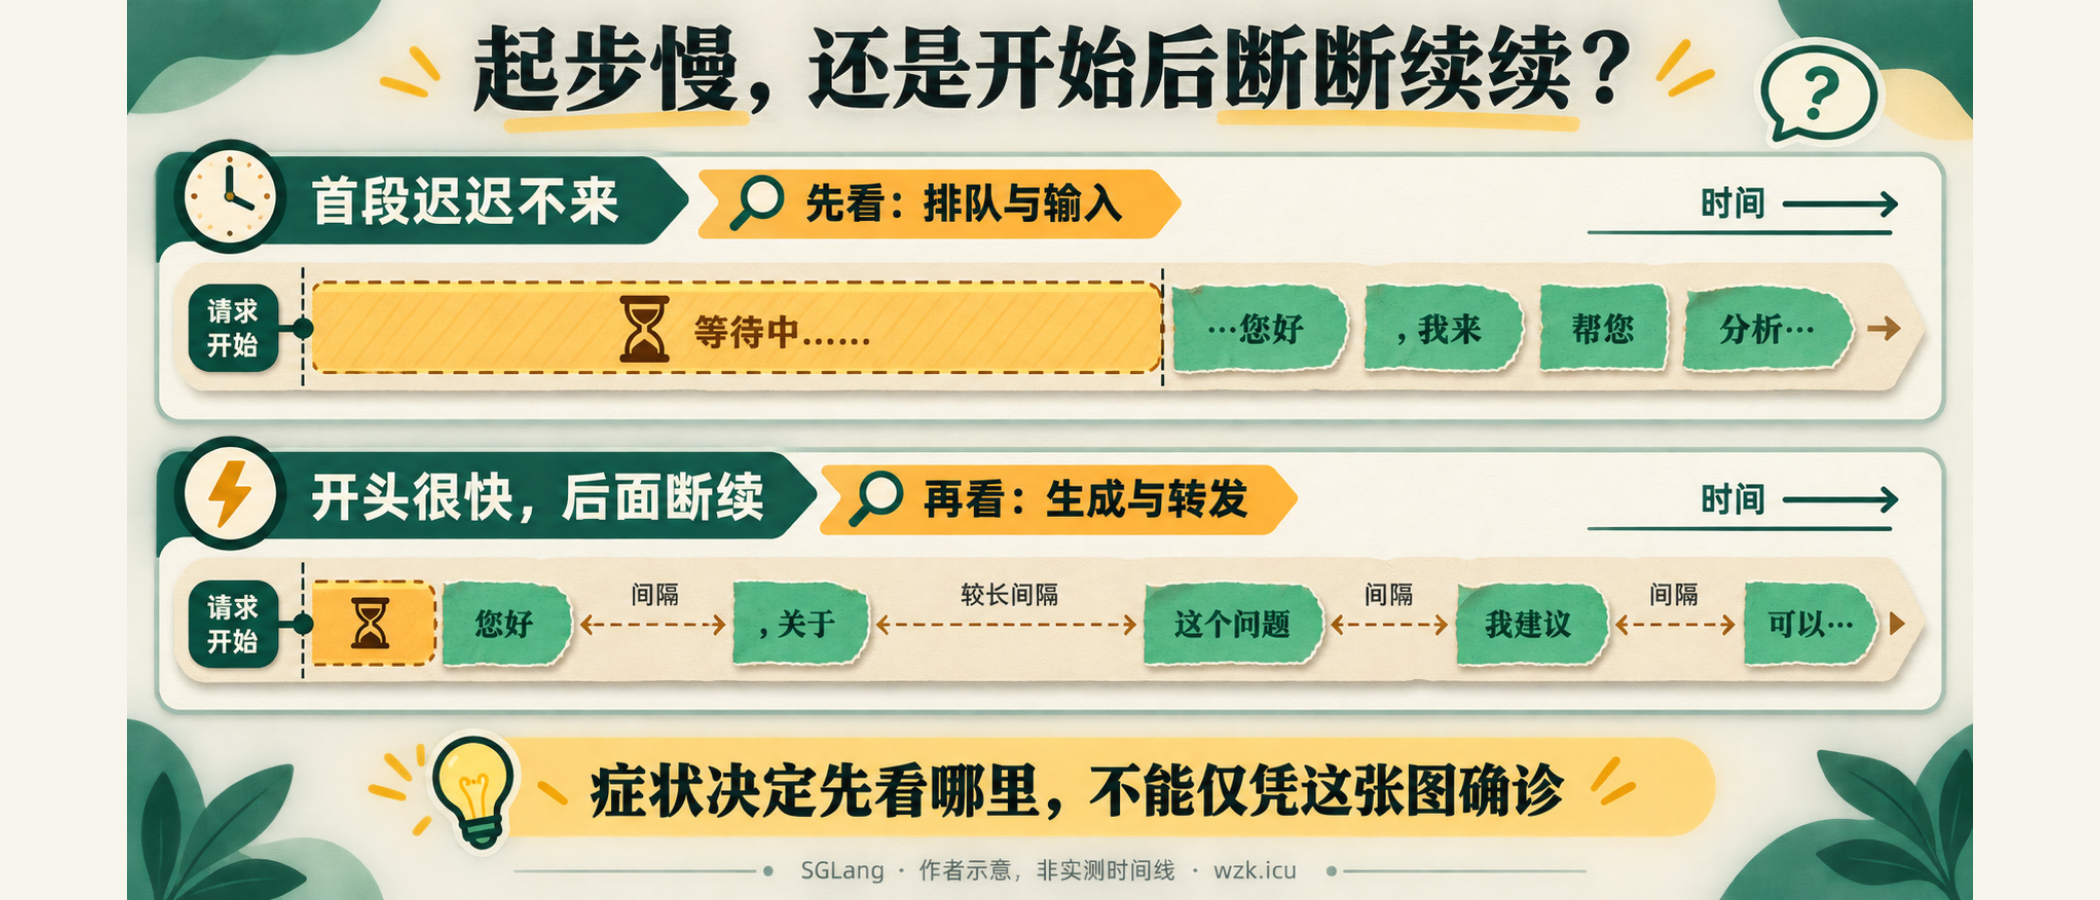
应用把消息发送给 SGLang 后,消息还需要按模板组织、转换成 token,并进入执行调度。遇到已有任务占用资源,新请求会等待。
SGLang 的调度器源码可以用来追踪选取批次、执行批次和处理结果的过程。这里的批次,是一次安排在一起计算的一组请求;它不是“某位用户的一整段回答”。具体实现会随版本和运行模式改变,不能把一张串行流程图当作所有部署的进程拓扑。
这一步对排障的意义很直接:请求已经被服务接收,仍可能长时间待在队列里。应用只记录“请求发送”和“最终返回”,会把这段等待全算进“模型推理慢”。
首 token 之前,长输入要先被处理
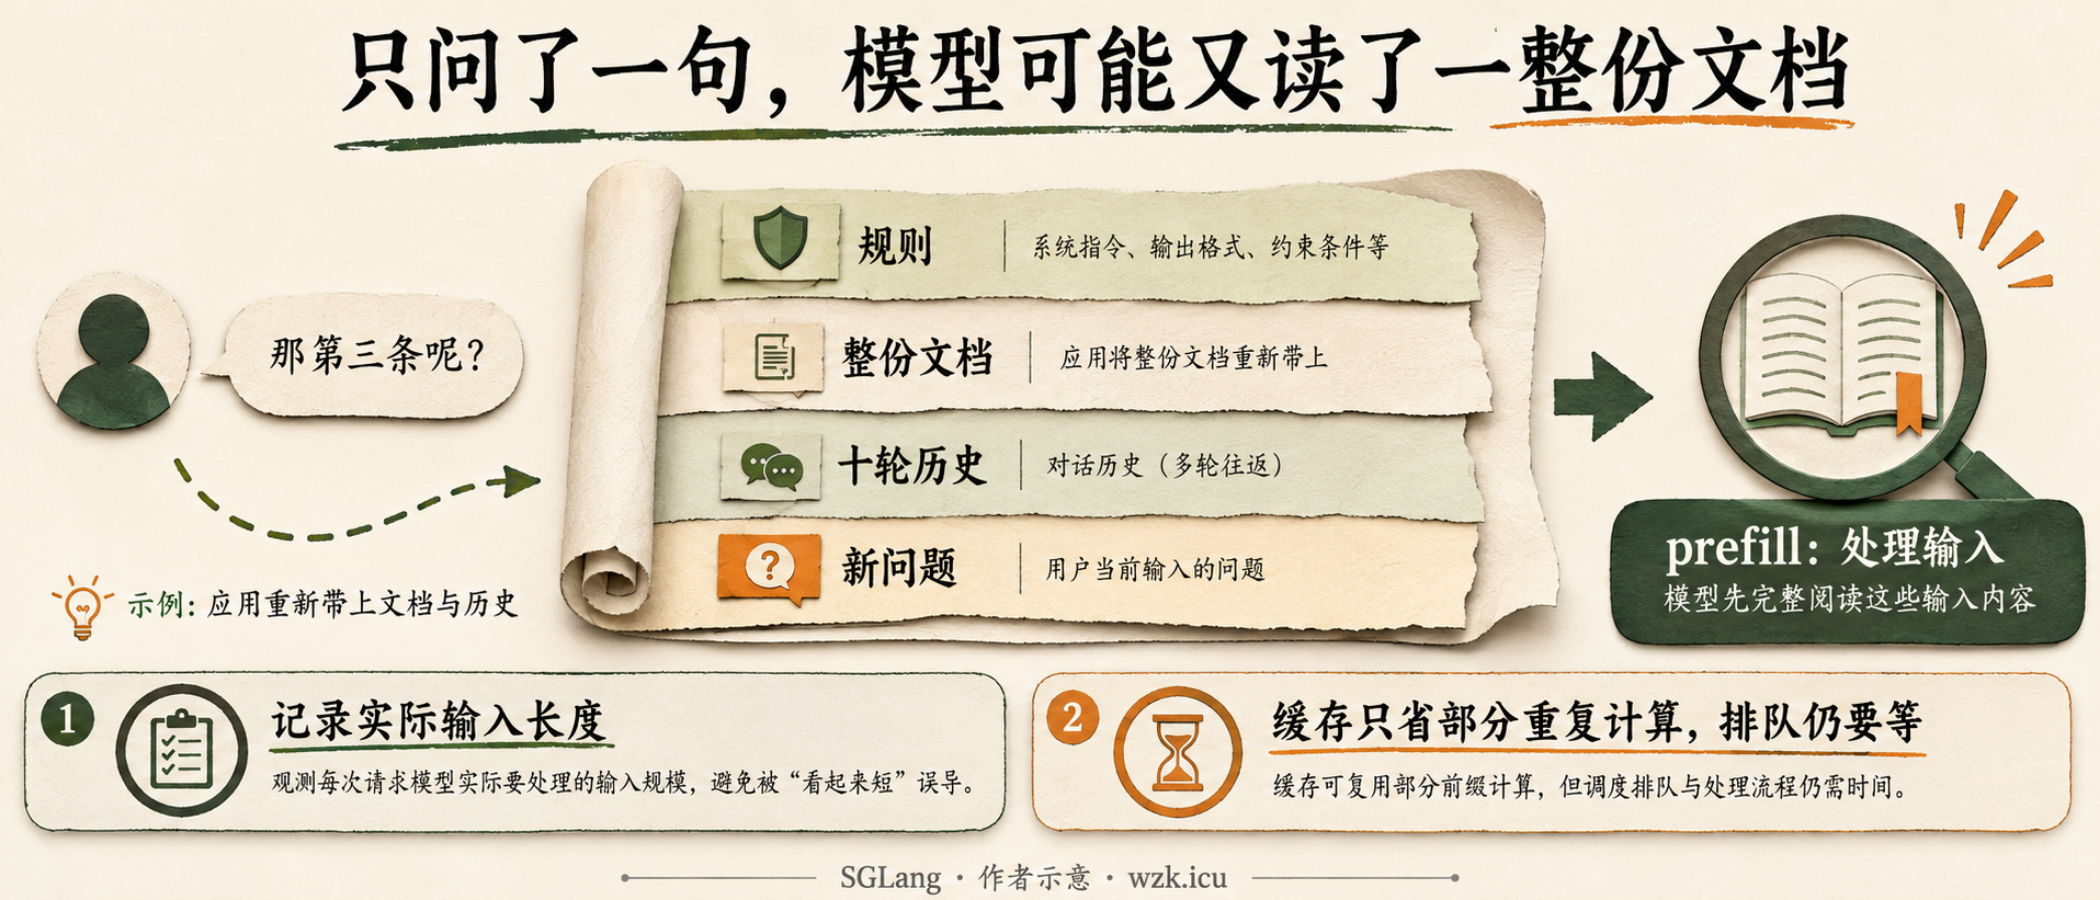
模型要理解输入中的规则、文档和历史。处理输入的阶段通常称为 prefill。如果可复用前缀仍在缓存中,一部分重复计算可以省去;剩余输入仍需处理。
一位用户只问了一句“那第三条呢”,不等于这次输入很短。应用可能把整份文档和十轮历史又发了过来。排查时应该保存模型实际接收的输入长度,而不仅是聊天框里新增的那句话。
如果前缀命中增加,但首 token 时间没改善,还要看排队和其他开销。缓存只影响部分计算,不会让已经拥堵的队列自动缩短。
第一段文字出来以后,任务还没有结束
接下来是生成新内容的 decode。常见自回归生成要依据已有上下文逐步继续;输出越长,后续计算也越多。
多个请求的生成过程可以一起被调度,因此某条请求的表现会受同一服务中其他负载影响。“我单独测试很快,上线就慢”需要检查并发请求的输入长度、输出长度和到达节奏。
如果使用结构化输出,还要考虑约束解码;如果启用了特殊推理模式或其他优化,输出处理也可能不同。先保留实际启动参数,才知道你在排查哪条路径。
服务有 token,页面未必立即有文字
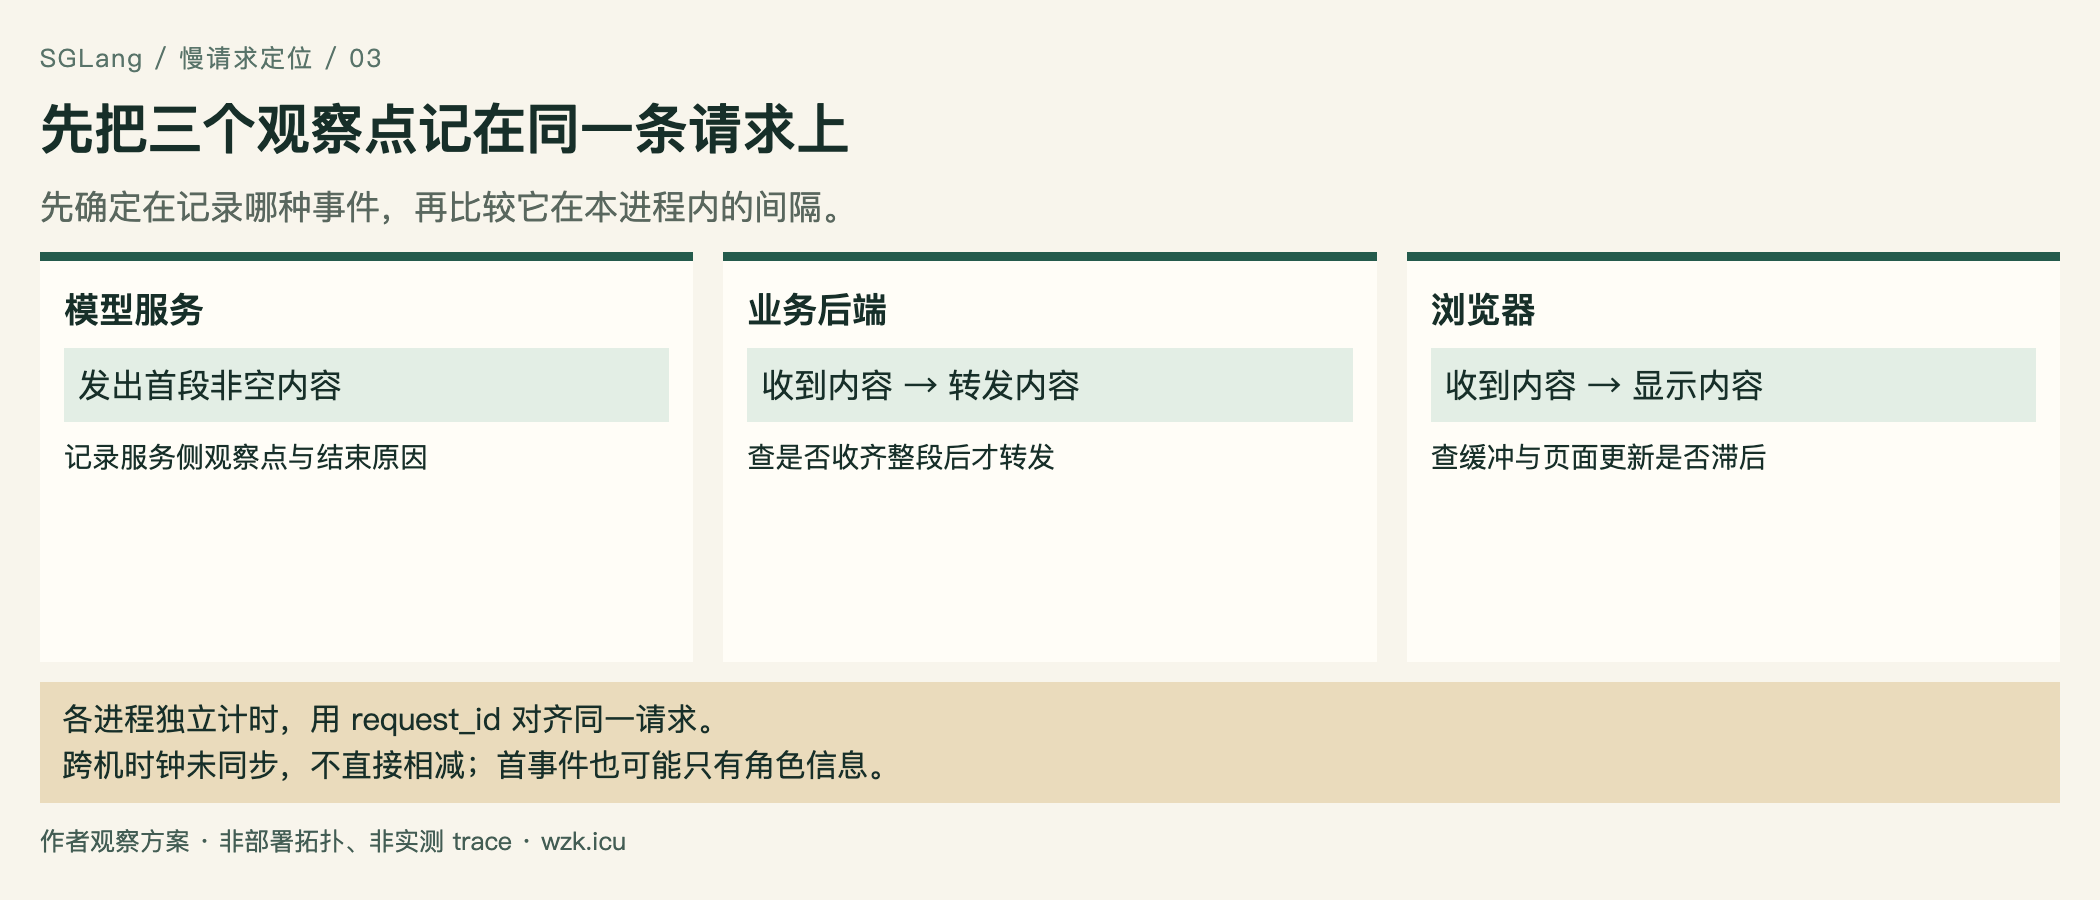
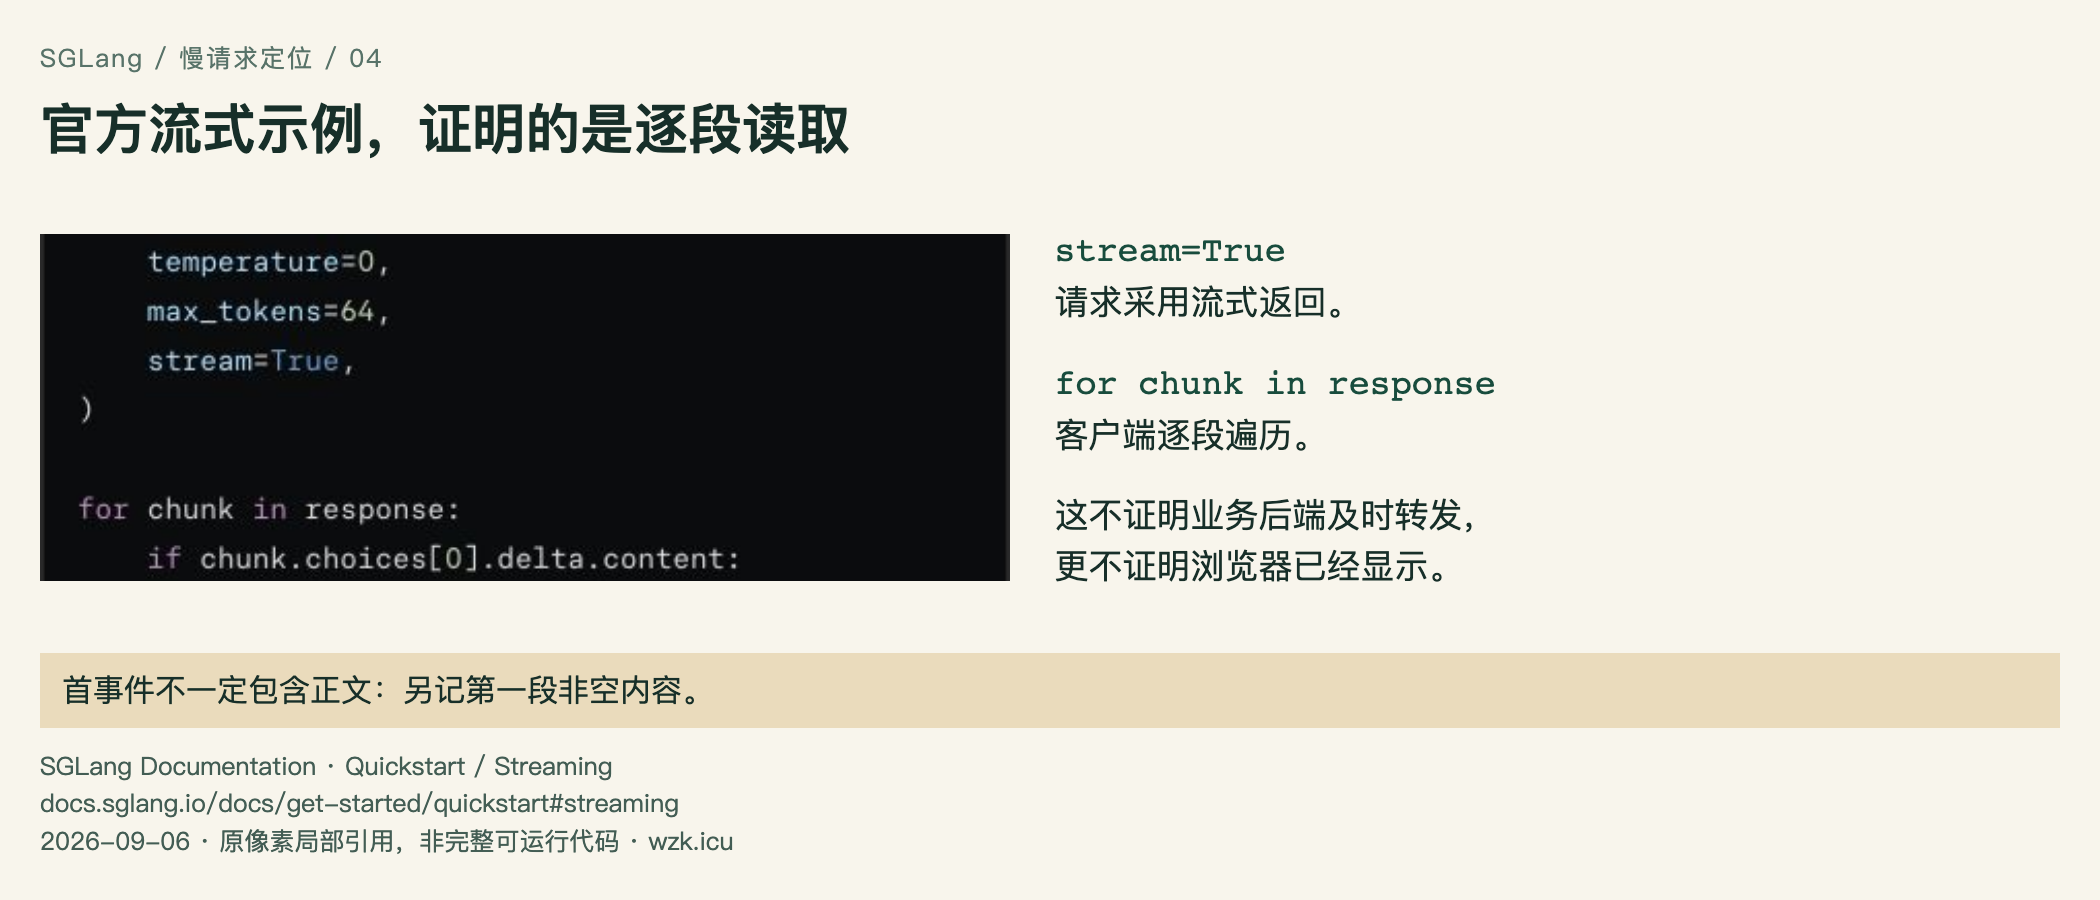
生成出的 token 需要转成文字并发送出去。客户端、业务后端和反向代理可能继续缓冲。一个流式响应里的首个事件,也可能只是角色或元信息,而不是用户看得见的内容。
因此,要区分“收到第一个事件”和“收到第一段非空内容”。当服务指标很好、页面仍然停顿时,可以在同一请求上分别记录:服务发出内容、业务后端收到内容、浏览器显示内容的时刻。
跨机器时钟没有同步,直接相减会制造假延迟。优先记录同一进程内的时间间隔,再用请求 ID 串起不同观察点。不要把浏览器总耗时减去某个服务平均值,就当成网络耗时。
用一组症状决定下一步看哪条记录
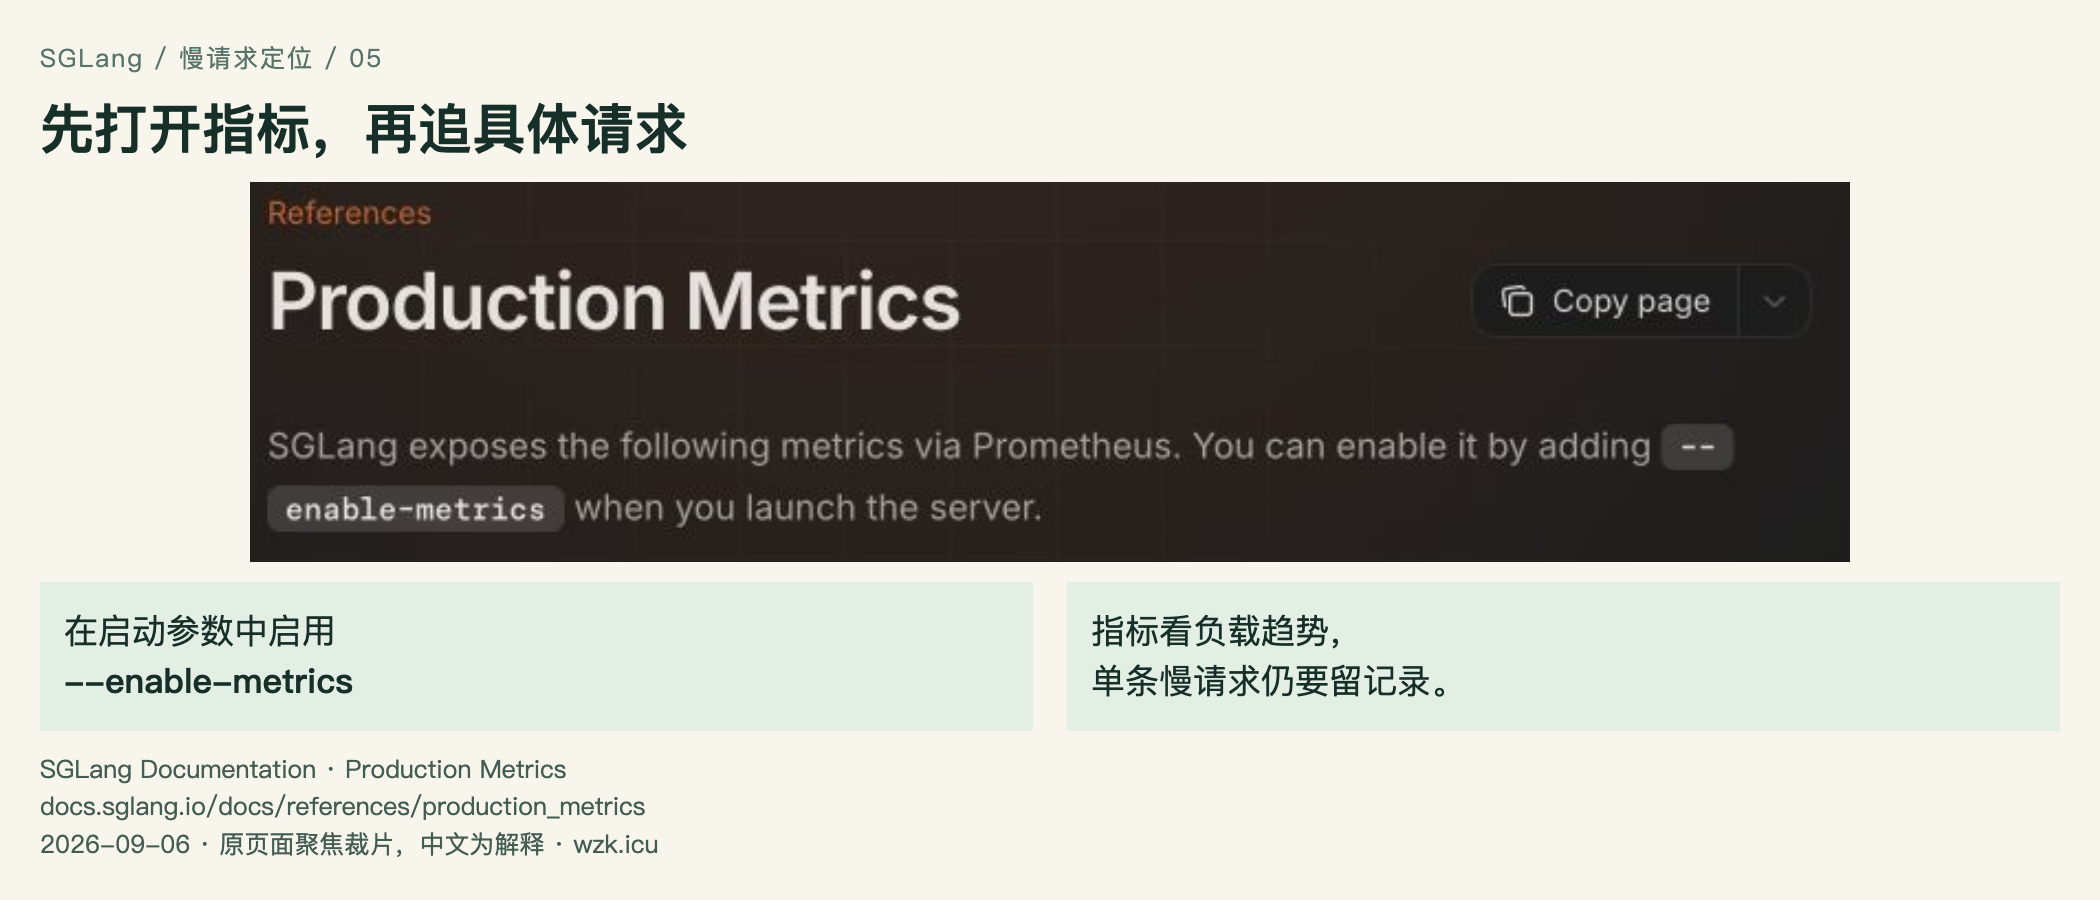
官方指标页列出了首 token 时间、等待请求数、运行中请求数、缓存命中等指标。启动服务时可以启用 --enable-metrics。这些指标适合观察负载变化,但聚合指标不能单独还原一次请求。
下面这张表是排查顺序,不是已确认的故障结论:
| 你看到的现象 | 接下来核对什么 |
|---|---|
| 首段迟迟不来,等待请求数持续上升 | 请求到达速度、并发上限、正在运行的长任务 |
| 只有长文问题起步慢 | 实际输入长度、可复用前缀和 prefill 情况 |
| 起步正常,后续文字变慢 | 输出长度、同时运行的任务、生成阶段资源压力 |
| 服务已发出文字,页面仍没显示 | 后端转发、代理缓冲、浏览器处理 |
| 请求偶发消失或提前结束 | 错误、超时、取消、结束原因与客户端重试 |
不要看到一个指标上涨就马上改配置。比如等待请求数高,可能是入口流量增加,也可能是每条请求开始生成更长的答案。两种情况下都加并发,未必能解决问题。
留下能够重现的请求,再改一个变量
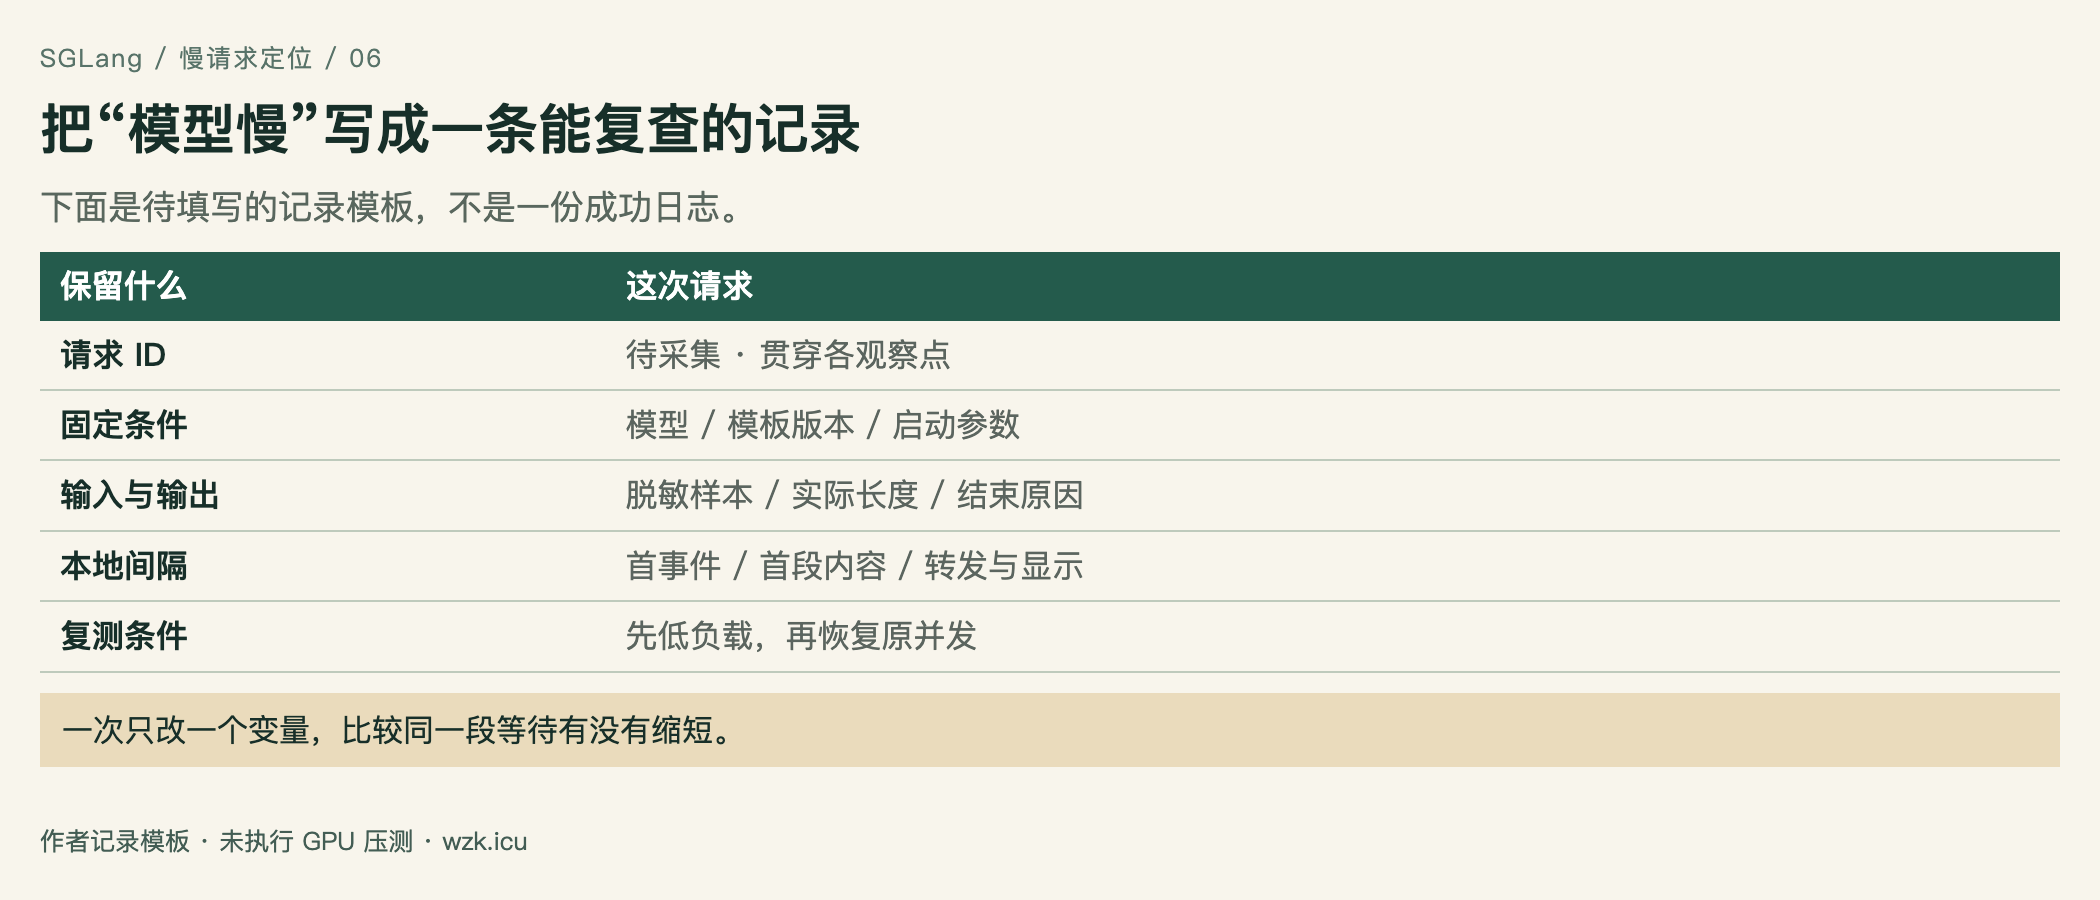
从慢请求中选一个已脱敏样本,固定模型、模板、输入和生成设置,记录它在低负载下的表现,再逐步恢复当时的并发条件。本文没有执行模型压测,这里给的是定位办法。
你需要的结果不是“模型慢”四个字,而是更具体的描述,例如:“长输入在首 token 之前耗时增加”“队列增长后短请求也被拖慢”,或者“服务已经流式返回,代理还在攒数据”。
描述能落到具体阶段,改动就能落到相应位置。下一次复测时,也知道该检查哪段等待有没有真的缩短。