一、同一个 90%,可能隐藏完全不同的机器人
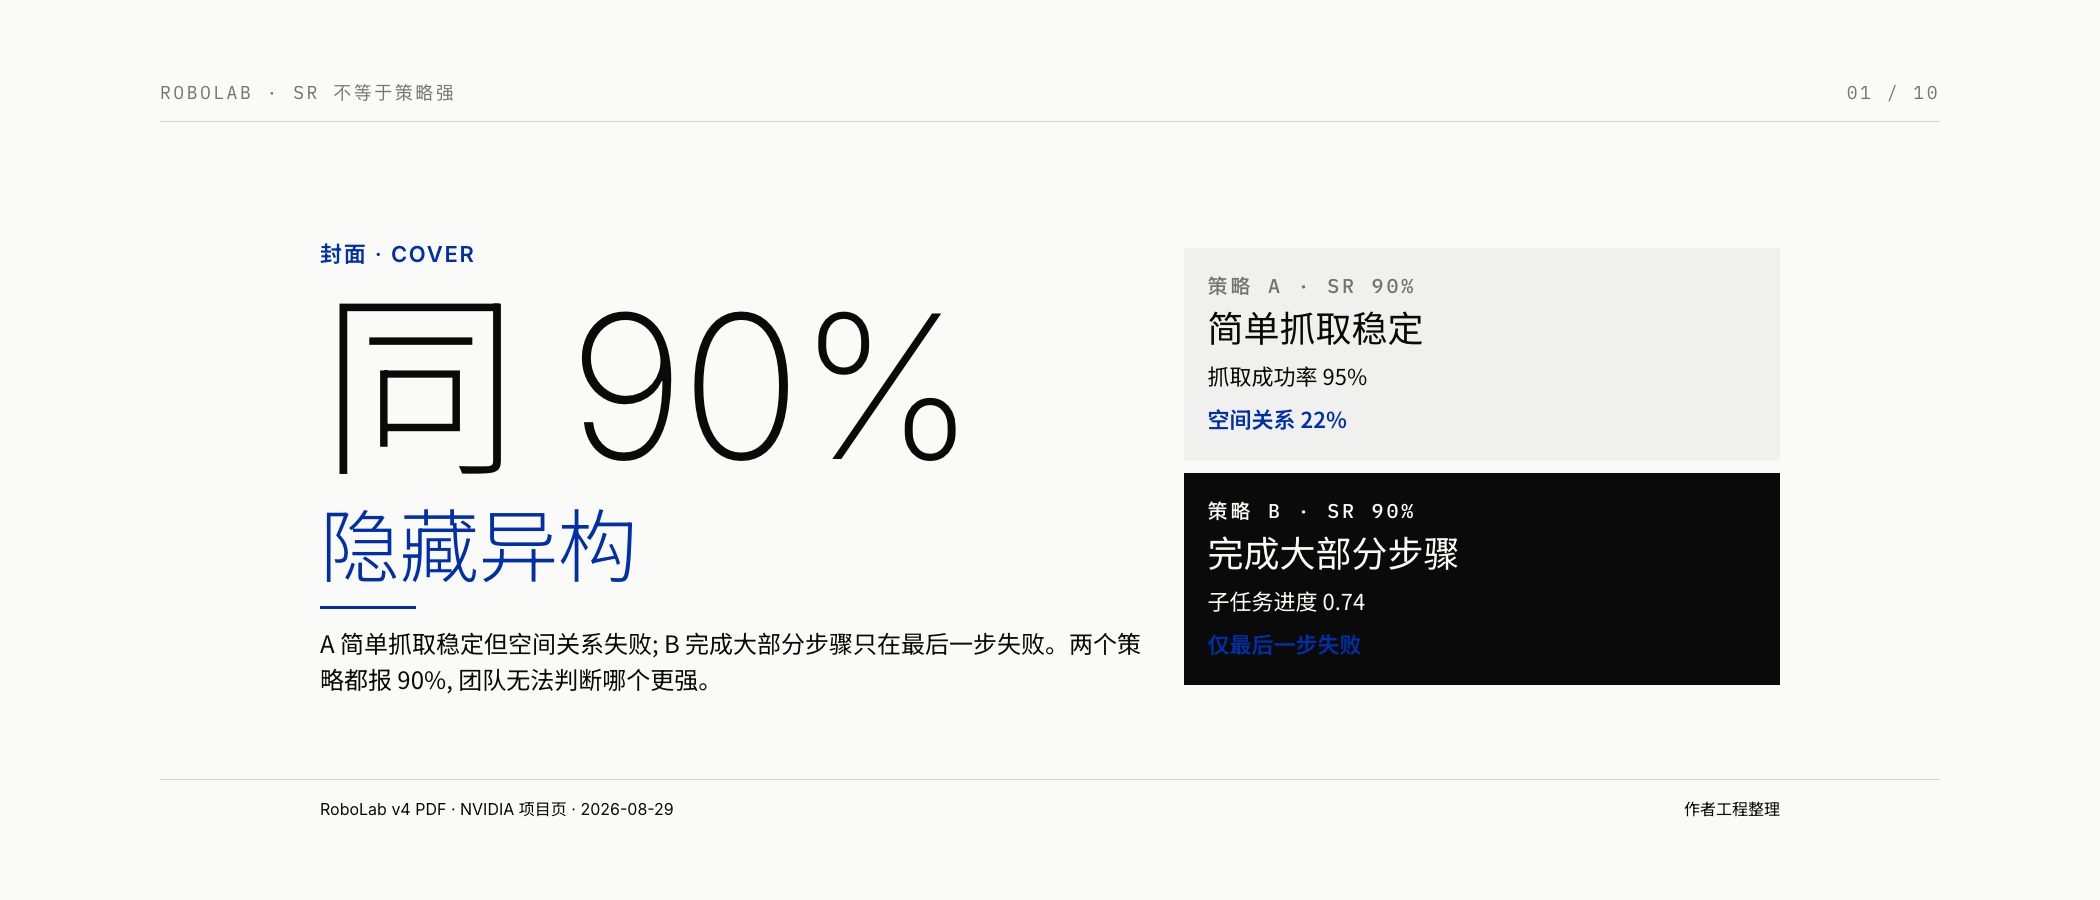
两个机器人策略 A 和 B 在论文或排行榜上都报告 90% 完整成功率。A 在简单抓取上稳定,但无法处理空间关系;B 经常完成大部分步骤,只在最后放置阶段失败。把它们压成同一个数字时,能力结构、失败位置、轨迹质量与统计不确定性会同时丢失。
NVIDIA 的 RoboLab 把任务型机器人评测放入高保真模拟环境(Isaac Lab),以 120 个任务、可控视觉扰动、语言变体、自动成功检测和能力标签分析通用策略。官方项目页和 v4 论文(Robotics: Science and Systems, RSS 2026, arXiv 2604.09860v4)的价值不在于再多一个排行榜,而在于把”成功率”拆回可以诊断的任务组成。下面的讨论基于 2026-08-29 实际抓取的来源。
二、RoboLab 把 120 个任务拆回可诊断结构
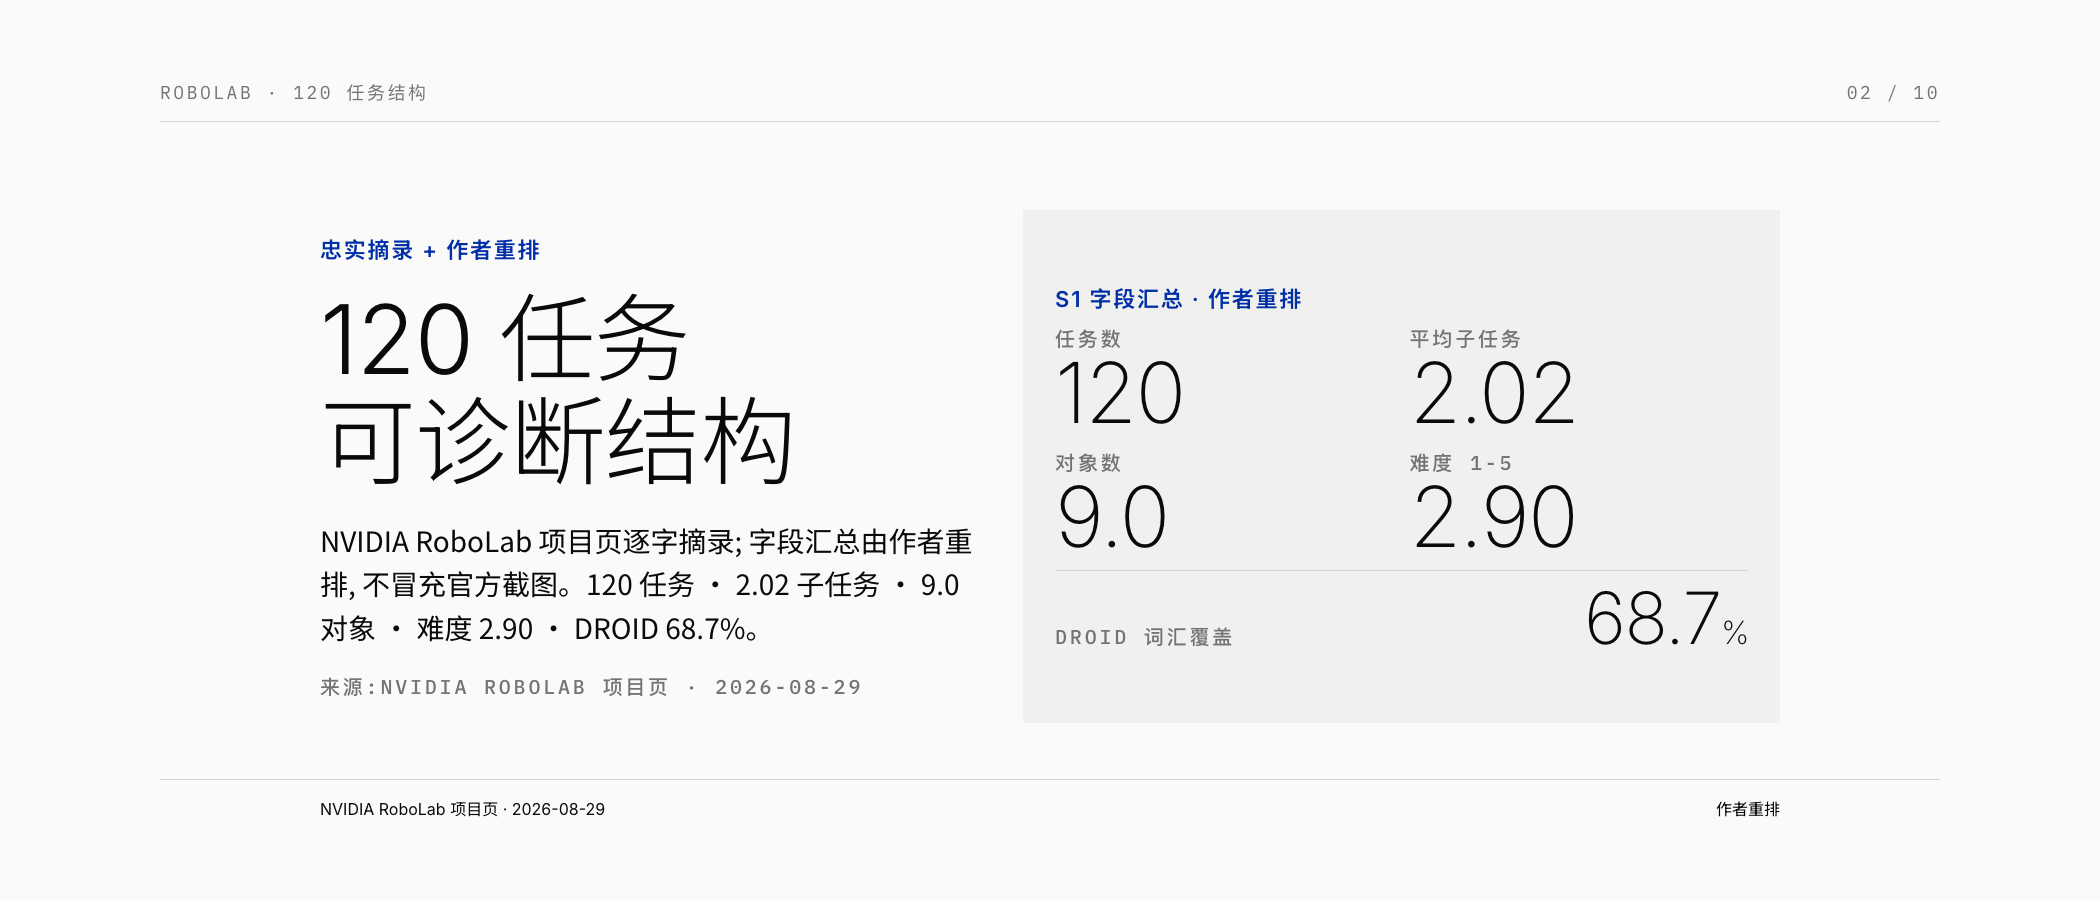
当前 NVIDIA 官方项目页(研究截止 2026-08-29)公开 120 个任务(RoboLab-120),按能力轴切分;任务平均 2.02 个子任务、9.0 个对象、平均难度 2.90,Benchmark 对象中 68.7% 出现在 DROID 训练词汇中。这 68.7% 并不直接证明训练数据完全不重叠,但让对象覆盖差异可见。来源:S1 NVIDIA 官方项目页文本摘录,已落盘到 source-assets/S1-nvidia-project-page/。
固定场景、摄像机和物体布局的长期稳定,本身就可能让策略利用训练重叠、视觉捷径或场景记忆。RoboLab 当前项目页把”lighting, camera pose, backgrounds, textures, shadows”列为受控扰动维度(来源:S1 NVIDIA 官方项目页文本摘录:Perturbation categories: lighting, camera pose, backgrounds, textures, shadows),正是为了让研究者能在同一任务定义下问:“面对观察分布变化,策略还能否完成?“因此 68.7% 是 Benchmark 对象在 DROID 训练词汇中的覆盖事实,不能单独证明 episode、视觉场景或任务轨迹存在重叠;把”数据泄漏 / 视觉捷径 / 场景记忆”作为评测风险与待验证假设是合理的,但不应写成 RoboLab 已实证的模型缺陷。
三、能力分类:当前项目页与 v4 论文存在差异
RoboLab 把任务能力拆为三类轴。下面并列展示两个当前一手来源在 Relational 子类上的差异,由读者自行核对:
| 能力族 | S1 当前项目页 (2026-08-29) | S2 v4 论文 III-B (2026-08-14) + S4 排行榜 |
|---|---|---|
| Visual | color / semantics / size | color / semantics / size |
| Relational | temporal / numerical / spatial | conjunction / counting / spatial |
| Procedural | affordances / reorientation | affordance / reorientation (v4 Table IV 简写) |
来源:S1 项目页文本摘录;S2 v4 PDF Page 1 (abstract) + Page 12 (Table IV: “Relational 42 33.8% 0.47 0.20”;“conjunction 8 43.8% 0.55 0.21”;“counting 7 65.7% 0.75 0.28”;“spatial 29 21.0% 0.36 0.19”) + S4 排行榜(Relational 列同样使用 conjunction / counting / spatial 子类)。两个当前一手来源在 Relational 子类上确实不一致;本包不自行判定哪个唯一正确。
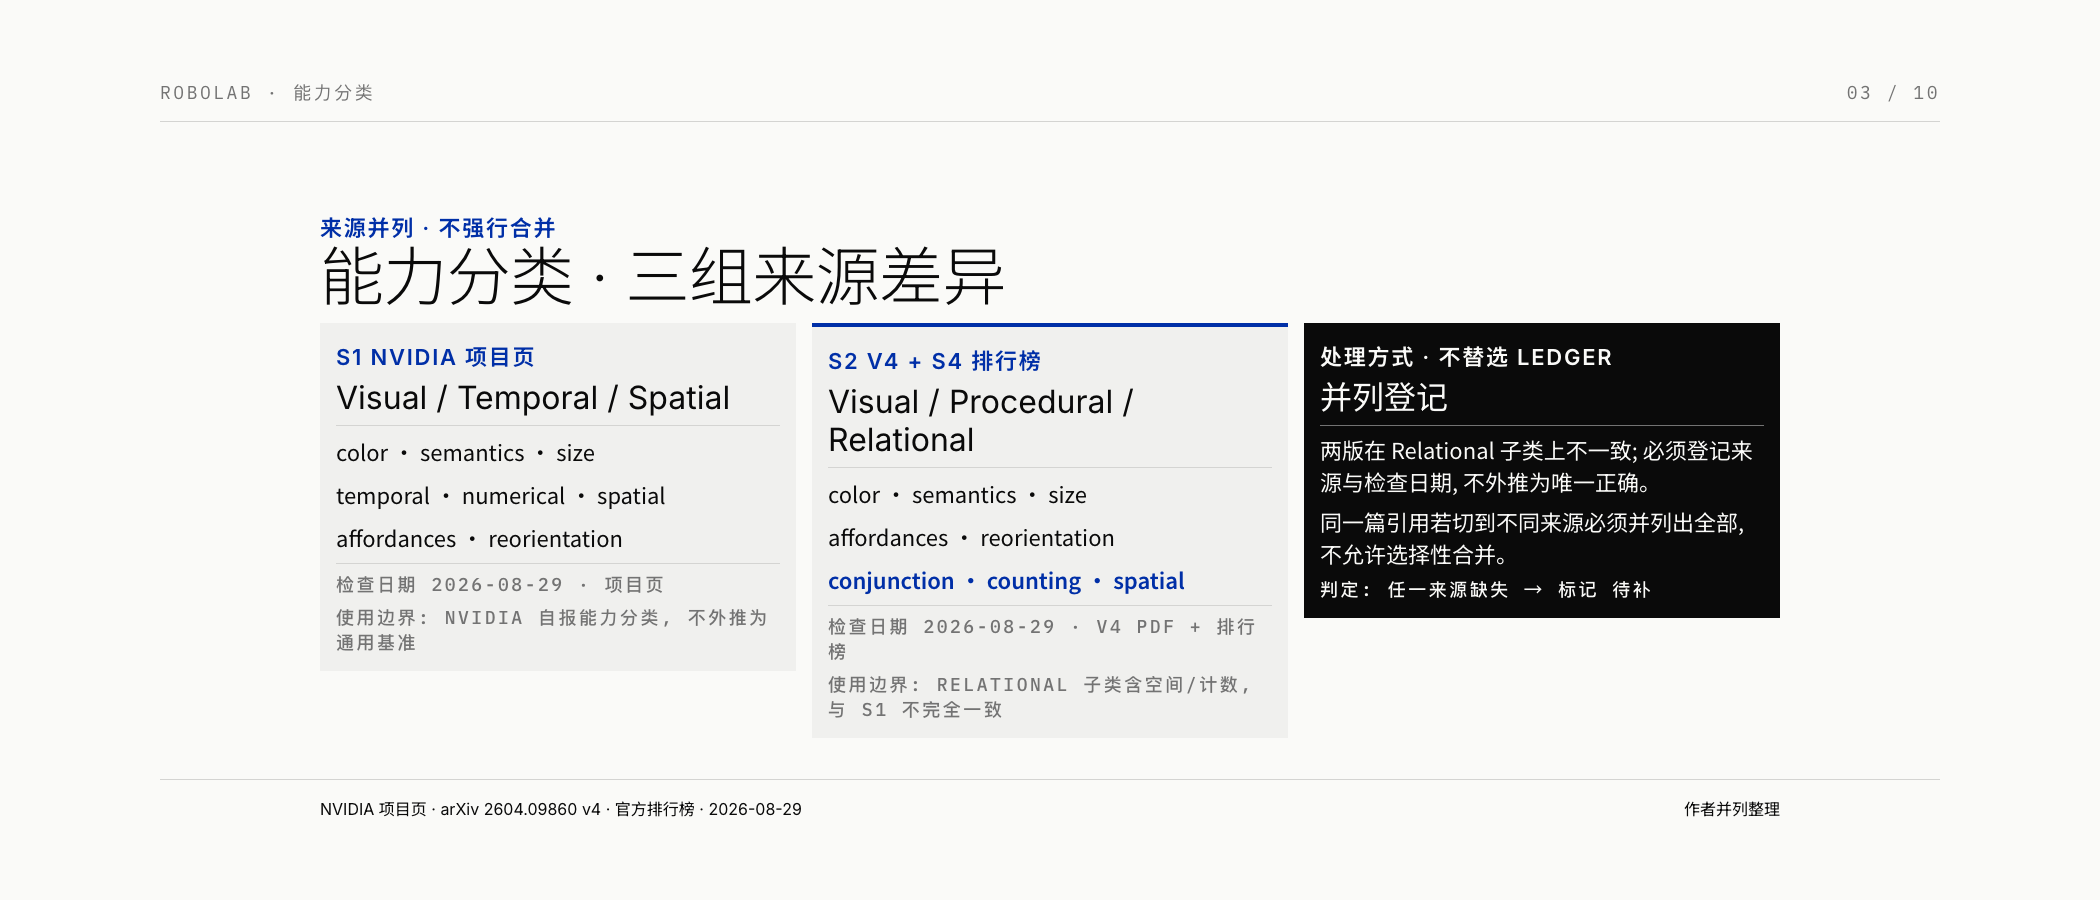
能力标签不应被当作单一分类,应按多标签切片报告,并控制任务难度与 Horizon,否则某一标签的低分可能只是因为它恰好出现在更长任务中。来源:S2 v4 论文 Page 1 (abstract 明确「120 tasks categorized into three competency axes: visual, procedural, relational, across three difficulty levels」) + S4 当前排行榜文本摘录。
四、语言鲁棒性:指令变化揭示的策略依赖
v4 论文公开了指令特异性的对照实验:在同一任务定义下,把指令从 specific 改成 default 再改成 vague 时,策略表现出现可测量的下降。S2 v4 PDF Page 7 逐字命中(来源:source-assets/S2-arxiv-v4/v4-pdf-pages-1-2-6-9-10-12-14-faithful-excerpt.txt):
“π0.5 drops from 28.0% on default to 15.3% on vague. This sensitivity reveals that current models lack robust reasoning against the task goal. A truly generalist policy should be invariant to instruction phrasing.”
同页定性判断进一步指出:“indicating brittle language-to-object binding beyond a narrow set of familiar object descriptions”。该下降不能单因果归结为”语言模型差”——它也可能来自视觉 grounding、记忆、任务规划或训练分布的共同影响;RoboLab 论文本身的措辞是”current models lack robust reasoning against the task goal”,并未把责任单独归到语言模块。S1 项目页当前公开的 default / vague / specific 任务生成说明(来源:S1 NVIDIA 官方项目页文本摘录 default/vague/specific 字段)仅覆盖前三类扰动。
一个完整的语言鲁棒性矩阵应至少覆盖以下七类职责:同义改写、上下文省略(指令省略已知上下文)、目标优先步骤不指定、矛盾指令、多语言与口语、中途修正、对对象使用描述而非名称。RoboLab 当前公开的 vague / default / specific 仅覆盖前三类中的部分场景;正式评测仍需补齐剩余四类才能形成可比较的语言鲁棒性诊断。来源:S2 v4 PDF Page 7(指令特异性 + brittle language-to-object binding 逐字);S1 项目页文本摘录(default / vague / specific 任务生成说明)。
五、完整成功 13.5% / 部分得分 0.44 / 失败子集 0.35 的精确出处
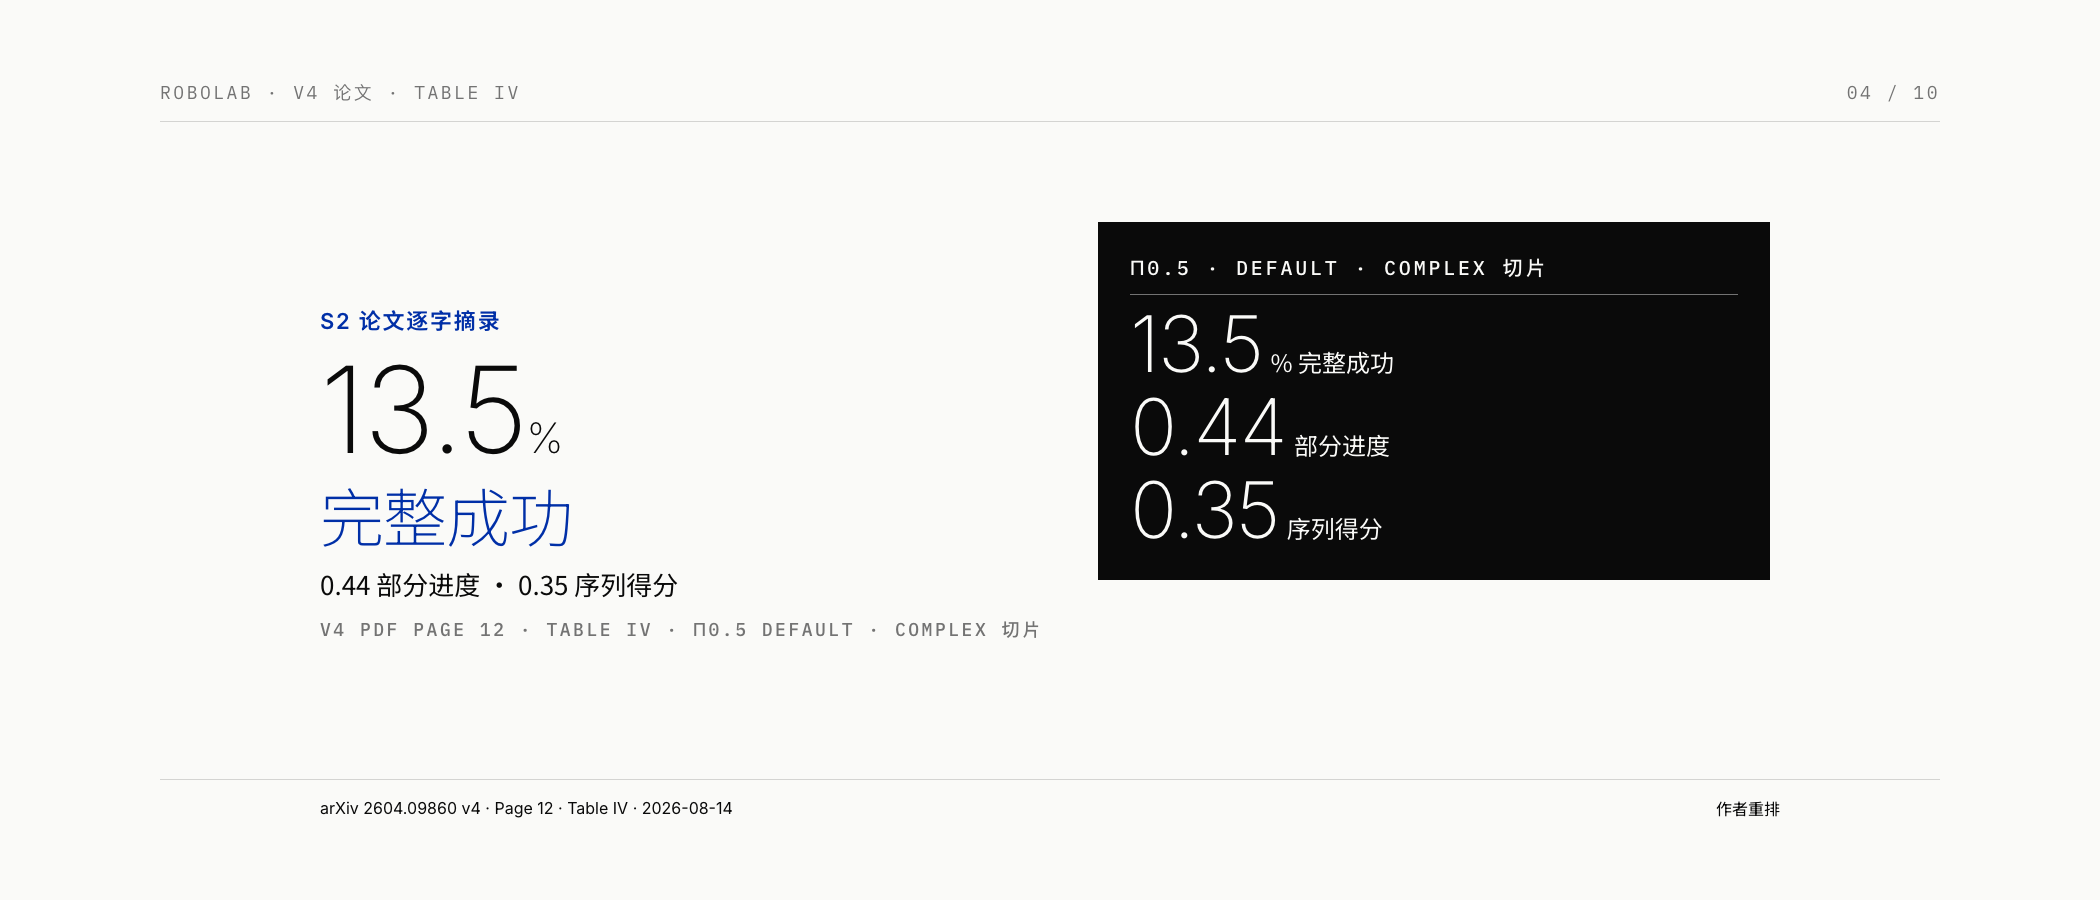
v4 论文 PDF Page 12 Table IV 给出 π0.5 在 Default variant 下 complex 切片的精确数字:
原文摘录(v4 Page 12 Table IV): “complex 17 13.5% 0.44 0.35 2.9% 0.22 0.20 0.0% 0.12 0.12 0.0% 0.09 0.09 0.0% 0.09 0.09”
| 数字 | 含义 | 含义(π0.5 complex 切片) |
|---|---|---|
| 17 | 任务数 | complex 任务共 17 个 |
| 13.5% | 完整成功率 | π0.5 在这 17 任务上 13.5% 完整完成 |
| 0.44 | 平均归一化得分 | 全部 complex episode(含失败)的平均里程碑得分 |
| 0.35 | 失败集子集得分 | 仅失败 episode 的平均部分得分 |
v4 Page 6 引文进一步印证:「π0.5 13.5% success on complex tasks yet attains a score of 0.44」。这一行的 “complex 17 13.5% 0.44 0.35” 表明完整失败不等于毫无进展;部分进度(0.35)显示了模型在失败时已经走到的位置。来源:S2 v4 PDF Page 12 Table IV + Page 6 引文,已落盘到 source-assets/S2-arxiv-v4/。
六、排行榜 4 维:超出完整 SR 名次
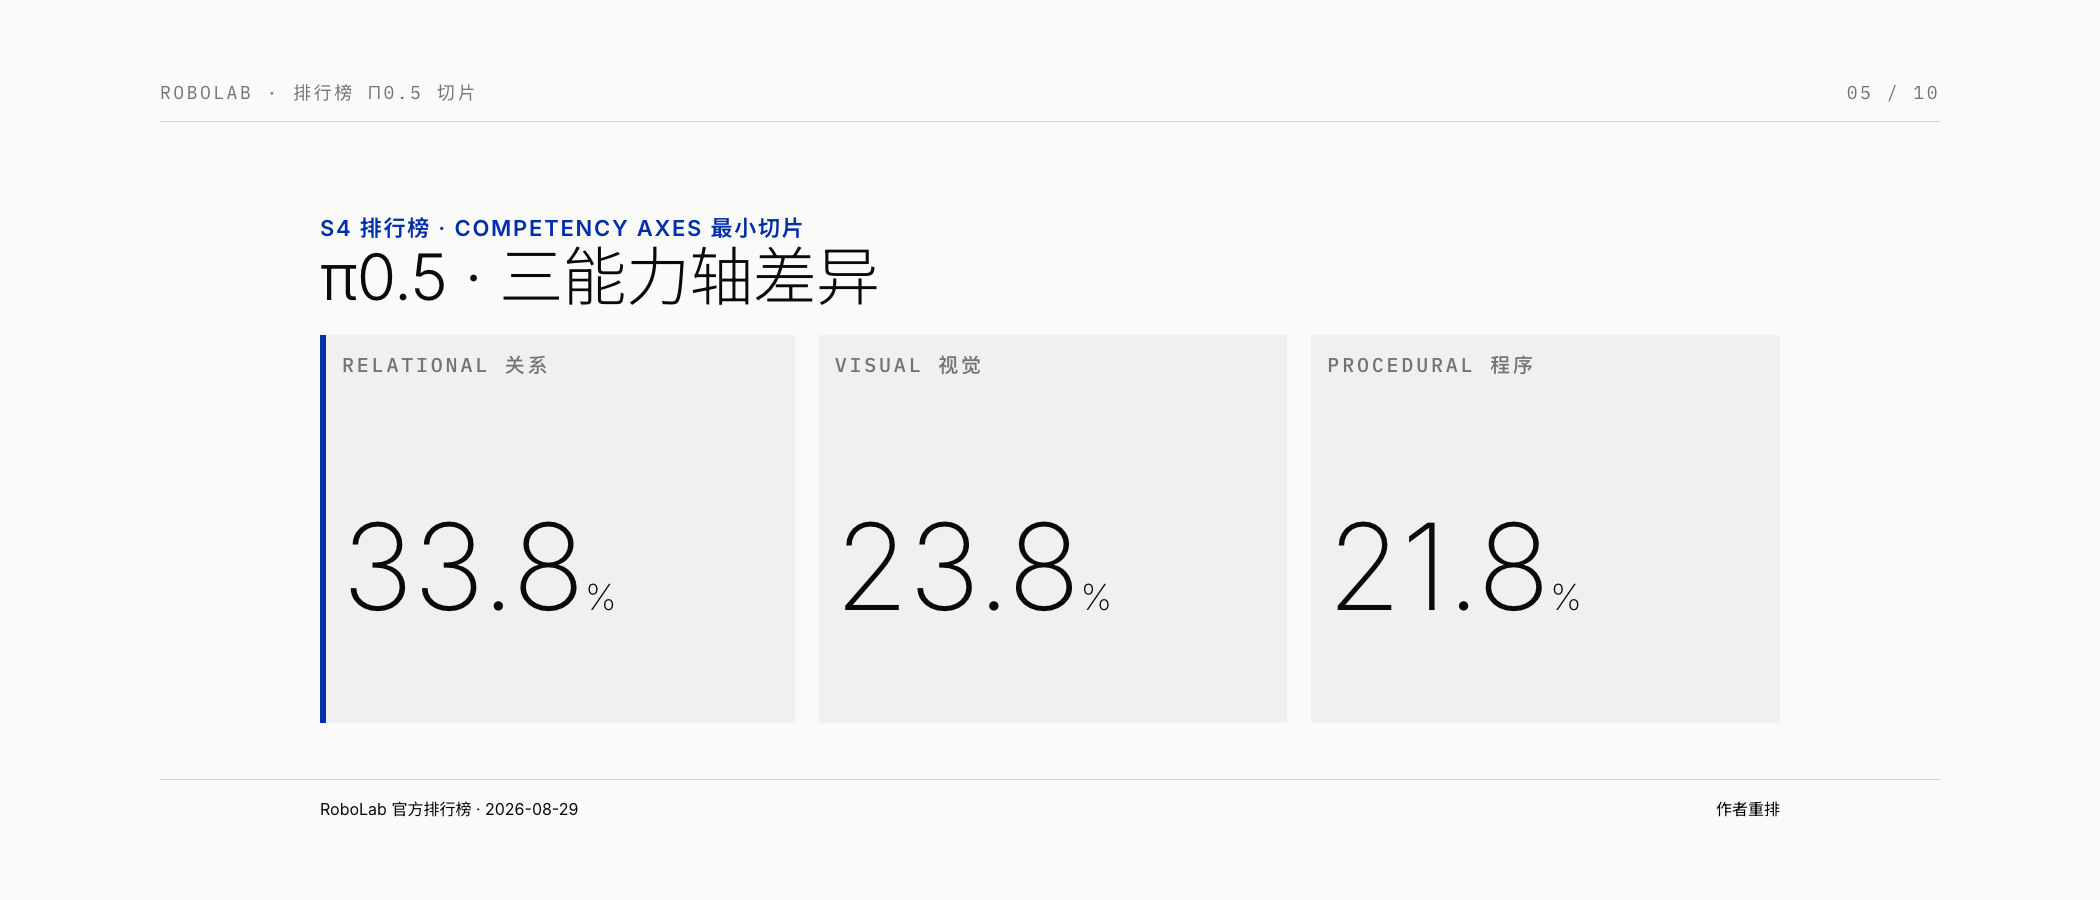
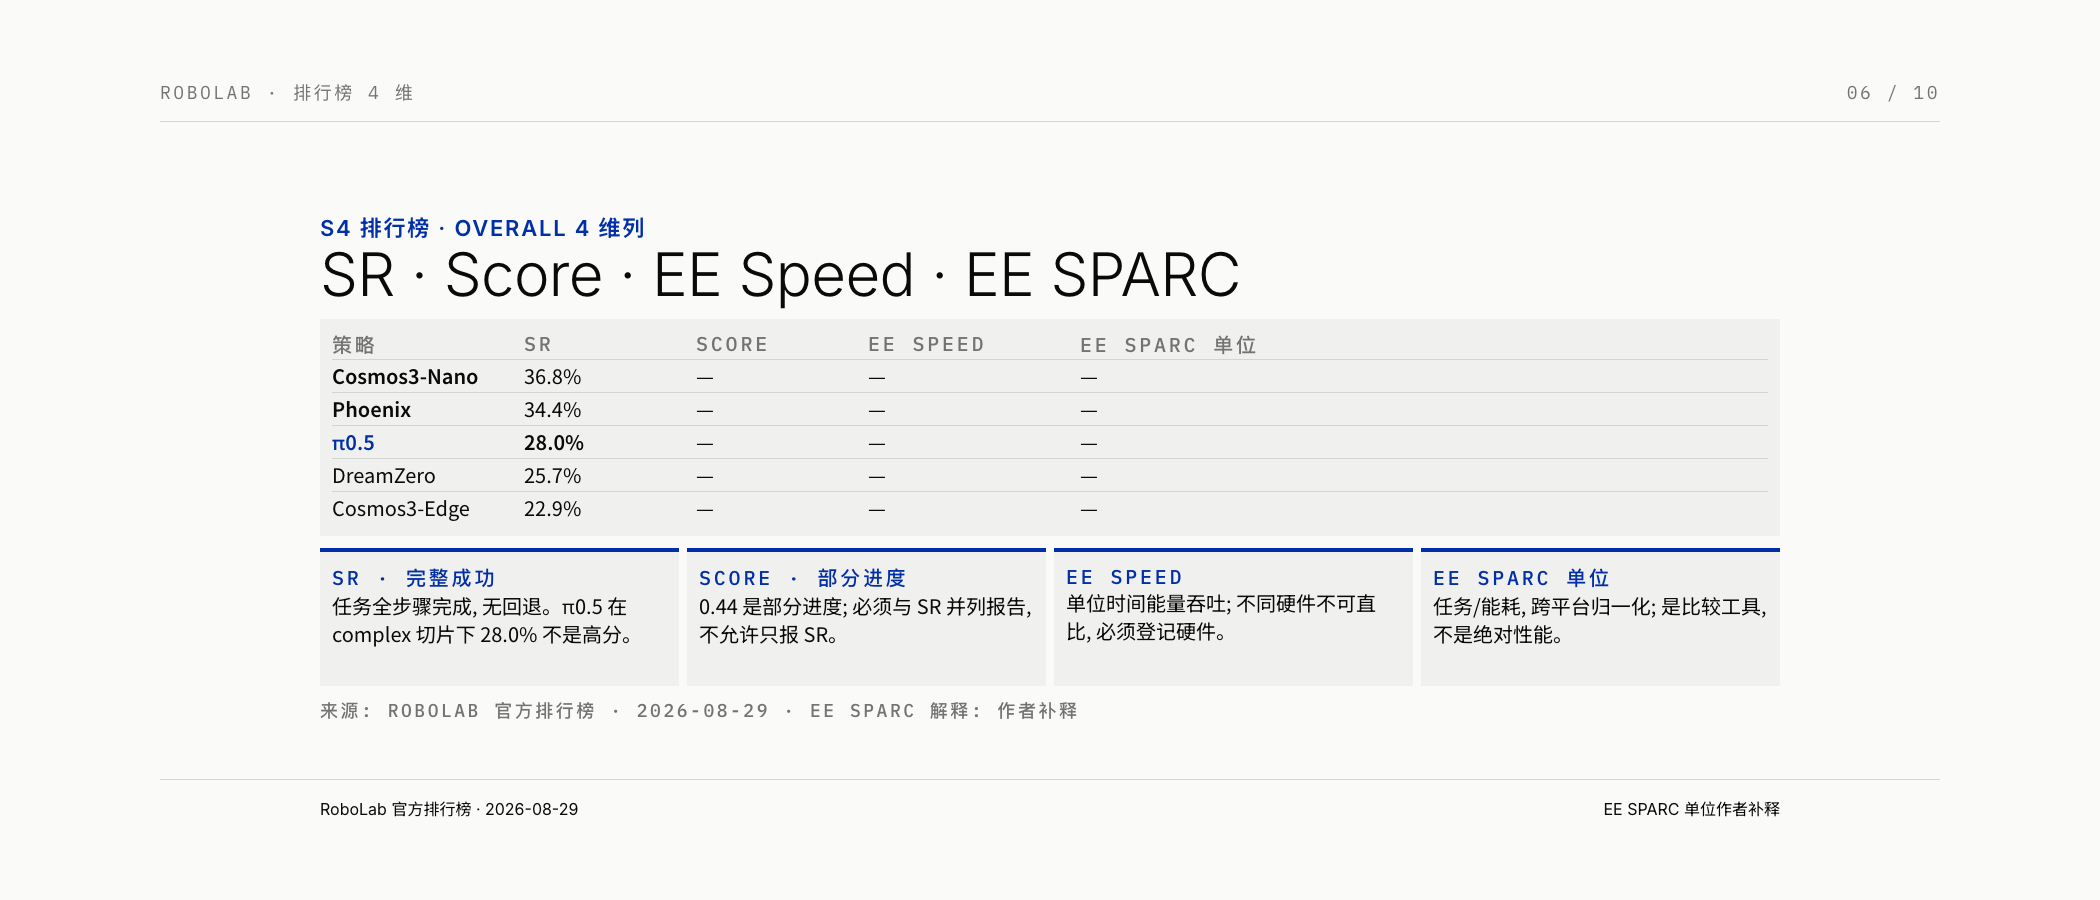
当前排行榜(2026-08-29)展示 4 维列而非 1 维:SR%(95% Clopper-Pearson CI)、Score(95% task-level bootstrap CI,×100)、EE Speed(cm/s)、EE SPARC(端效应器频谱弧长,越接近 0 越平滑)。π0.5 在 Default variant 下的能力轴最小切片是:Relational 33.8% / Visual 23.8% / Procedural 21.8%。仅看 Overall SR(28.0%)会丢失这种能力结构差异。来源:S4 当前排行榜文本摘录,已落盘到 source-assets/S4-leaderboard/。
排行榜当前页明确说明「Performance ranking correlate strongly with RoboArena Elo scores」(v4 Page 8 Fig. 10 给出 Spearman ρ = 1.00 与 Pearson r = 0.68 的精确数值)。严格表述:论文 / 项目在其比较范围内观察到 benchmark-level 排名与 RoboArena Elo 的相关性;不外推为:真实部署性能保证 / 普遍预测能力 / sim-to-real gap 已解决。
七、6 维最小报告协议
v4 论文 Appendix A-A(Page 11)公开 N=10 的统计限制:
“We evaluate each policy on N=10 episodes per task, and report results on our benchmark as aggregate results instead of per-task analysis between policies. With only 10 trials, the 95% confidence interval on a single per-task success rate is approximately ±30% near p=0.5 and ±19% near p=0.9, meaning per-task numbers should be interpreted as coarse indicators rather than precise estimates.”
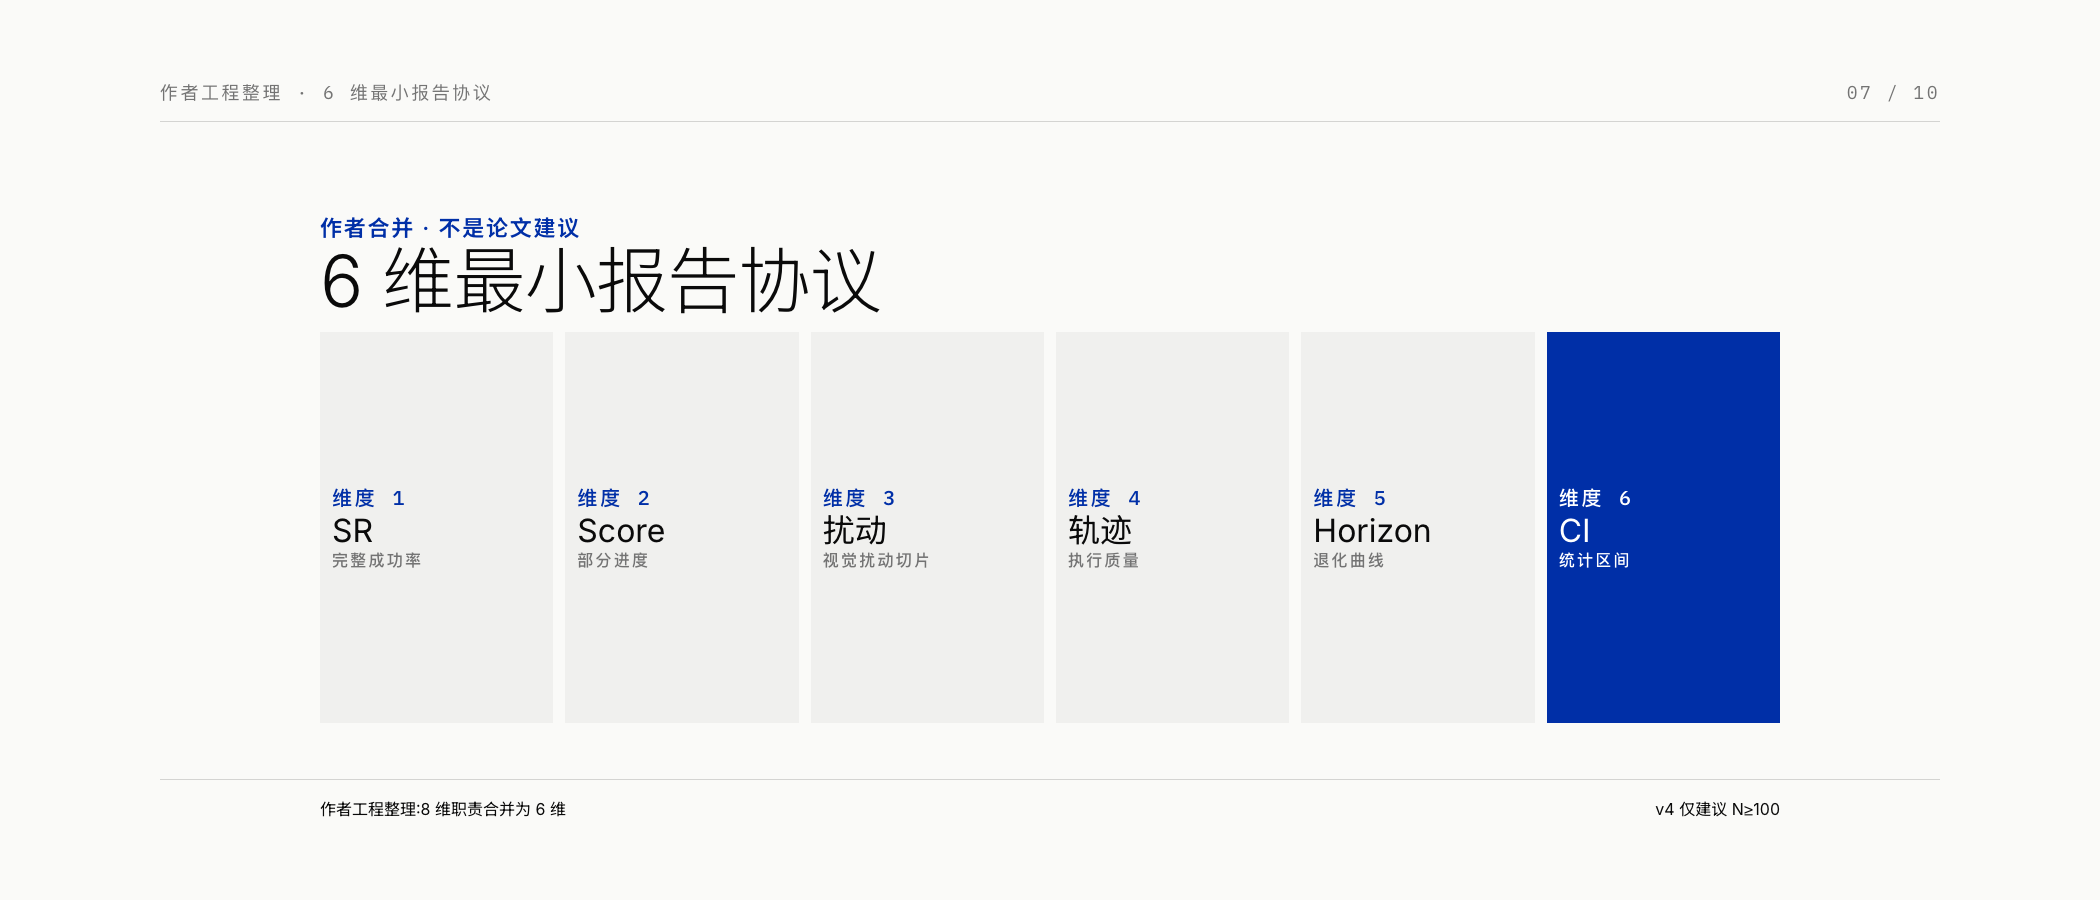
每任务 N=10 时,95% CI 半宽在真实成功率 0.5 时约 30pp、0.9 时约 19pp;N=100 把 0.5 半宽粗略降到 10pp、0.9 降到 6pp。结合上述 N=10 限制与 v4 论文作者关于”per-task numbers should be interpreted as coarse indicators”的提示,本文作者把原母稿的 8 个检查维度(结果、进度、效率、控制、恢复、鲁棒性、长时序、统计)收束为 6 个报告维度:SR + Score + 扰动 + 轨迹与执行质量 + Horizon + CI。v4 论文作者实际建议的是增加 episode 数(至少 N=100)以使 per-task 比较有意义,而”6 维协议”是本文作者基于多处证据形成的工程组织,不冒充 RoboLab 论文作者提出的官方框架。每任务比较时必须配对 rollout + 预声明最小关心差异 + 预声明功效。来源:S2 v4 PDF Page 11 Appendix A-A,已落盘到 source-assets/S2-arxiv-v4/appendix-a-a-statistical-faithful-excerpt.txt。
6 维对原 8 维的职责合并(本文作者工程组织声明,不是 RoboLab 论文作者官方协议):
| 6 维 | 覆盖原 8 维 | 必须保留的指标(合并后不得删除) |
|---|---|---|
| SR | 结果 | 完整成功率 + 每任务 k/n |
| Score | 进度 | 子任务得分 + 最后完成步骤 |
| 扰动 | 鲁棒性 | 摄像机 / 光照 / 背景 / 纹理 / 阴影 / 指令变化 |
| 轨迹与执行质量 | 效率 + 控制 + 恢复 | 路径长度 / 动作数 / 完成时间;SPARC / 抖动 / 碰撞 / 越界;失败后恢复率 / 重规划次数 |
| Horizon | 长时序 | 按 Horizon 的成功 / 进度曲线 |
| CI | 统计 | 95% CI(Clopper-Pearson 或 task-level bootstrap)+ 效应量 + 配对方式 + 功效 |
关键声明:把”效率 + 控制 + 恢复”三个原维度合并到”轨迹与执行质量”是本文作者为减少报告维度而做的职责合并(3 个原维度压成 1 个),不是论文官方协议;合并后必须继续报告效率(路径/动作/时间)、控制(SPARC/抖动/碰撞/越界)、恢复(恢复率/重规划)三类指标,不得因为维度名称是”轨迹与执行质量”就省略其中任何一类。也不要新增第二套框架——本文只保留”原 8 维 → 收束 6 维”这一映射,不另立八维或九步。
八、8 步最小可执行实验协议(本文作者工程组织)
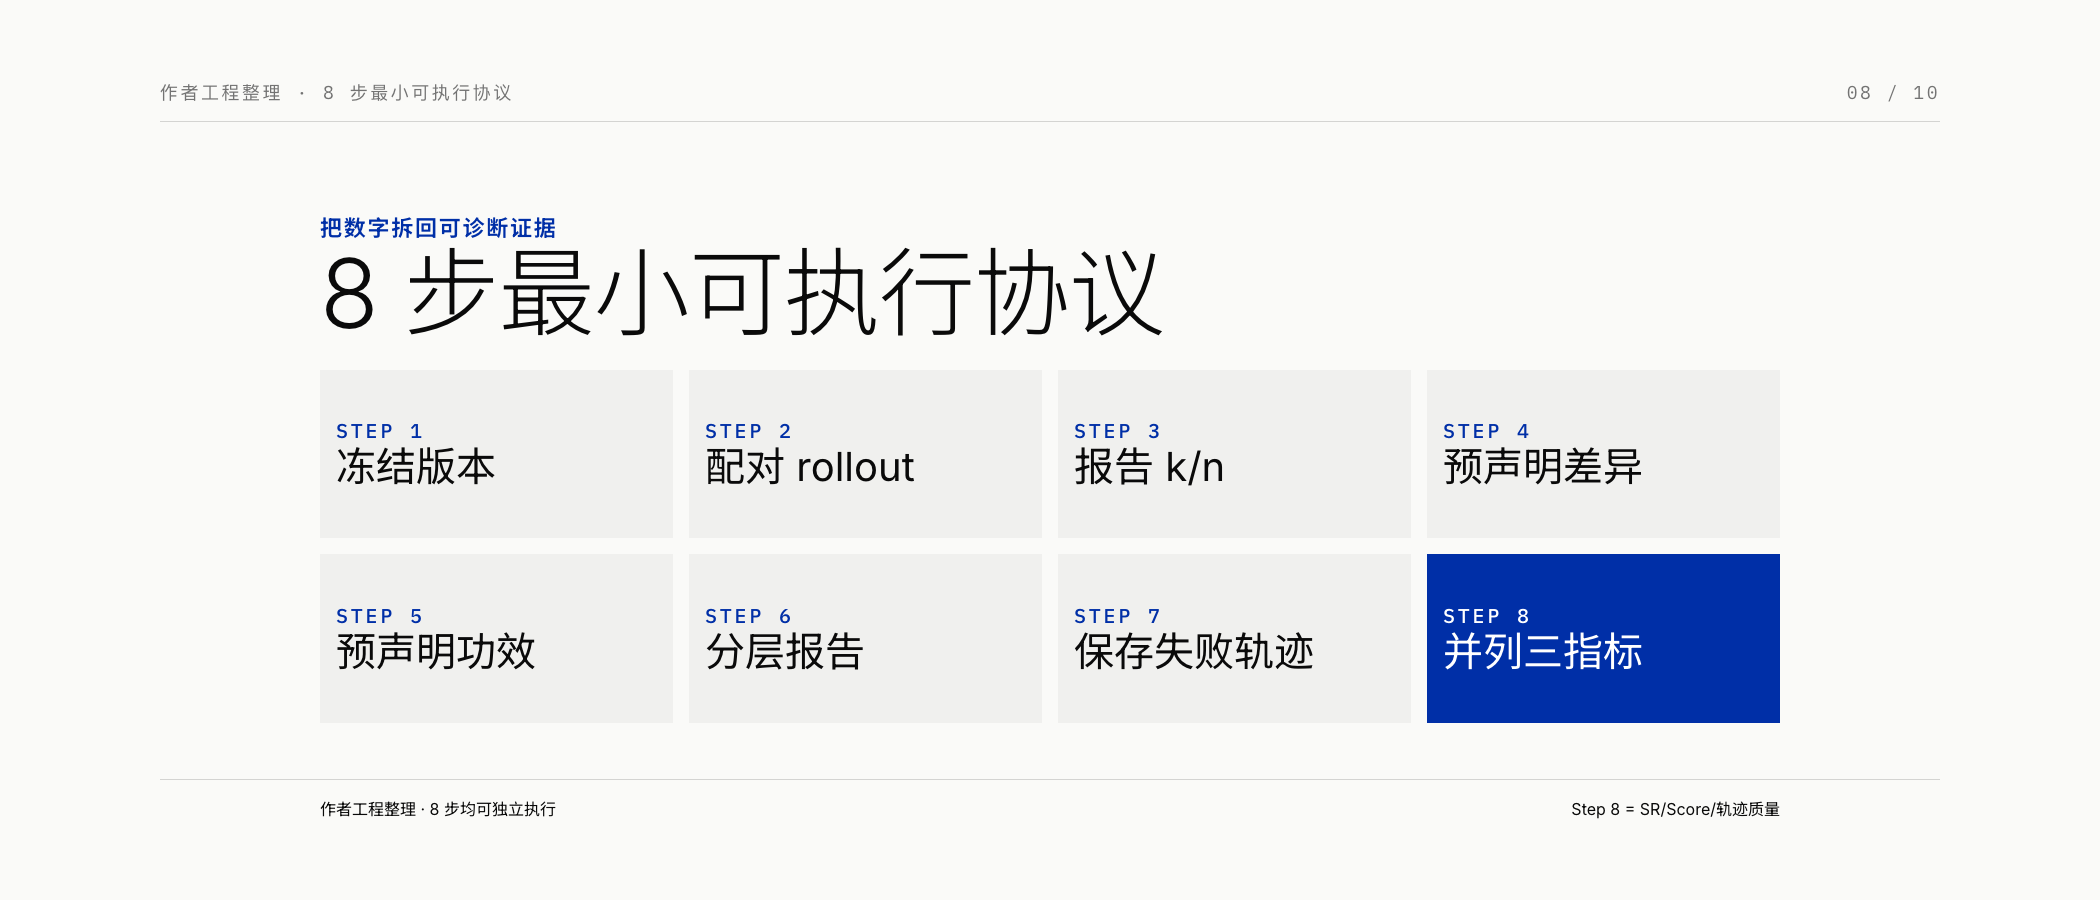
- 冻结任务清单 + 成功判定器 + 场景生成器版本。
- 对两个策略使用相同随机种子 / 布局 / 扰动,形成配对 rollout。
- 对每任务报告成功次数
k/n,而不是只给百分比。 - 预先声明主要指标和最小关心差异(例如 5 个百分点)。
- 根据所需精度或检验功效决定 episode 数,不要在看到结果后停止。
- 分层报告任务 / 能力 / Horizon / 语言 / 视觉扰动。
- 保存失败轨迹 / 判定器事件 / 策略版本,支持复盘。
- 将完整成功 / 部分进度 / 轨迹质量并列,不任意合成一个营销总分。
本节是本文作者工程组织声明,不冒充 NVIDIA / RSS / Isaac Lab 官方框架。
九、Horizon 局部上扬:任务组成差异,不是长时序能力增强
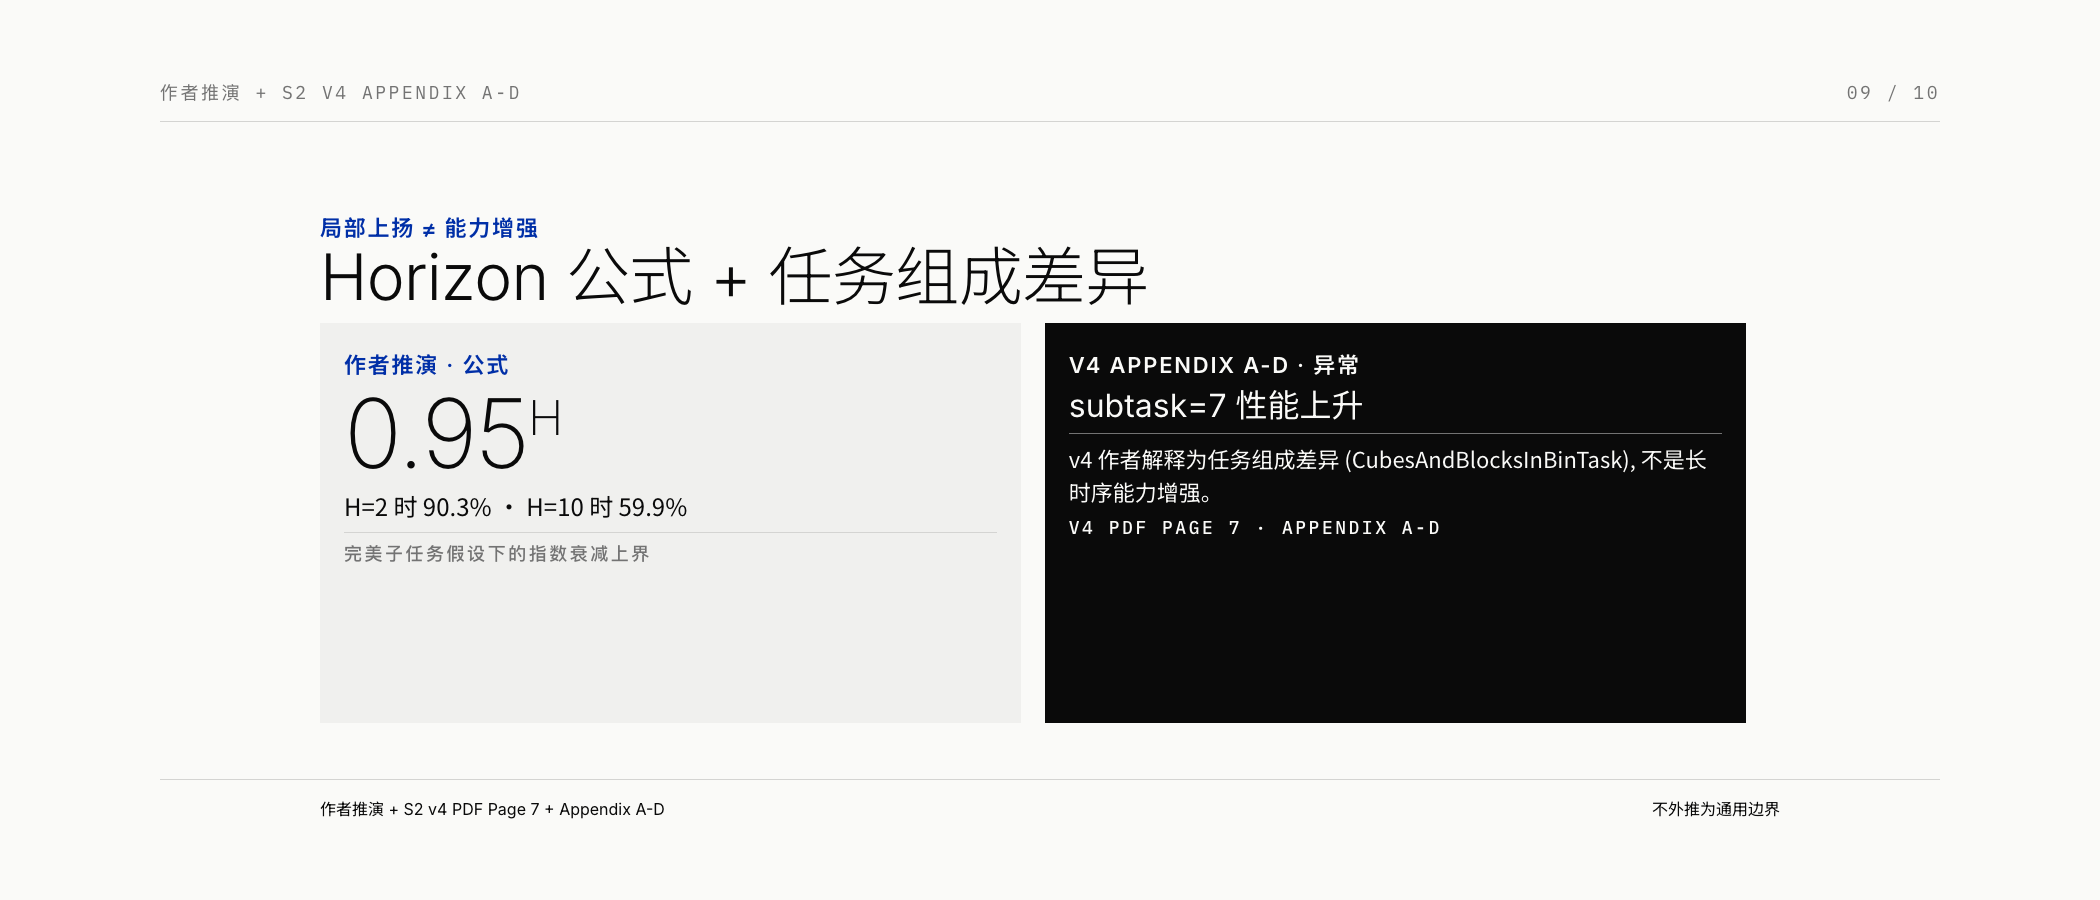
多步任务通常呈乘法退化。每步条件成功率近似 q 时,长度 H 的任务粗略成功率为 q^H。当 q=0.95,H=2 时约 90.3%,H=10 时只剩约 59.9%。真实任务的步骤并不独立,错误还能恢复,所以这个公式不是预测模型。
v4 论文 Page 7 仅观察到该异常并指向 Appendix A-D(逐字引用):
“A performance increase is observed at subtask=7 for π0.5 on CubesAndBlocksInBinTask is further discussed in Appendix A-D.”
对任务组成差异(cubes + 重复简单 pick-and-place 序列 + 非因果长时序任务)给出完整解释的是 v4 论文 Appendix A-D(“Anomalous long-horizon success at subtask=7”),不是 Page 7。附录 A-D 原文指出:subtask=7 这一档的 bin 几乎被 CubesAndBlocksInBinTask 占满(Fig. 11),该任务是几何简单的 cubes 重复 pick-and-place,不是真正需要多步推理的因果长时序任务;表面上的”恢复”反映的是任务组成,不是长时序推理能力增强。因此按 Horizon 聚合时必须同时报告每档任务数量与能力构成。来源:S2 v4 PDF Page 7 观察 + Appendix A-D 任务组成解释,已落盘到 source-assets/S2-arxiv-v4/anomalous-subtask-7-mention-faithful-excerpt.txt(Page 7 节选) + 同目录落盘的 Appendix A-A 全文摘录(同文件包含 Appendix A-D 章节的”task composition”段落)。
十、模拟器与判定器边界
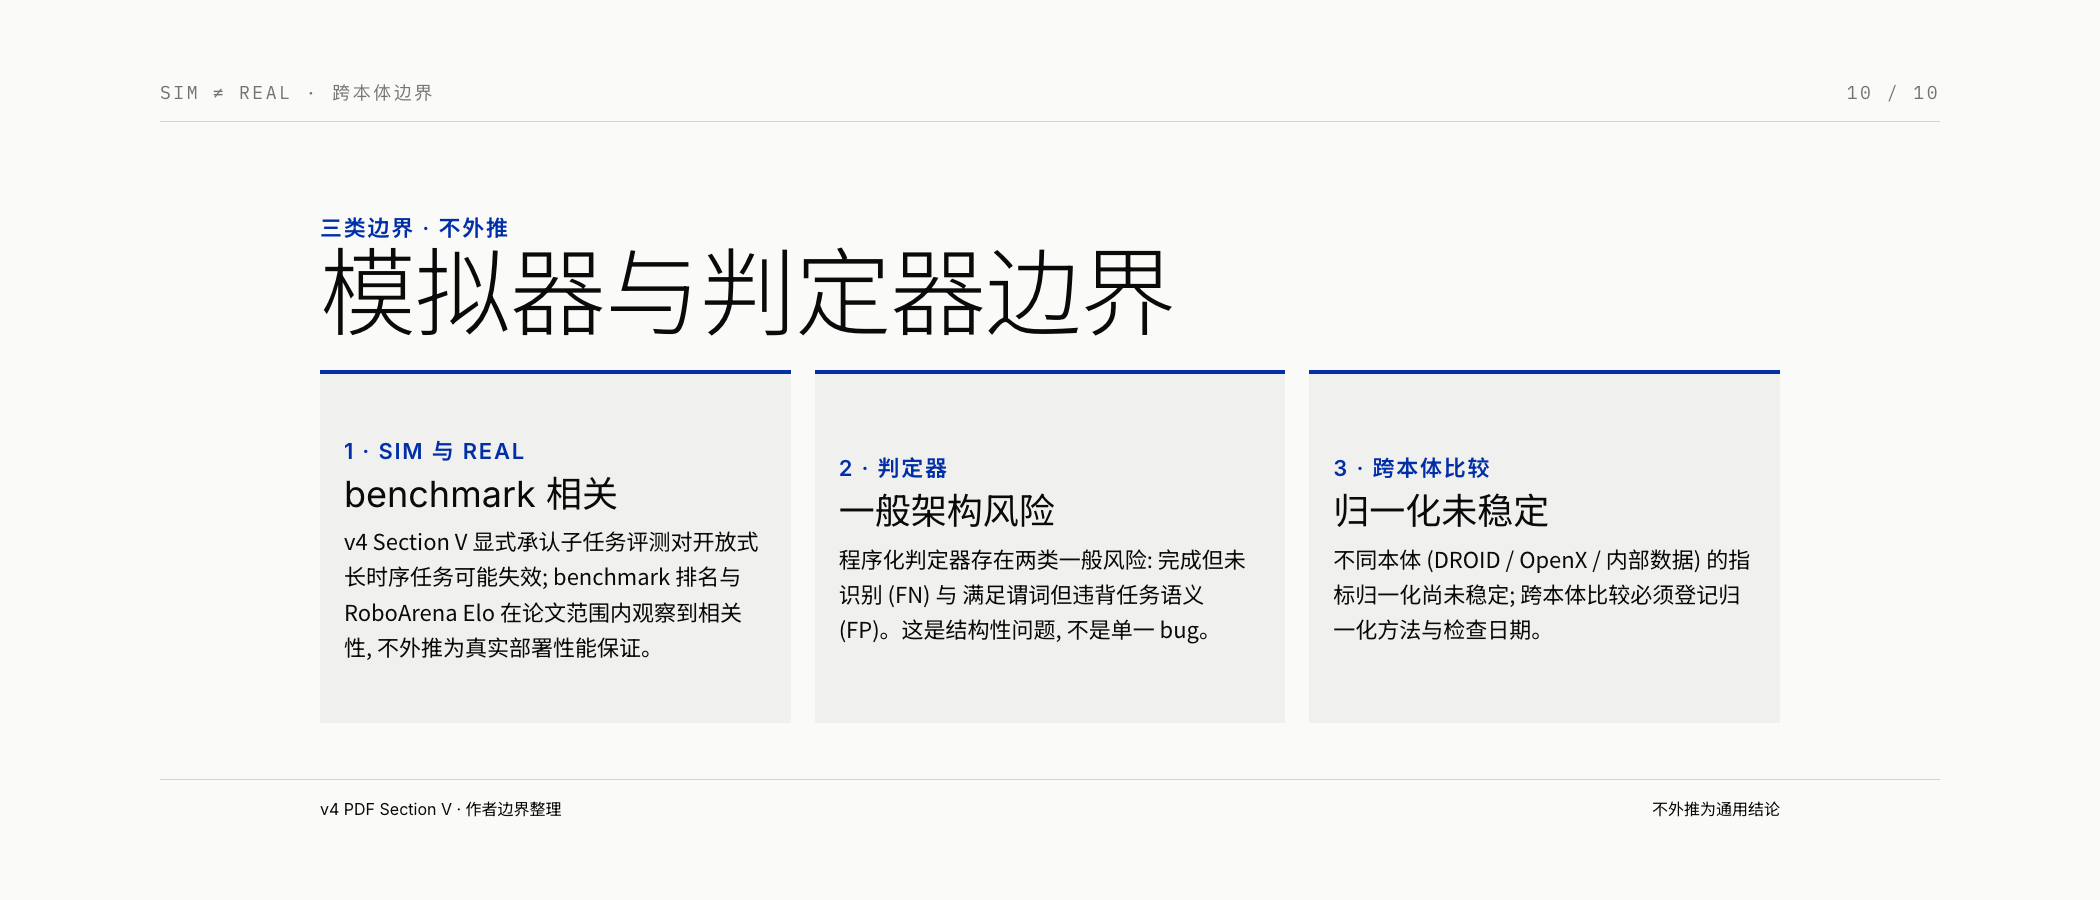
模拟器能提供可重复控制,却不能替代真实机器人测试。v4 论文 Section V 显式承认:子任务评测对开放式、语义含混的长时序任务可能失效并需要人工判断。
任何依赖程序化成功判定器的评测架构都可能出现”策略完成了、判定器没识别”或”满足谓词却违背任务语义”的错配,遮挡、柔性物体和语义完成条件尤其敏感。这是基于一般评测架构的风险推演,不是 RoboLab 论文已经实证量化的缺陷。RoboLab 的 120 个任务不代表开放世界机器人能力全集;它更适合作为可扩展诊断骨架。
跨本体比较的归一化边界(基于母稿”机器人本体不应绑定任务语义”):任务语义可以不绑定特定机器人;RoboLab 官方代码仓库把任务定义为 embodiment-independent,并通过适配层让不同机器人执行相同语义任务。但动作空间、抓手能力、可达范围、传感器和控制频率仍需适配:不同机器人之间的 SPARC、速度变化和路径长度原始值不能直接横比。跨机器人报告时,应同时给出 (1) 机器人/控制配置(关节数、控制频率、抓手类型)、(2) 原始值、(3) 按动作时长 / 关节范围 / 任务最短路径归一化后的值,三者并列才能区分”任务能力差异”与”本体动力学差异”。
十一、结论
RoboLab 的关键转变是从”排行榜上的一个成功率”转向”任务能力、环境变化、部分进度、轨迹质量与不确定性的联合证据”。一个机器人策略只有在相同任务条件、足够 rollout、明确区间和可诊断失败结构下,才具备可比较性。二元成功率可以保留,但不能继续独占结论。
读者看一份机器人评测报告时,先问 4 件事:
- 任务是否按能力轴切片?
- 部分进度(子任务得分)是否与完整成功并列报告?
- 扰动维度(光照 / 摄像机 / 背景 / 纹理 / 阴影)是否独立成段?
- 报告是否同时给出点估计与
k/n+ 95% CI?
满足这 4 件事的报告才具备可比性;不满足时再多排行榜也只是把 90% 与 92% 排得更整齐。
参考资料
- RoboLab: A High-Fidelity Simulation Benchmark for Analysis of Task Generalist Policies (v4), Yang et al., arXiv 2604.09860v4, 2026-08-14 修订, Robotics: Science and Systems (RSS) 2026。
- NVIDIA RoboLab 官方项目页, NVIDIA Research, 2026, 访问日期 2026-08-29。
- NVlabs/RoboLab GitHub 仓库, NVIDIA Labs, Apache 2.0, 2026, 访问日期 2026-08-29。
- RoboLab 官方排行榜, NVIDIA Research, 2026, 访问日期 2026-08-29。
- 母稿:RoboLab 解读:机器人策略评测为什么不能只看二元成功率, DRAFT-20260714-0004, research_cutoff 2026-07-14, 已通过独立 Q2 审核(IR-20260829-DRAFT-20260714-0004-Q2-I1)。