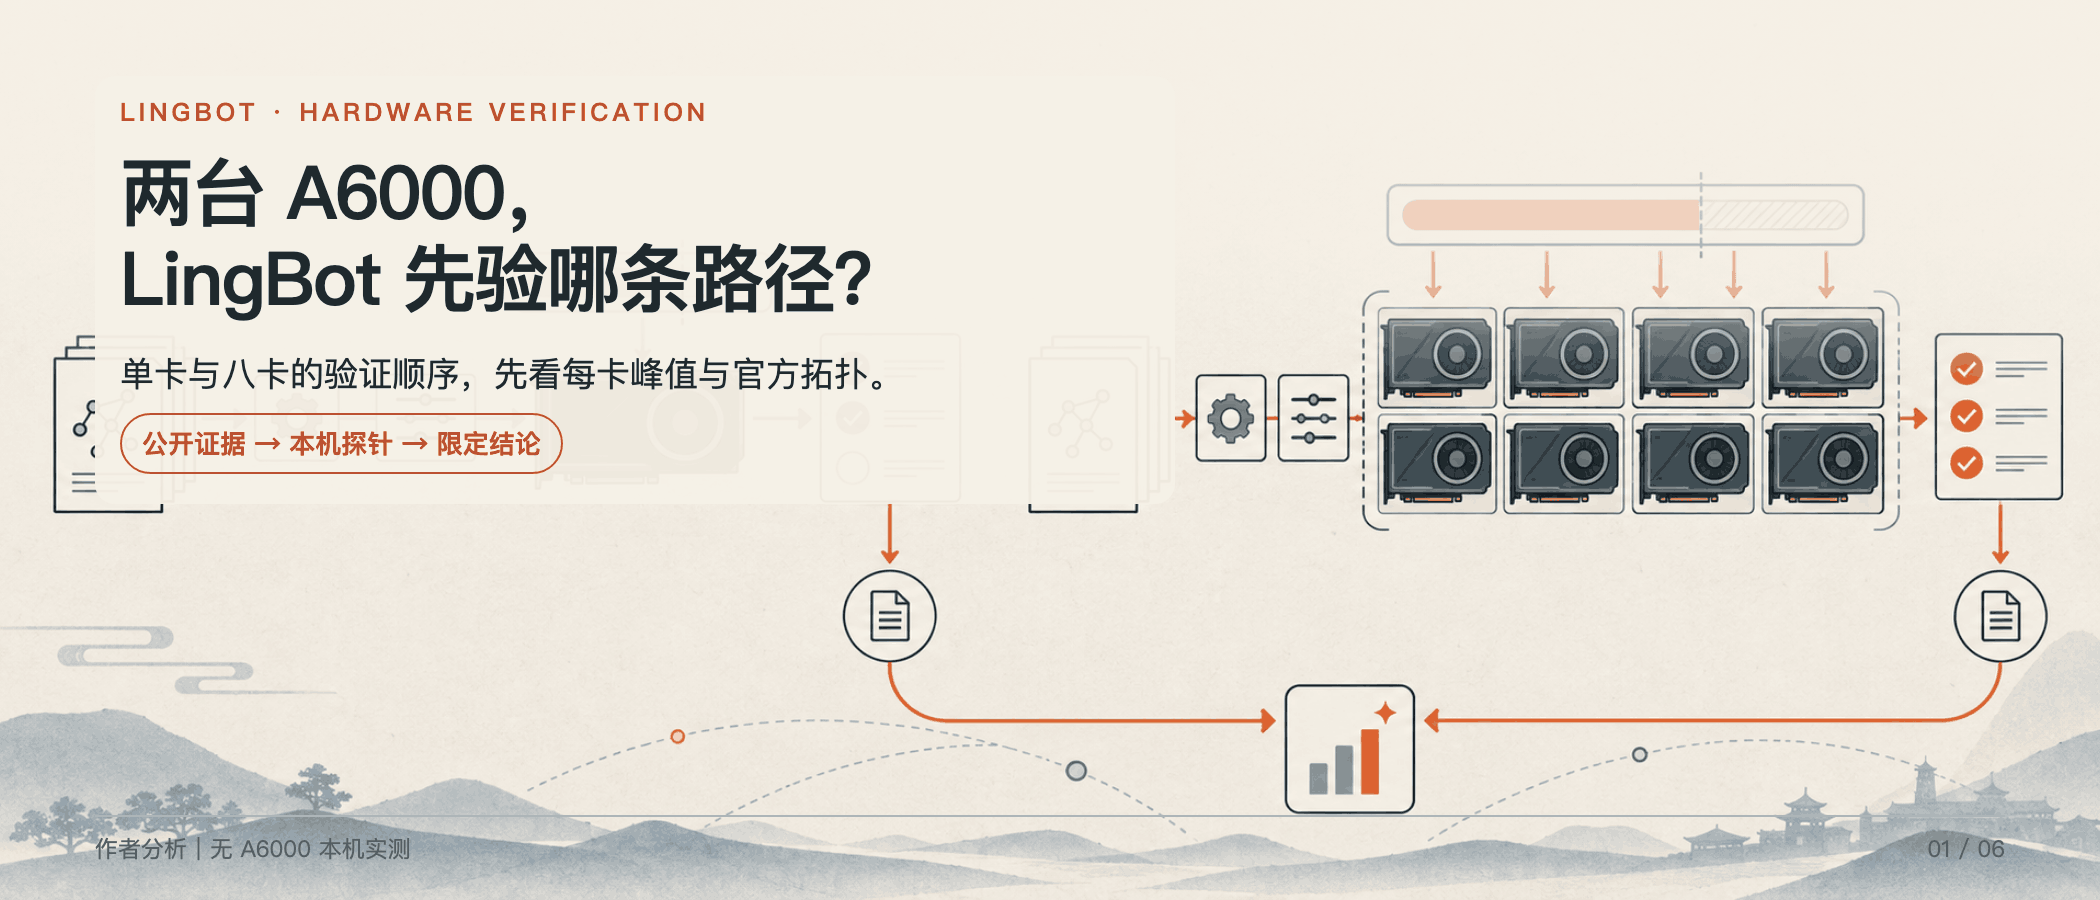
本文是公开资料驱动的验证顺序,不含 A6000 本机实测;数字必须连同任务、输入和拓扑一起读。
假设有一台单卡 RTX A6000 48 GB 工作站,以及一台 8×A6000 工作站。看到 LingBot 各项目的权重和脚本,很容易把“官方给了单卡入口”“官方示例启动 8 个进程”翻译成“我的机器能跑”。这一步恰恰最容易花掉几天下载、装环境和排查的时间。
一个更具体的判断是:先找与目标任务相同的官方证据,再决定在哪台机器上做最小复现;没有 A6000 实测的路径只列为候选,不写成兼容承诺。 权重能下载、进程能启动、离线输出正确、后训练能收敛、线上系统能达到论文速度,是五个不同的结果。
最新的证据改变了什么
旧版硬件指南把 LingBot-Video 归为“官方没有公布峰值显存”。这已不符合截至 2026 年 9 月 26 日核对的官方推理速度与显存报告。报告固定了五秒、24 FPS、121 帧、480×832、40 步、基础模型 T2V、单请求等条件,并按拓扑列出每卡 NVML 峰值:
| LingBot-Video 路径 | 官方报告的每卡峰值 | 对 A6000 的含义 |
|---|---|---|
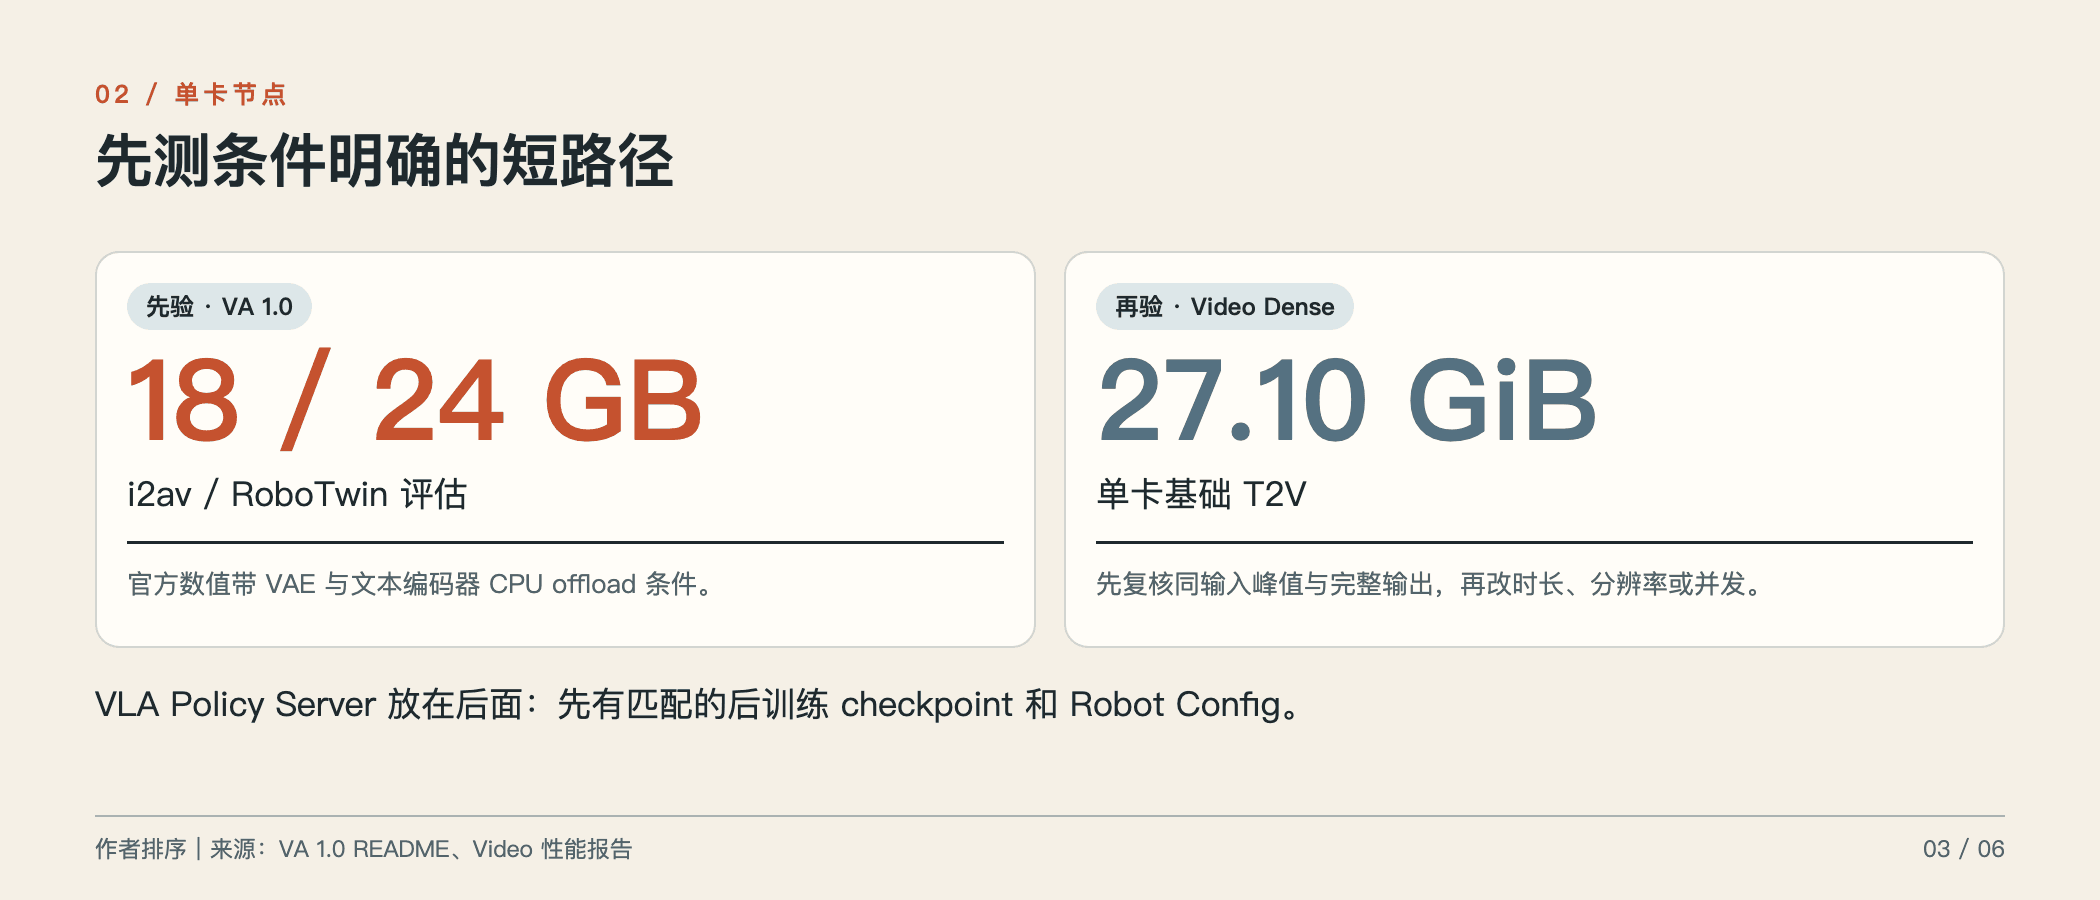
| Dense,单 GPU | 27.10 GiB | 小于 48 GB,值得在单卡复核;仍不是 A6000 实测 |
| MoE,单 GPU | 90.15 GiB | 超过单卡 48 GB,不应照搬这条 BF16 路径 |
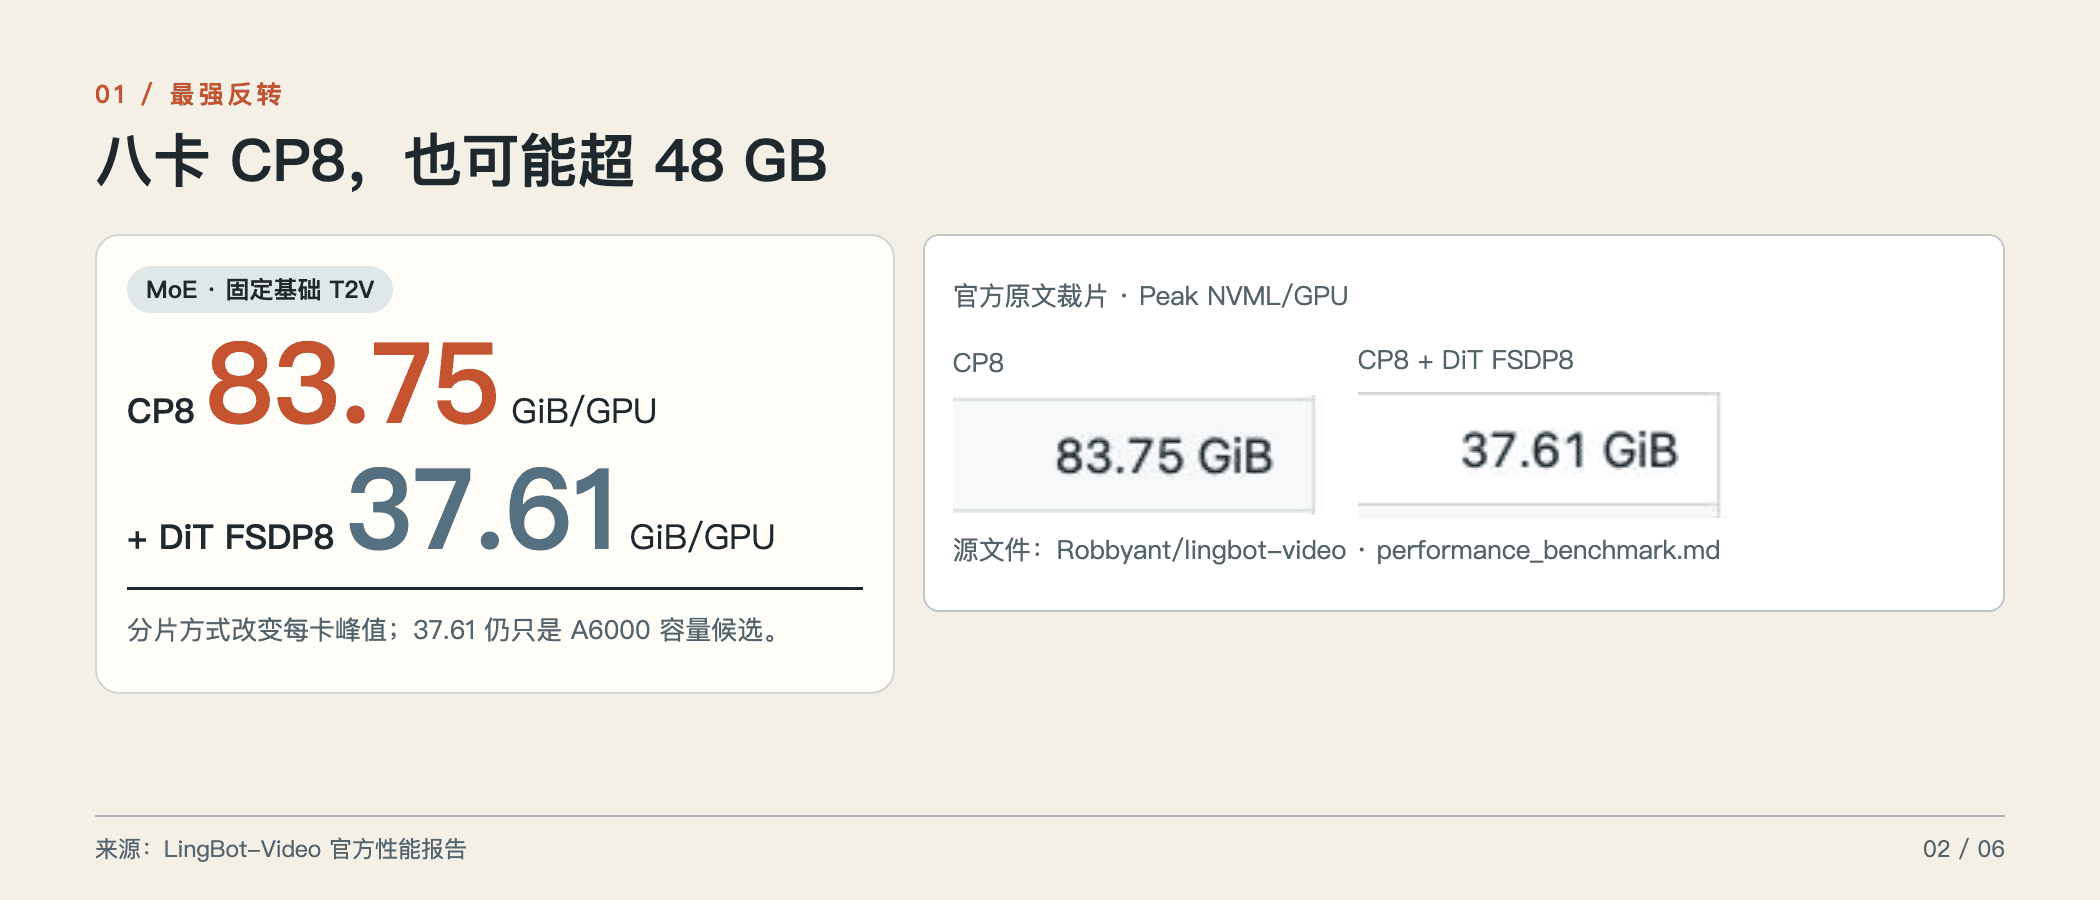
| MoE,8 GPU CP8、未做 DiT FSDP | 83.75 GiB | “八卡”本身没有让每卡峰值落进 48 GB |
| MoE,CP8 + DiT FSDP8 | 37.61 GiB | 仅在报告的基础生成条件下具有容量候选意义 |
| MoE,CP8 + DiT FSDP8 + VLM FSDP8 | 31.208 GiB | 每卡更低,但报告还提示主机内存压力上升 |
| MoE,8 GPU CP8 + FP8 expert | 110.80 GiB | 这条 FP8 是速度配置,不能把“FP8”直接当省显存 |
这张表最重要的反转是:MoE 从 90.15 GiB 降到 37.61 GiB,关键是 DiT FSDP 分片;仅把任务铺到八卡,83.75 GiB/GPU 仍超过 A6000 容量。 而 37.61 GiB 只对应报告的基础生成、特定输入和精度,不含 Refiner、Rewriter、并发或 A6000 实机结果。报告没有给出这组测试的 GPU 型号,不能称为“A6000 官方跑通”。官方脚本说明确实分开列出单卡、CP8+FSDP 无 Refiner 与带 Refiner 的多卡脚本;应从与显存报告对应的无 Refiner 路径开始。
报告还列出 MoE 的 CP8 + DiT FSDP8 + VLM FSDP8 主机总 RSS 约 145.2 GiB。它不是“每个 rank 需要 145.2 GiB”,也不是 8×A6000 的最低内存要求,却足以说明只看 384 GB 显存会漏掉 CPU 侧装载压力。
为什么总显存够,单个进程仍可能失败
把八张卡的容量相加,得到的是资源总量,不是某个进程可申请的一块连续显存。可以把这个问题分成三个观察位置:权重驻留、计算过程中的临时张量、以及输出阶段的额外组件。原表的 CP8 和 CP8 加 DiT FSDP8 已经提供了一个具体反例:两者都使用八卡,却有不同的每卡峰值。因此实验清单必须写出分片对象和分片组大小,不能只写“多卡模式”。这是从报告结果得到的验证要求,不是对全部模型分布式实现的概括。
另一个容易漏掉的地方是峰值发生时刻。模型装载后看见显存还很空,不代表最后解码也有同样余量;某个 rank 单独承担保存或解码步骤时,其他卡的空闲不会自动替它缓冲。实际探针要把初始化、生成、解码和保存时间点对齐,再判断是权重装不下,还是完整链路某一段超过容量。若只截取开始生成前的截图,后续失败便会被误写成随机异常。
这里也要统一单位。GPU 商品页的容量标识、系统工具显示的 MiB/GiB,以及文章引用的 GB,不能直接按文字大小比较到小数点后两位。原报告的测量单位保持不变,本机结论则同时附实际可见容量和峰值单位。候选筛选只做粗粒度判断;真正的余量判断用同一工具、同一单位、同一次运行的数字完成。
最后,offload 把一部分压力移到主机侧,不能只记 GPU 省下了多少。CPU 内存、加载时间和传输等待会进入代价清单。假设一个路径能完成单次任务,但系统开始频繁交换内存,下一步应该确认主机资源和装载方式,而不是据此宣布它适合连续服务。这个假设并非本机观察,只是在解释为什么报告中的主机 RSS 值值得与显存峰值一起保留。
哪些结论有官方依据,哪些仍要实测
| 产品线与目标 | 官方给出的可核对证据 | 单卡 A6000 | 8×A6000 |
|---|---|---|---|
| LingBot-VA 1.0:i2av / RoboTwin 评估 | 官方 README分别写约 18 GB、24 GB,条件是 VAE 与文本编码器 CPU offload | 最适合先做同条件单卡复核;数字不是 A6000 峰值 | 小任务可独立排队,不因八卡而自动提高单任务速度 |
| LingBot-Video Dense:基础 T2V | 官方报告单卡 27.10 GiB | 有容量候选依据,需同输入记录实测峰值与输出 | 可并行跑独立任务;若追求单请求提速,另验 CP8 成本 |
| LingBot-Video MoE:基础 T2V | 同报告单卡 90.15 GiB;CP8+DiT FSDP8 为 37.61 GiB/GPU | 不照搬报告的完整 BF16 单卡路径 | 从无 Refiner 的 CP8+DiT FSDP8 路径做候选复核 |
| LingBot-World 2.0:14B causal-fast | 官方仓库给 480P、361 帧、8 进程与 FSDP/Ulysses 命令 | 未给单卡 14B 路径或 A6000 实测 | 只是 8 卡离线推理候选;官方声明不计划发布其部署代码 |
| LingBot-World 2.0:1.3B causal-fast | 同仓库新增 4 GPU 示例;1.3B 包只含 DiT,T5/VAE/tokenizer 借 14B 资产 | “1.3B”也不等于现有官方单卡路径 | 可先在四卡子集验证资产拼装与 480P 离线输出 |
| LingBot-VLA 2.0:Policy Server | 官方仓库有单进程服务入口;4090D、10 去噪步约 130 ms | 可作为待实测服务候选;不能移用 4090D 延迟 | 更适合隔离仿真评估并发,先确认每个服务的驻留显存 |
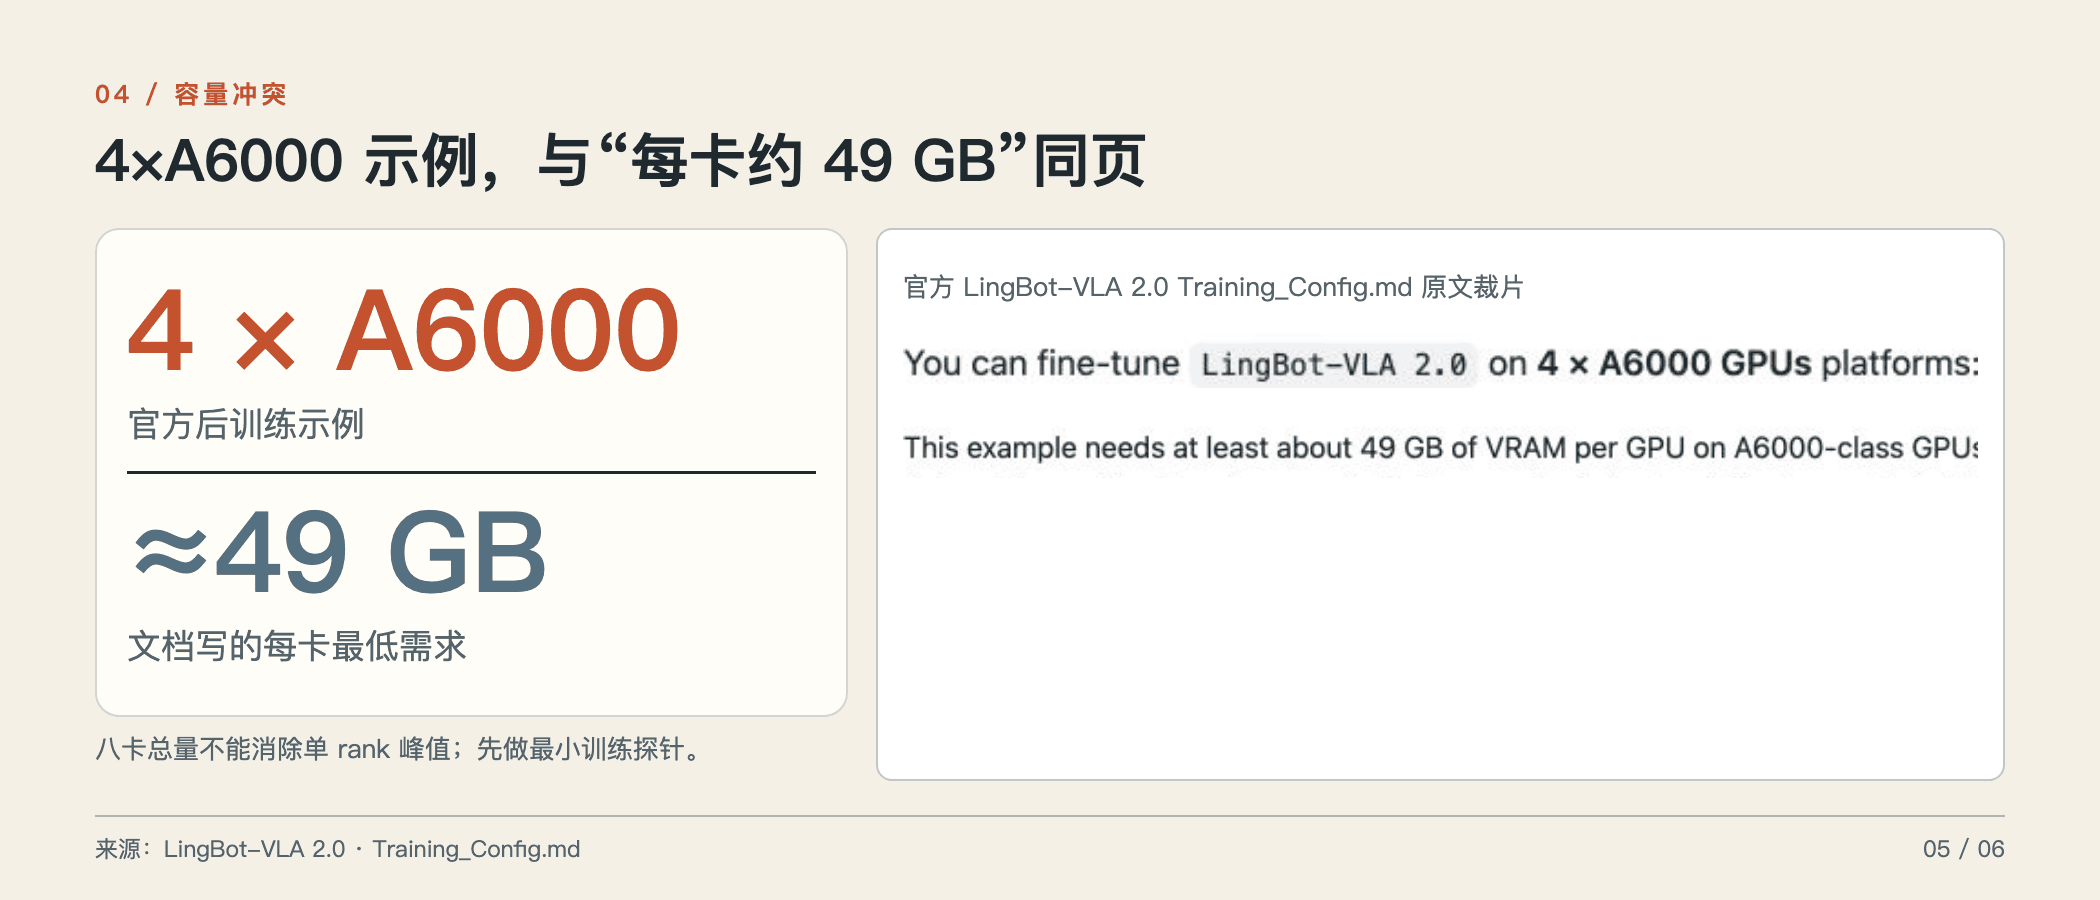
| LingBot-VLA 2.0:后训练 | 官方训练配置列 4×A6000 示例,同时写每卡至少约 49 GB | 官方示例自身容量口径就超过 48 GB,不能承诺跑通 | 八卡总量不能自动消除单 rank 需求;必须改配置并做最小训练探针 |
| LingBot-VA 2.0 | 本轮核对的项目页与仓库有论文与 VA 1.0 代码,未见完整 VA 2.0 可运行权重与部署契约 | 暂不能估算可靠显存 | 暂不能承诺部署 |
“容量候选”只表示官方已给出同拓扑或近似路径的证据,可以决定优先实测;它不等于本机跑通。World 2.0 的 720p、60 FPS 官方演示也不能由公开的 480P 离线脚本复现。官方 README把公开离线推理和未公开的部署代码分开说明。
两台机器先做什么
单卡节点先做 VA 1.0 的 offload 推理。 它有最明确的官方显存条件:i2av 约 18 GB,RoboTwin 单卡评估约 24 GB。先按 README 的输入、offload 和环境运行,记录本机峰值,再换真实负载。这个结果只证明 VA 1.0 对应任务,不可借给 VA 2.0。
第二个单卡对象是 Video Dense。官方 27.10 GiB 峰值来自固定五秒基础 T2V。先用同输入跑一次、记录冷启动与稳定单次耗时和完整输出;再逐一改变时长、分辨率或并发。只有实际测到峰值及余量,才可以写“A6000 在某个配置下可运行”。同系列已单独讨论 DMD、FP8 和推理路径,本篇不把八步学生模型的速度拿来替换这个 40 步基础模型的显存证据。
VLA 2.0 Policy Server 排在后面。它需要目标机器人或任务的后训练 checkpoint,以及与之匹配的 Robot Config、归一化统计、相机和动作通道。基础 6B 权重“可装载”并不代表可直接控制一台新机器人。先做模型服务与机器人客户端的离线协议检查,再开环、仿真,最后考虑低速真机;限幅和急停留在模型服务之外。
八卡节点先做 MoE 无 Refiner 基础生成。 对照官方 37.61 GiB/GPU 那行选择 CP8+DiT FSDP8,而不是只看到“CP8”就启动;同时采集每卡峰值、主机 RSS、加载时间和输出。若报告条件下都失败,应先查拓扑、环境和主机内存,不先加入 Refiner、27B Rewriter 或并发。若基本路径通过,后续每新增一个组件都重新计显存和质量。
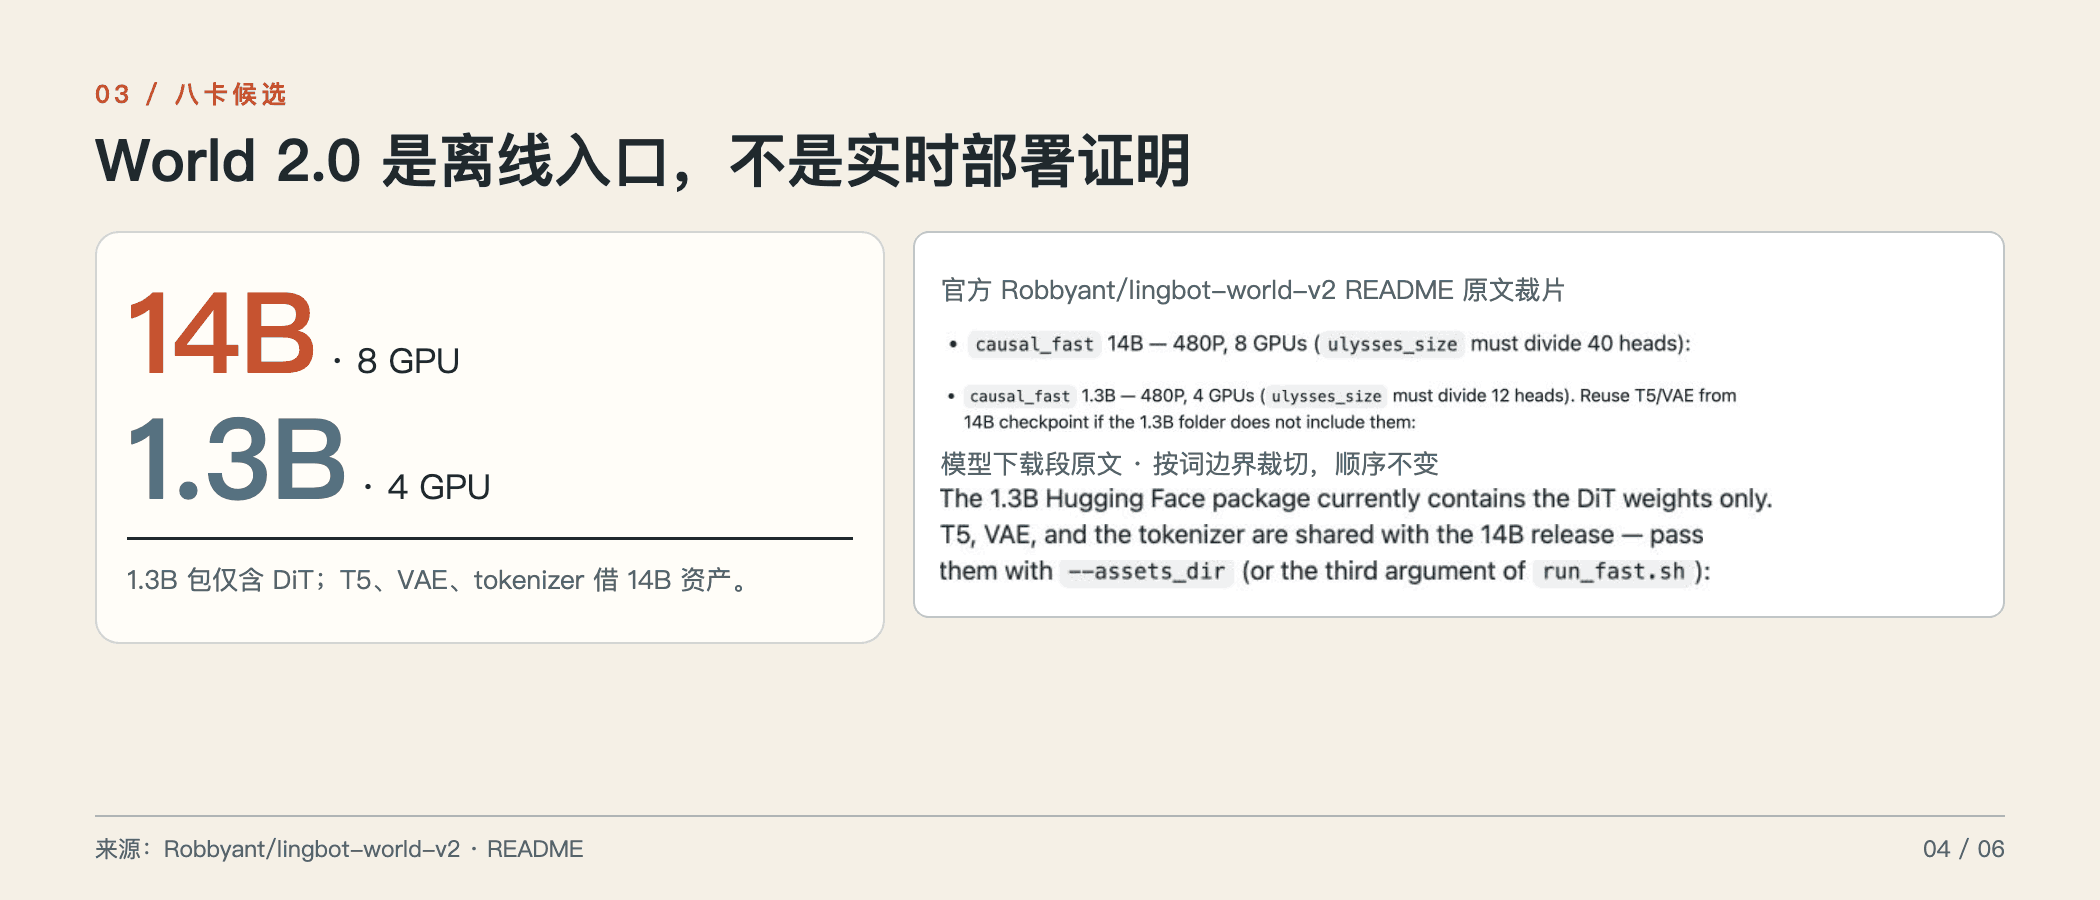
World 2.0 是另一条单独的八卡验证路线。官方 14B causal-fast 的 8 进程、480P、361 帧命令可以验证离线推理与控制文件,但不能验证实时部署或 A6000 达到官方演示帧率。1.3B 版本虽小,官方示例仍用四进程,而且需要借用 14B 资产;下载 1.3B DiT 后马上按单卡模型启动会漏掉 T5、VAE 和 tokenizer。
VLA 2.0 后训练不应作为八卡验收的第一项。官方“4×A6000 示例”和“每卡至少约 49 GB”放在同一文档中,形成必须先实测才能解释的容量冲突。八卡可以在改变 FSDP、图像/深度、micro batch 与 checkpointing 后研究降低峰值,但这已经是新实验配置;不能说官方示例已证明八张 48 GB 卡能训练。训练配置原文也强调显存会随数据和选项变化。
一次最小探针怎样留下可复核结论
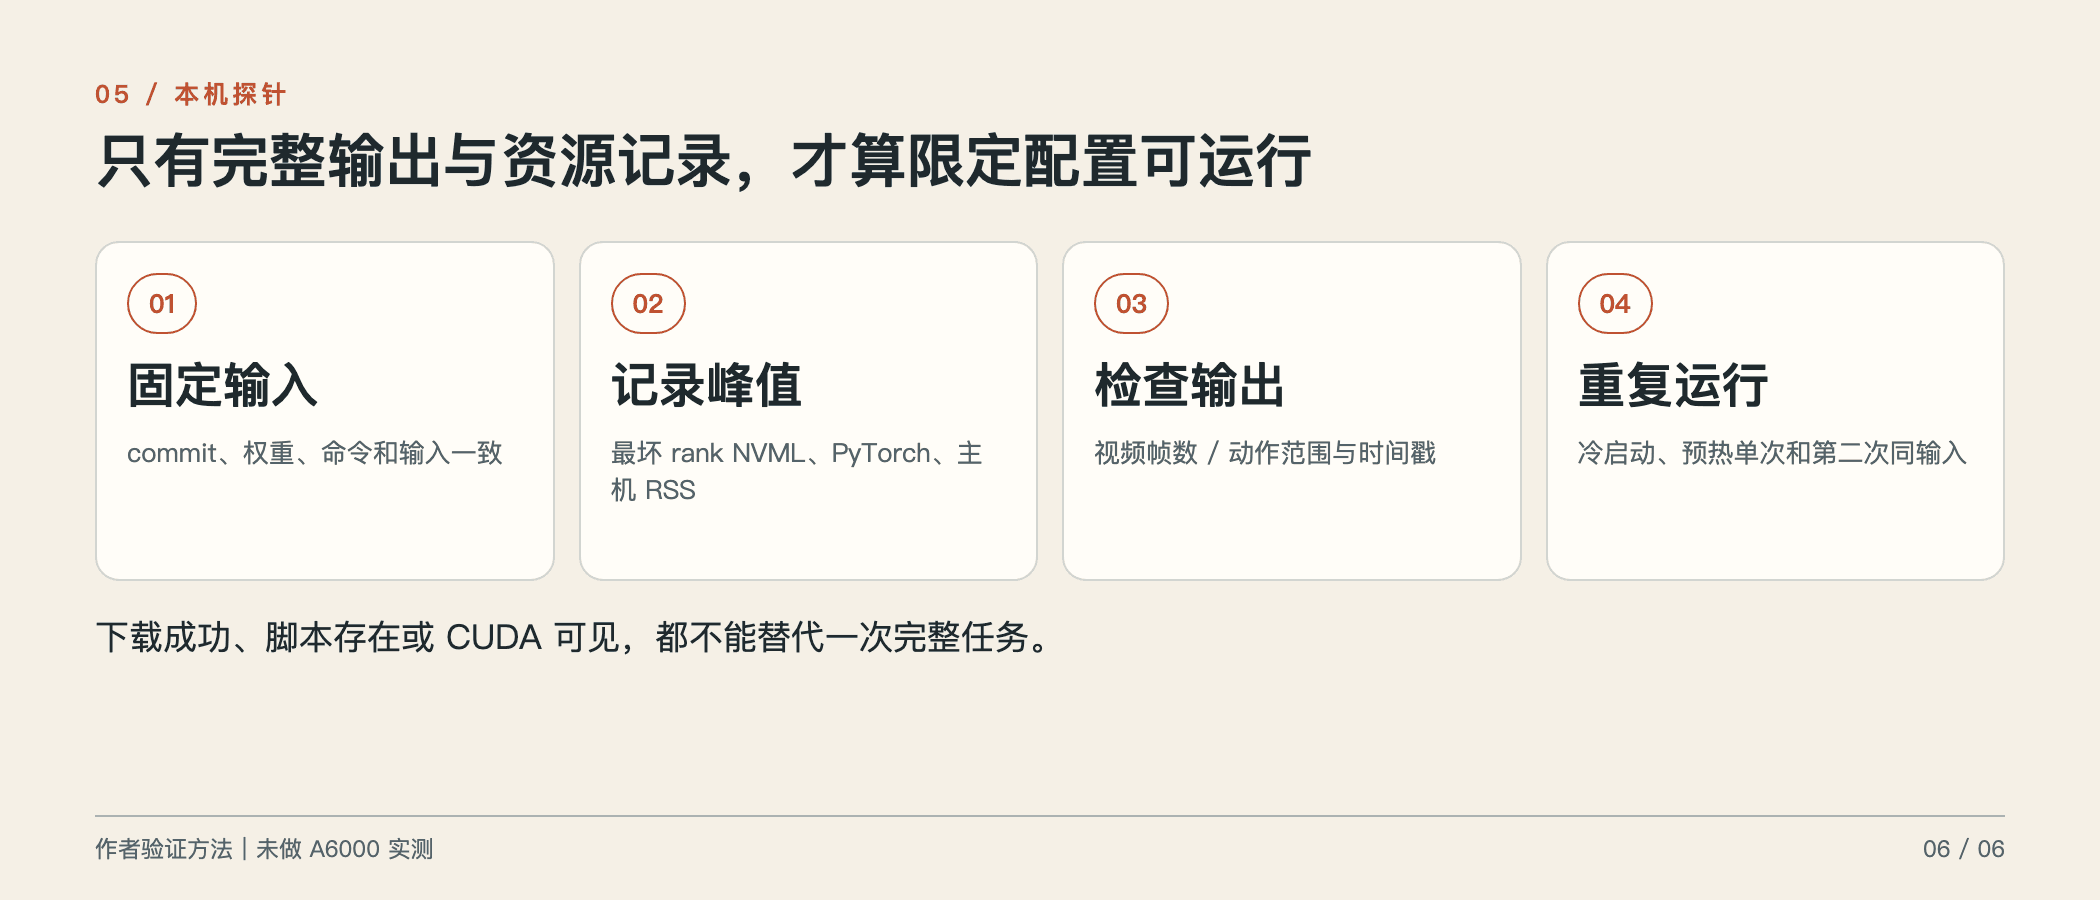
先固定每个实验的 commit、权重校验值、输入文件和命令。单卡与八卡节点分别记录 GPU 型号、驱动、互联拓扑、系统内存和软件版本;不同产品线建立隔离环境。任务从官方最小输入开始,完成后留下四组结果:
- 启动与装载:是否所有权重、CPU 依赖、分布式 rank 都正常初始化;失败在哪一步。
- 资源峰值:每卡 NVML 峰值、PyTorch 峰值、主机 RSS、磁盘余量;多卡记录最坏 rank,不只写总显存。
- 任务完成:输出视频或动作文件是否完整、参数是否与输入一致;视频要看帧数和明显异常,机器人要核动作范围与时间戳。
- 性能与复现:首个完整输出与预热后单次耗时分开;至少再次运行相同输入,保留错误日志和版本。
只有“任务完成 + 资源峰值 + 输出检查”都成立,才能报告一个限定配置下的本机可运行。下载 ACK、脚本存在、CUDA 设备可见、单次进程启动,均不足以证明这一点。没有本机 A6000 实测时,本文的结论仍是优先级和验证方案,不是兼容性清单。
用失败位置决定下一次试什么
设想八卡 MoE 探针没有输出。第一种可能是某个进程还没进入推理就退出:应先对齐各 rank 日志,查看最早出现的权重路径、依赖或设备错误,其余进程随后出现的等待超时不能代替根因。第二种可能是所有进程已经进入生成,某张卡先报显存不足:应保留失败前后的峰值和该 rank 所处阶段,对照是否真正开启了报告对应的分片路径。第三种可能是 GPU 没有报错,但系统进程被终止:应核查主机内存、退出原因和系统日志,再决定是否改装载过程。三类失败的下一步不同,统一“调小参数再试”会把关键差异抹掉。
还有一种情况最容易被当作成功:程序退出码正常,输出文件存在,却只有几帧、尺寸不对,或视频后半段出现明显损坏。此时可运行性证据不完整,应先确认输出检查和输入映射,不能把文件存在写成质量通过。机器人动作输出同样如此:数组长度正确只是格式检查,坐标、归一化、动作含义和时间对齐仍需要对应任务的证据。
为避免重复排障,每次只改变一个能够解释失败的条件。若原命令因容量失败而缩短帧数,新结果就记为“短帧数路径完成”,原目标仍待验证;若更换精度或增加卸载,也保留新的配置身份。失败记录不用藏在备注里,它决定下一位复现者应该先补环境、补容量,还是补任务接口。这样,缩小实验能够节省资源,却不会偷偷缩小对外宣称的任务范围。
如果还没有可靠的最小输出,暂停扩展并发和服务化通常更划算。这个顺序不是认为后面的工作不重要,而是前一步失败会让后一步的性能数字失去解释对象。一条完整生成记录,比十次不同配置的启动截图更能帮助你安排两台机器。
还应为探针设定事先可判断的停止条件。例如确认官方输入缺失就停止容量比较;同一配置重复出现同一初始化错误就先解决环境;任务完成但输出校验失败就停在质量检查。把停止理由写进记录,避免已经花了半天便继续叠加组件。两台机器可以分别承担单卡基线和多卡候选,结果却不应合并成一个成功率:两边任务、输入与证据层级不同。最终对照表可以很短,每行只保留任务配置、完成结果、最坏资源值及下一步。它让硬件采购或任务排期有依据,也清楚展示尚未证明的能力。
读完后如何安排时间
如果目标是尽快在单卡上看到可解释的 Video-Action 输出,从有官方 offload 显存说明的 VA 1.0 开始;如果目标是建立视频生成的本机资源基线,再测 Video Dense。若要在八卡上试大模型,先选 MoE 的无 Refiner 分片路径或 World 2.0 的公开离线脚本,各自记录失败位置与资源峰值。真实机器人控制和后训练放在模型与数据接口验证之后。
这套顺序可以被新的官方数据或本机实验推翻。它有意不给出“A6000 可跑所有 LingBot”的结论:先分清证据对应的是哪种任务和拓扑,再把本机测量接上去。
来源与核验范围
- LingBot-Video 官方推理速度与显存报告及脚本入口:基础模型、单请求、不同 CP/FSDP/FP8 拓扑;未据此推断 Refiner 或 A6000 实测。
- LingBot-World 2.0 官方仓库:14B 八卡与 1.3B 四卡离线命令、1.3B 资产依赖、部署代码公开边界。
- LingBot-VLA 2.0 官方仓库及训练配置:Policy Server、4090D 延迟、四卡训练示例与每卡约 49 GB 条件。
- LingBot-VA 1.0 官方仓库:CPU offload 条件下的单卡约 18/24 GB 场景;不外推 VA 2.0。
以上为 2026 年 9 月 26 日对官方公开文档的静态核验;没有下载权重、在 A6000 上运行、听审或真机测试。