运行 h3.c 的命令看起来很短:给模型目录、提示词、画面尺寸和输出路径,最后得到一段 带声音的视频。
短命令容易掩盖真正的工程量。一个 33B 音画模型要在 Apple Silicon 上原生执行,程序 得自己找到权重、组织文本和参考媒体、管理 GPU 内存、运行联合音画去噪、解码两套 latent,再把 RGB 与 PCM 交给 FFmpeg。通用框架过去替开发者承担的工作,现在都落到 Runtime 里。
h3.c 固定版本 8974cc0 提供了一个很适合拆解的样本。它的价值不在“用 C 重写了一个
Python 项目”,而在于源码把模型执行的阶段、数据所有权和硬件选择暴露了出来。沿着
一次 h3_generate() 调用往下看,可以得到一张较完整的原生 Runtime 责任图。
一次生成,要经过五个责任区
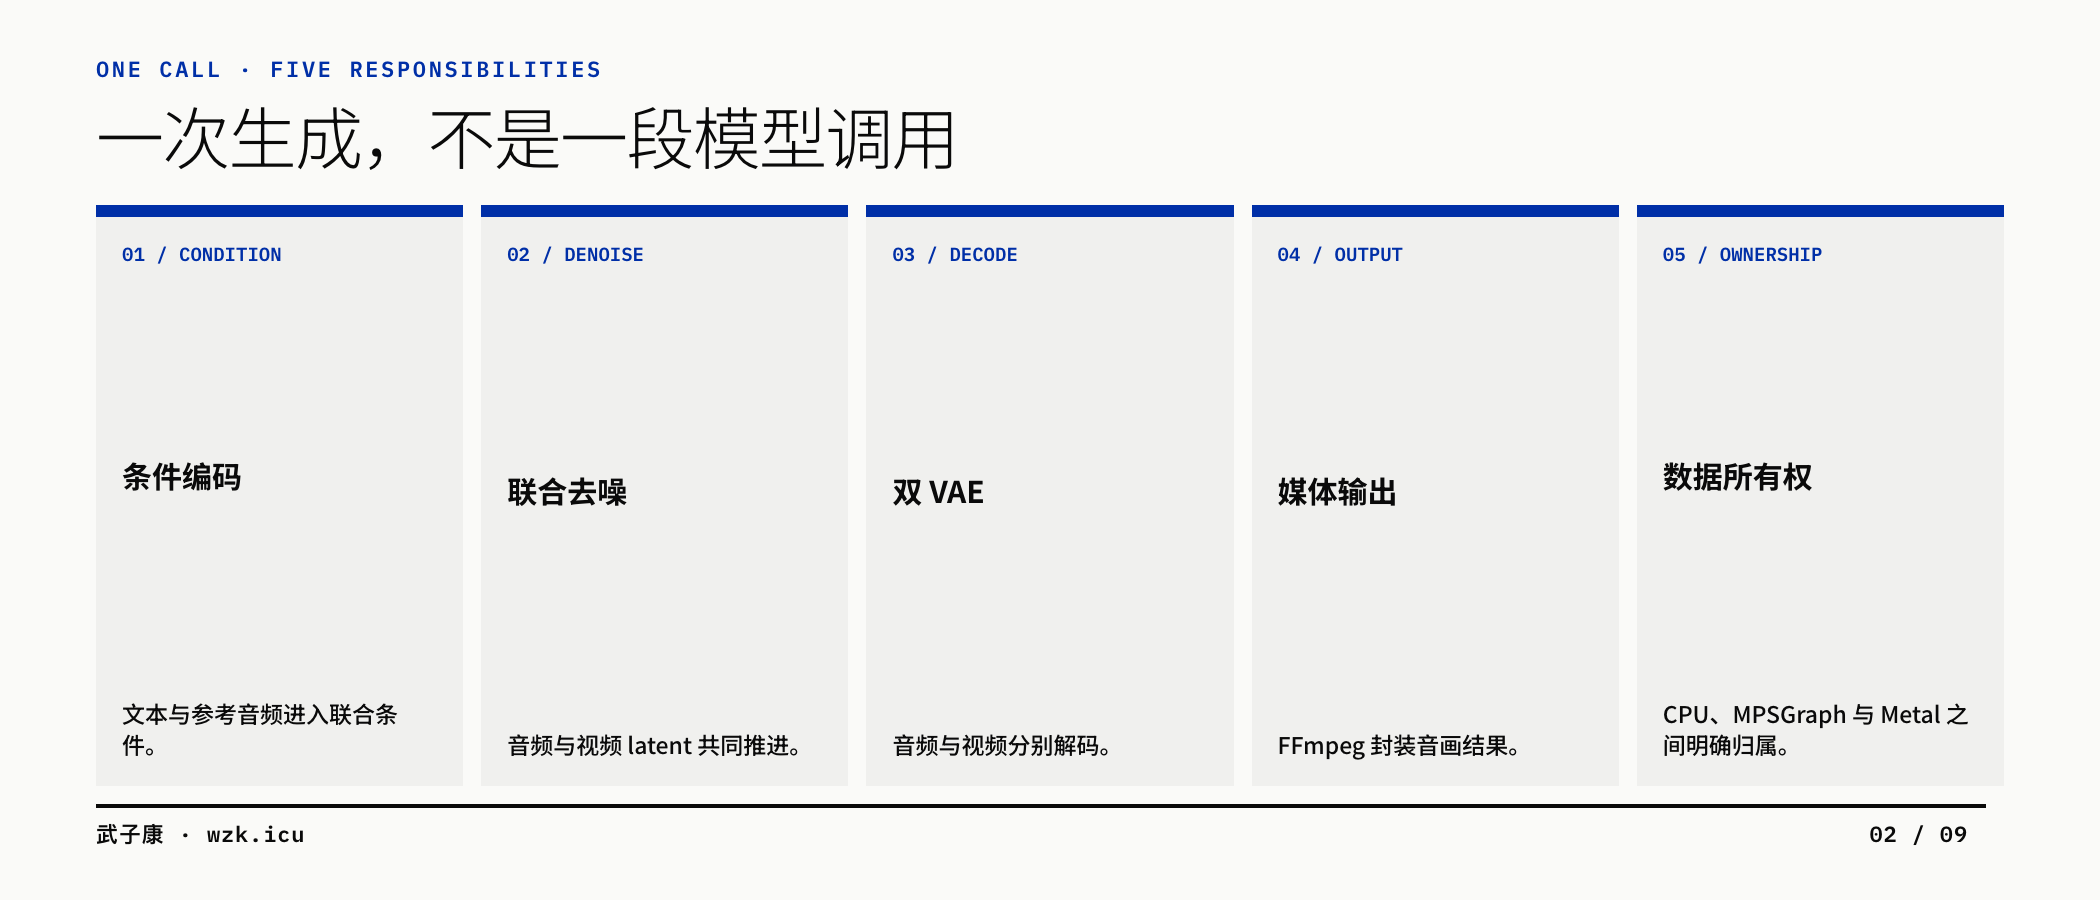
先把实现压缩成五段:
请求与模型检查
  → 条件编码
  → 联合音画去噪
  → 视频 / 音频解码
  → 媒体封装与输出
第一段检查模型目录、尺寸、帧数、模式互斥和参考素材。第二段把提示词、图片、视频或 音频转换成模型需要的条件表示。第三段构造统一序列,在 DiT 中同时更新视频 latent 与 音频 latent。第四段分别调用 VideoVAE 和 AudioVAE 解码。最后一段才交给 FFmpeg,写出 同步的视频和声音。
这五段不能混成一个“大模型 forward”。每段使用的组件不同,内存峰值不同,错误边界 也不同。把阶段分开,Runtime 才能在文本编码完成后释放一批资源,在 DiT 结束后再装载 解码器,而不要求所有权重同时常驻。
公共层用 C,Apple GPU 层留给 Objective-C
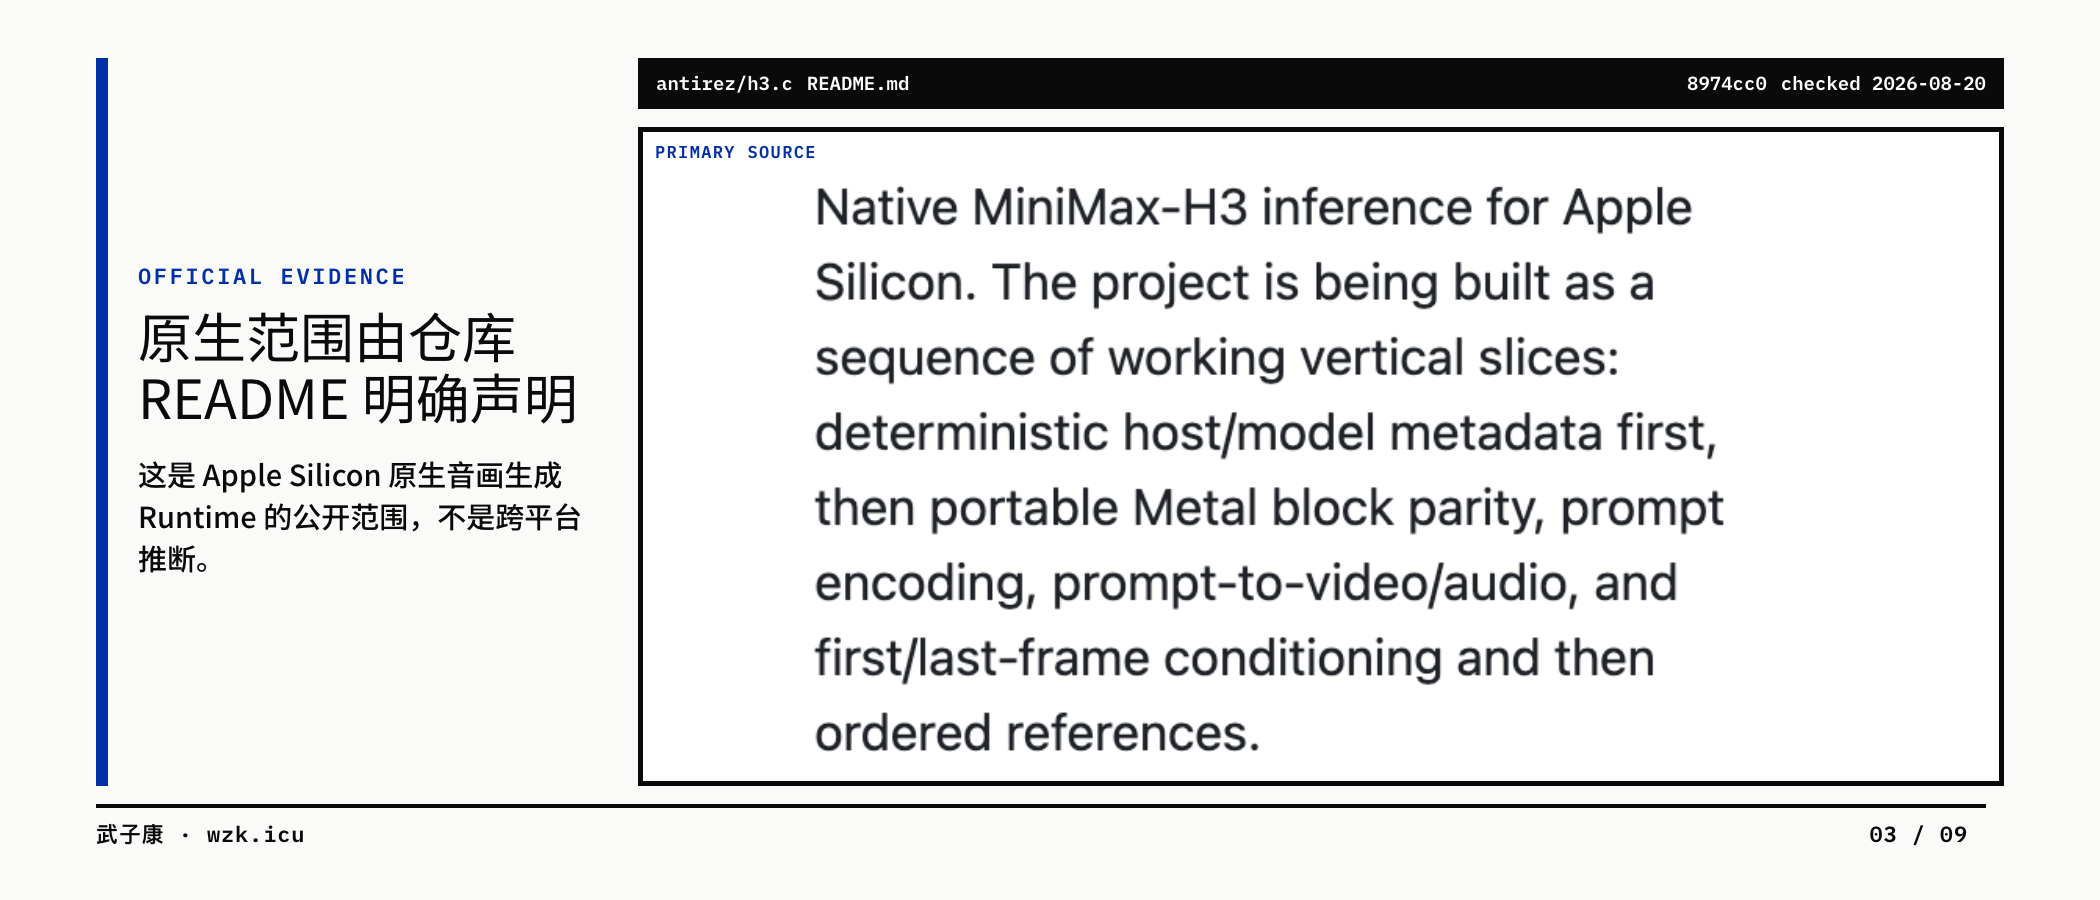
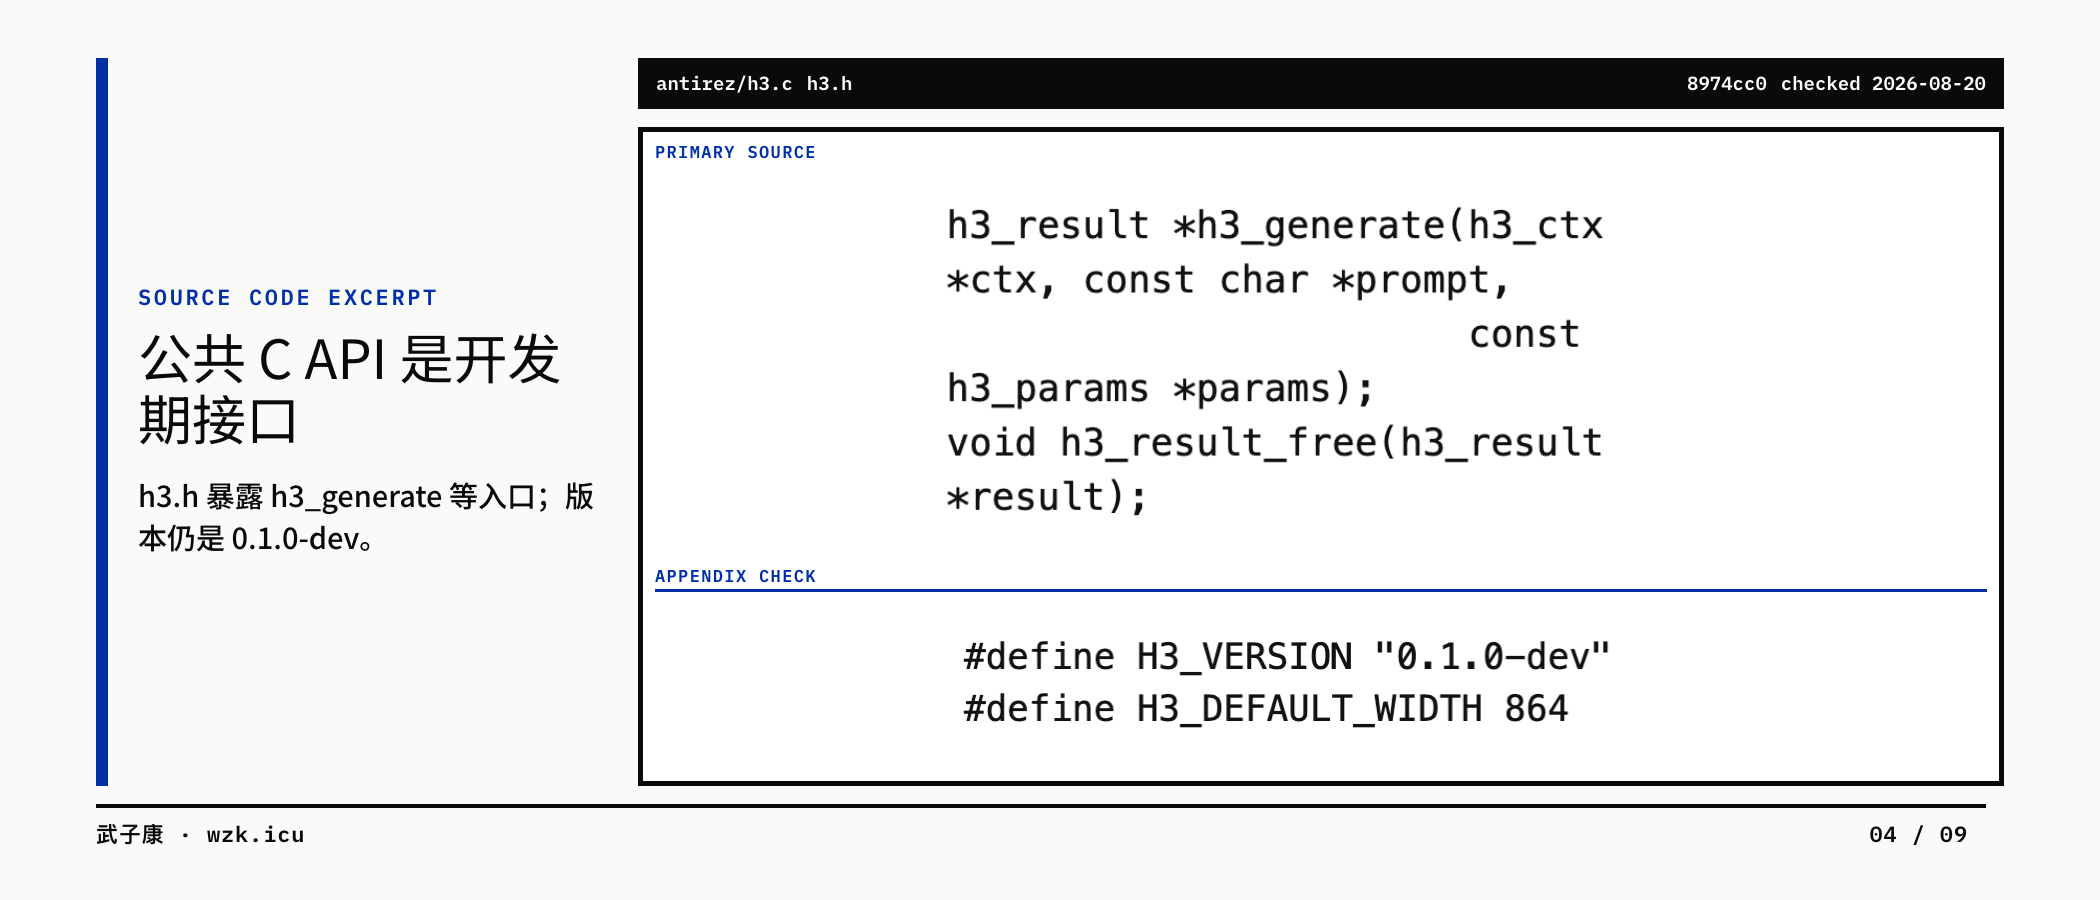
固定版本的 h3.h 声明了 h3_params、h3_model_info 和 h3_generate(),版本仍是
0.1.0-dev。调用方看到的是 C API,模型逻辑和参数合同不需要认识 Objective-C 对象。
进入 GPU 后端,情况不同。Metal、MPSGraph、command queue、buffer 和 pipeline state
都来自 Apple 的 Objective-C API,因此实现把这部分集中在 h3_gpu.m。上层 C 代码只
描述 tensor 和 operation,后端负责把它们映射到具体设备。
这个边界有两个直接好处:
- 模型编排可以被 C、C++、Rust 或 Swift 等调用方复用。
- Apple 平台细节不会扩散到权重解析、媒体布局和采样状态机。
代价也很明确。公共 API 仍处开发期,后端绑定 Apple GPU。它不是一个已经稳定、跨平台 的通用推理 ABI。
MPSGraph 和 Metal 各做什么
原生 Runtime 不等于所有算子都手写 shader。h3.c 同时使用 MPSGraph 和自定义 Metal:
| 工作 | 更适合的后端 | 原因 |
|---|---|---|
| 大矩阵乘、卷积、标准注意力 | MPSGraph | 形状常见,可利用系统图编译和设备优化 |
| AdaLN、RoPE、量化与模型特有布局 | 自定义 Metal | 需要控制融合、内存布局和中间结果 |
| M5 固定 shape 快路径 | Metal TensorOps | 能针对已知维度编译专用调度 |
如果全部交给 MPSGraph,模型特有的小算子、布局转换和图边界可能制造额外中间张量。 如果全部手写 Metal,又会重复实现成熟的大矩阵算子。混合后端的判断标准很实用:通用 大算子交给系统,模型结构中反复出现、能够稳定融合的边界才下沉到专用 kernel。
这比“Metal 一定更快”更接近真实工程。后端选择要靠同一 shape、同一输入和同一输出 边界做 A/B,不能靠技术名称判断。
Runtime 真正难管的是所有权
一个 tensor 只有 shape 和 dtype 还不够。Runtime 还要知道它的存储来自哪里、由谁释放、 是否只是另一个 buffer 的 alias、GPU 从哪个 offset 读取,以及它在当前阶段之后是否还 会被消费。
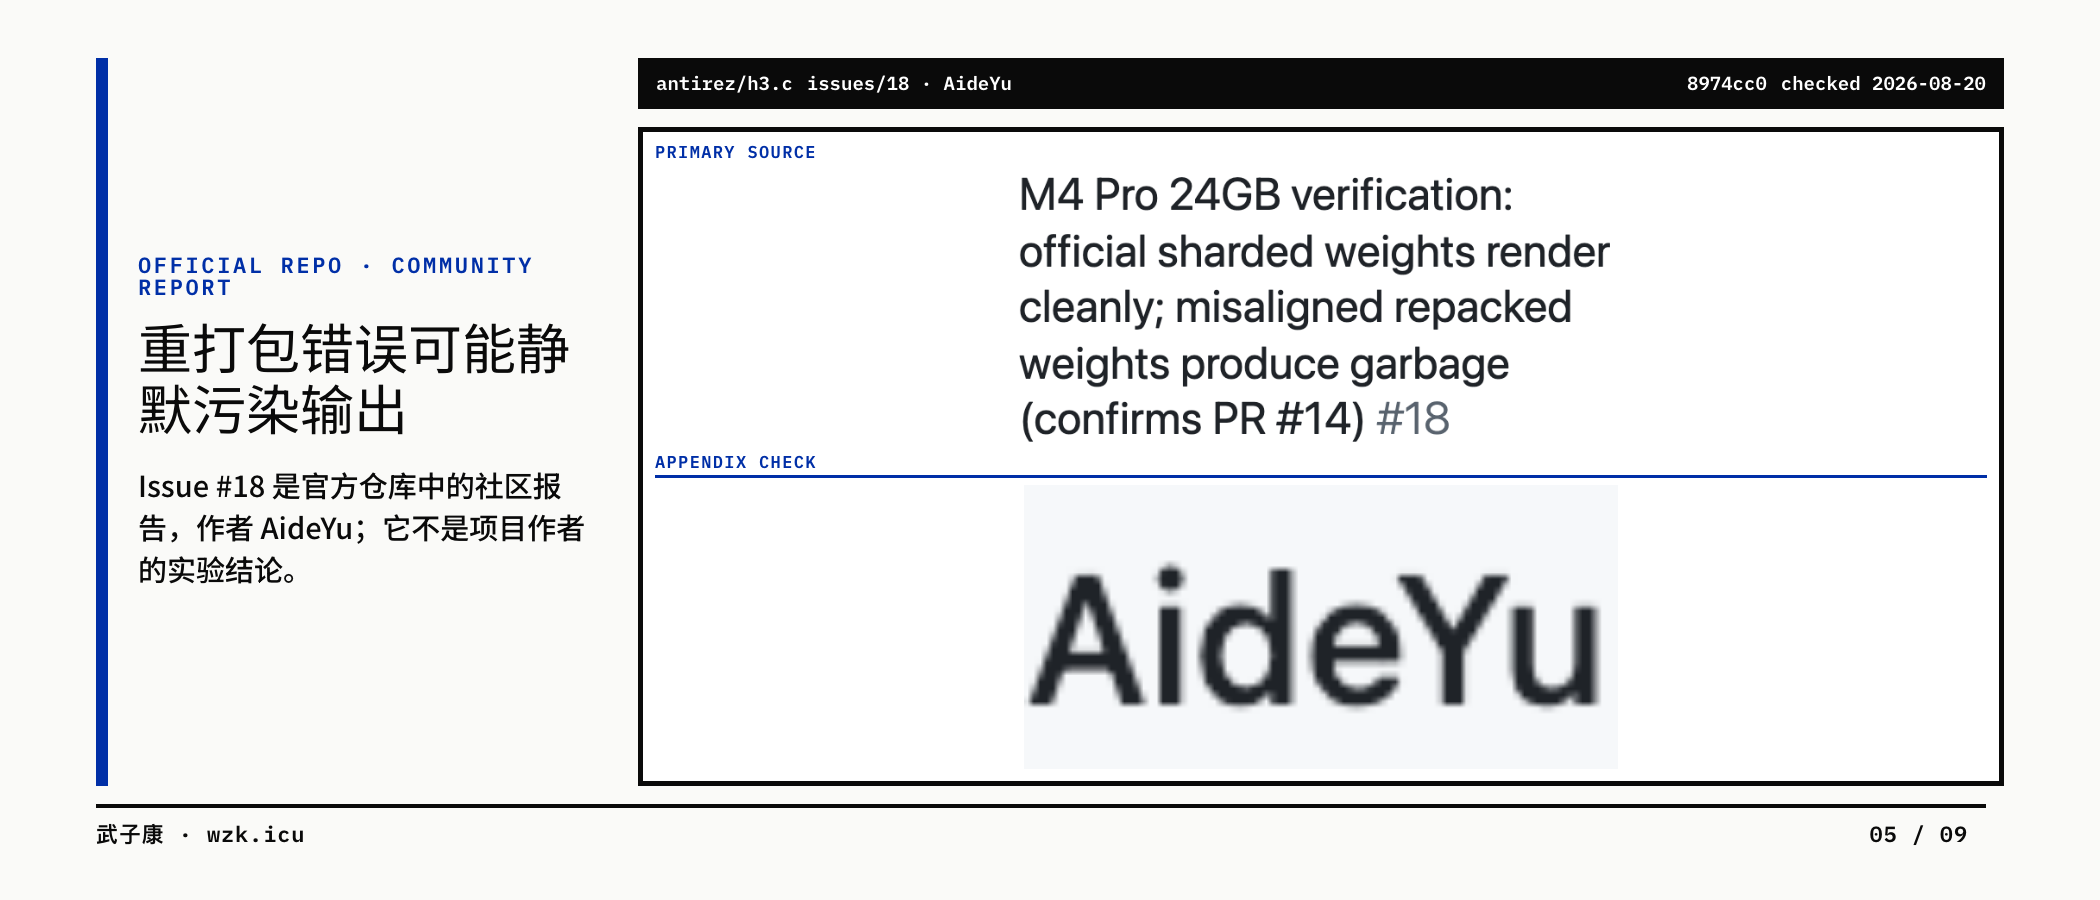
Apple Silicon 的统一内存减少了 CPU 与 GPU 之间的显式复制,却没有消除 I/O 和生命期 成本。文件映射的权重第一次访问仍可能触发缺页和 SSD 读取。buffer 还要满足对齐要求, 访问顺序会影响页缓存。官方仓库的社区 Issue #18 报告甚至说明:重打包权重若对齐不正确, 程序可能不崩溃,只是生成错误结果。
因此,“零拷贝”只能描述一段数据路径,不能替代以下问题:
- 权重是否保持 file-backed;
- 首次访问从哪里读入;
- 哪些阶段同时驻留;
- alias 是否覆盖仍会使用的结果;
- 模型或参数变化后,旧缓存是否失效。
这也是原生化的主要收益来源。开发者获得的不是更短的调用栈,而是对内存生命期的完整 控制权。
h3_generate() 是整篇源码的导航线
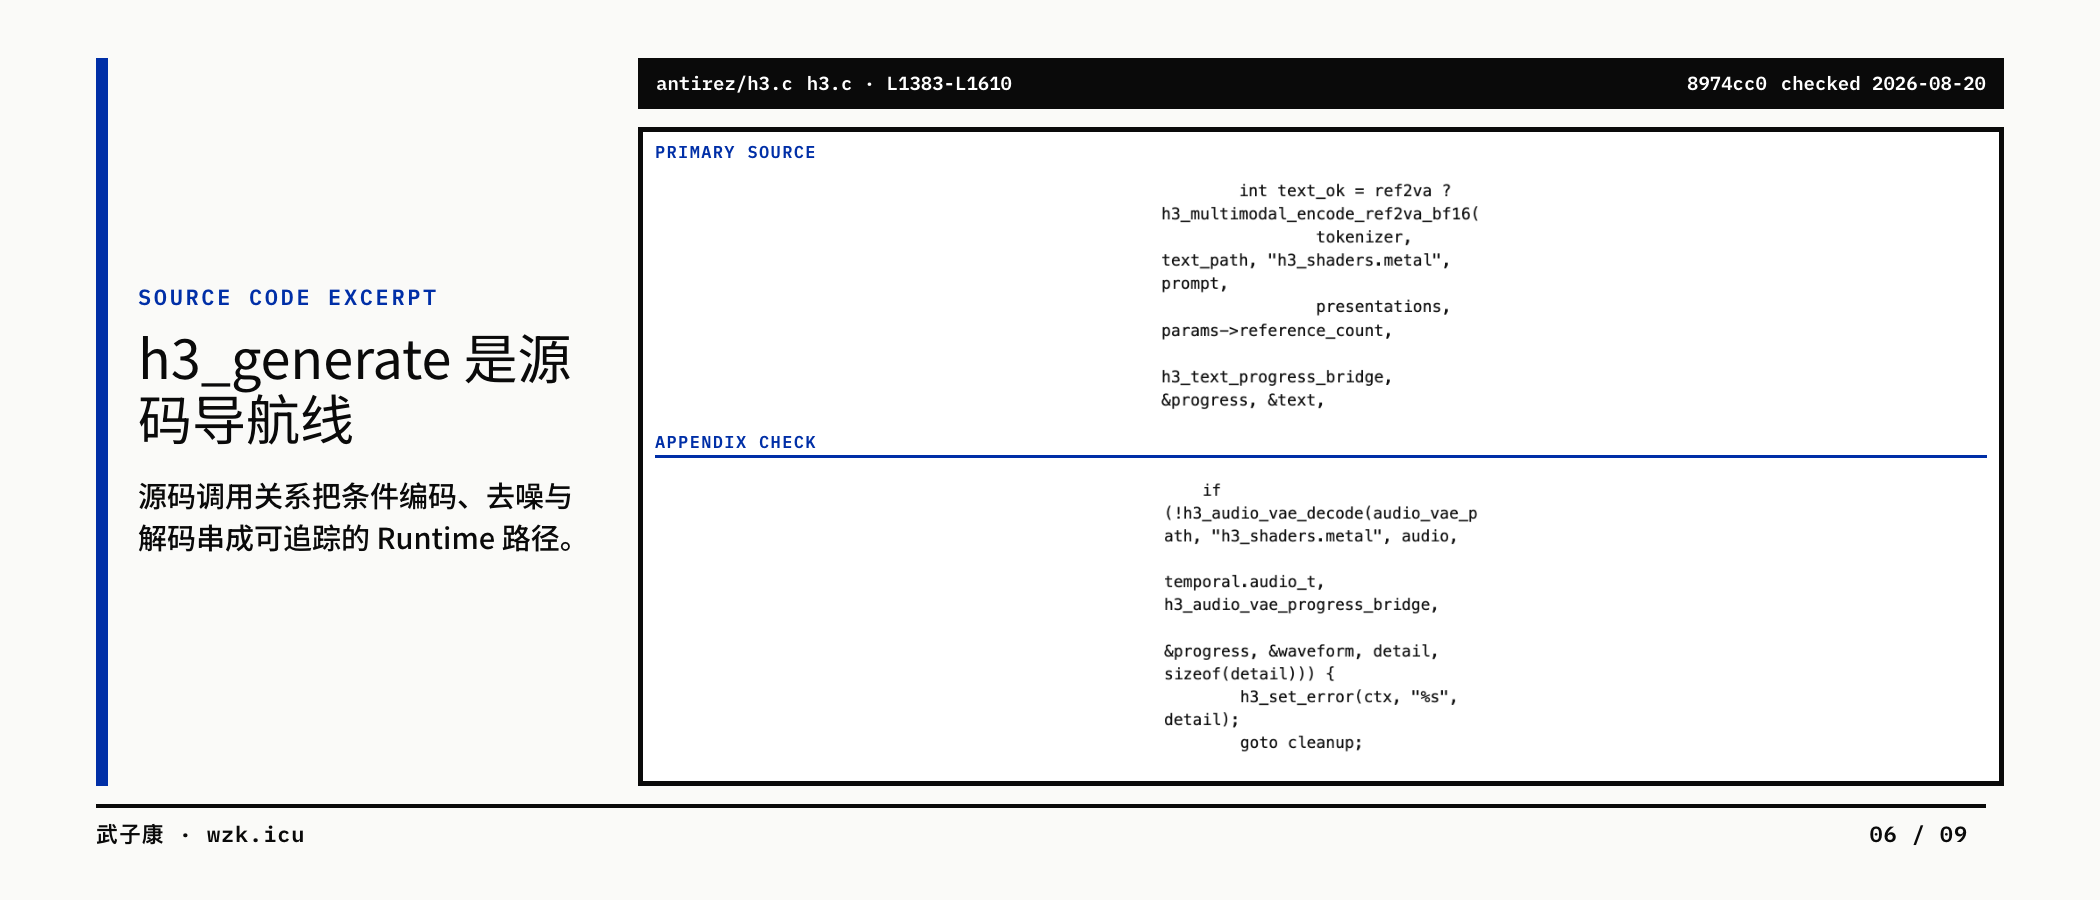
固定 h3.c 中,h3_generate() 直接连接文本编码器、视觉编码器、VideoVAE、AudioVAE、
DiT 与 FFmpeg。读源码时不必先钻进数千行 shader,可以按调用顺序建立地图:
| 阶段 | 先看哪里 | 要回答的问题 |
|---|---|---|
| 请求入口 | h3.h、h3.c | 参数、互斥、帧数和模式怎样校验 |
| 条件构造 | h3_multimodal.c、各 encoder | 文本和参考媒体怎样进入统一表示 |
| 去噪执行 | h3_dit.c、h3_dit_schedule.c | block、sigma、复用与近似开关怎样调度 |
| GPU 映射 | h3_gpu.m、h3_shaders.metal | 图算子、专用 kernel 和 buffer 怎样分工 |
| 双路解码 | h3_video_vae.c、h3_audio_vae.c | 两种 latent 怎样恢复为画面和声音 |
| 输出 | h3_ffmpeg.c | RGB、PCM、帧率和封装怎样对齐 |
这张表也是排查问题的顺序。模型目录不对,先看 inventory 和 parser。显存峰值异常,先看 阶段驻留。结果出现噪声,先查权重布局和数值 parity。视频正常但声音错位,再进入音频 解码与封装边界。不要一上来就把所有问题归因给 shader。
SSD streaming 说明了“省内存”的完整代价
README 给出的 SSD streaming 路径不会把全部 DiT 权重常驻内存。Runtime 保留少量 block slot,在 GPU 执行当前 block 时读取下一块权重。项目作者报告,在特定 M5 Max 配置上, DiT tracked storage 从约 36.5 GiB 降到约 2.0–2.1 GiB,同时 warm forward 变慢。
这里有三个限定不能丢:
- 2.0–2.1 GiB 是 DiT 的 tracked tensor storage,不是整机总内存。
- 数字来自项目作者的特定设备、画布和 warm 条件,不是本文作者本地复现。
- streaming 只改变权重驻留和读取方式,不自动解决 VAE、媒体 buffer、操作系统与预览 解码器的额外内存。
这段实现最值得借鉴的不是具体 GiB 数,而是优化合同:省了哪一类存储,增加了多少 I/O, 哪些计算能够遮住读取等待,结果是否与 full-residency 路径一致。缺少其中任何一项, “省内存”都可能只是把成本挪到别处。
原生 Runtime 仍然有清楚的边界
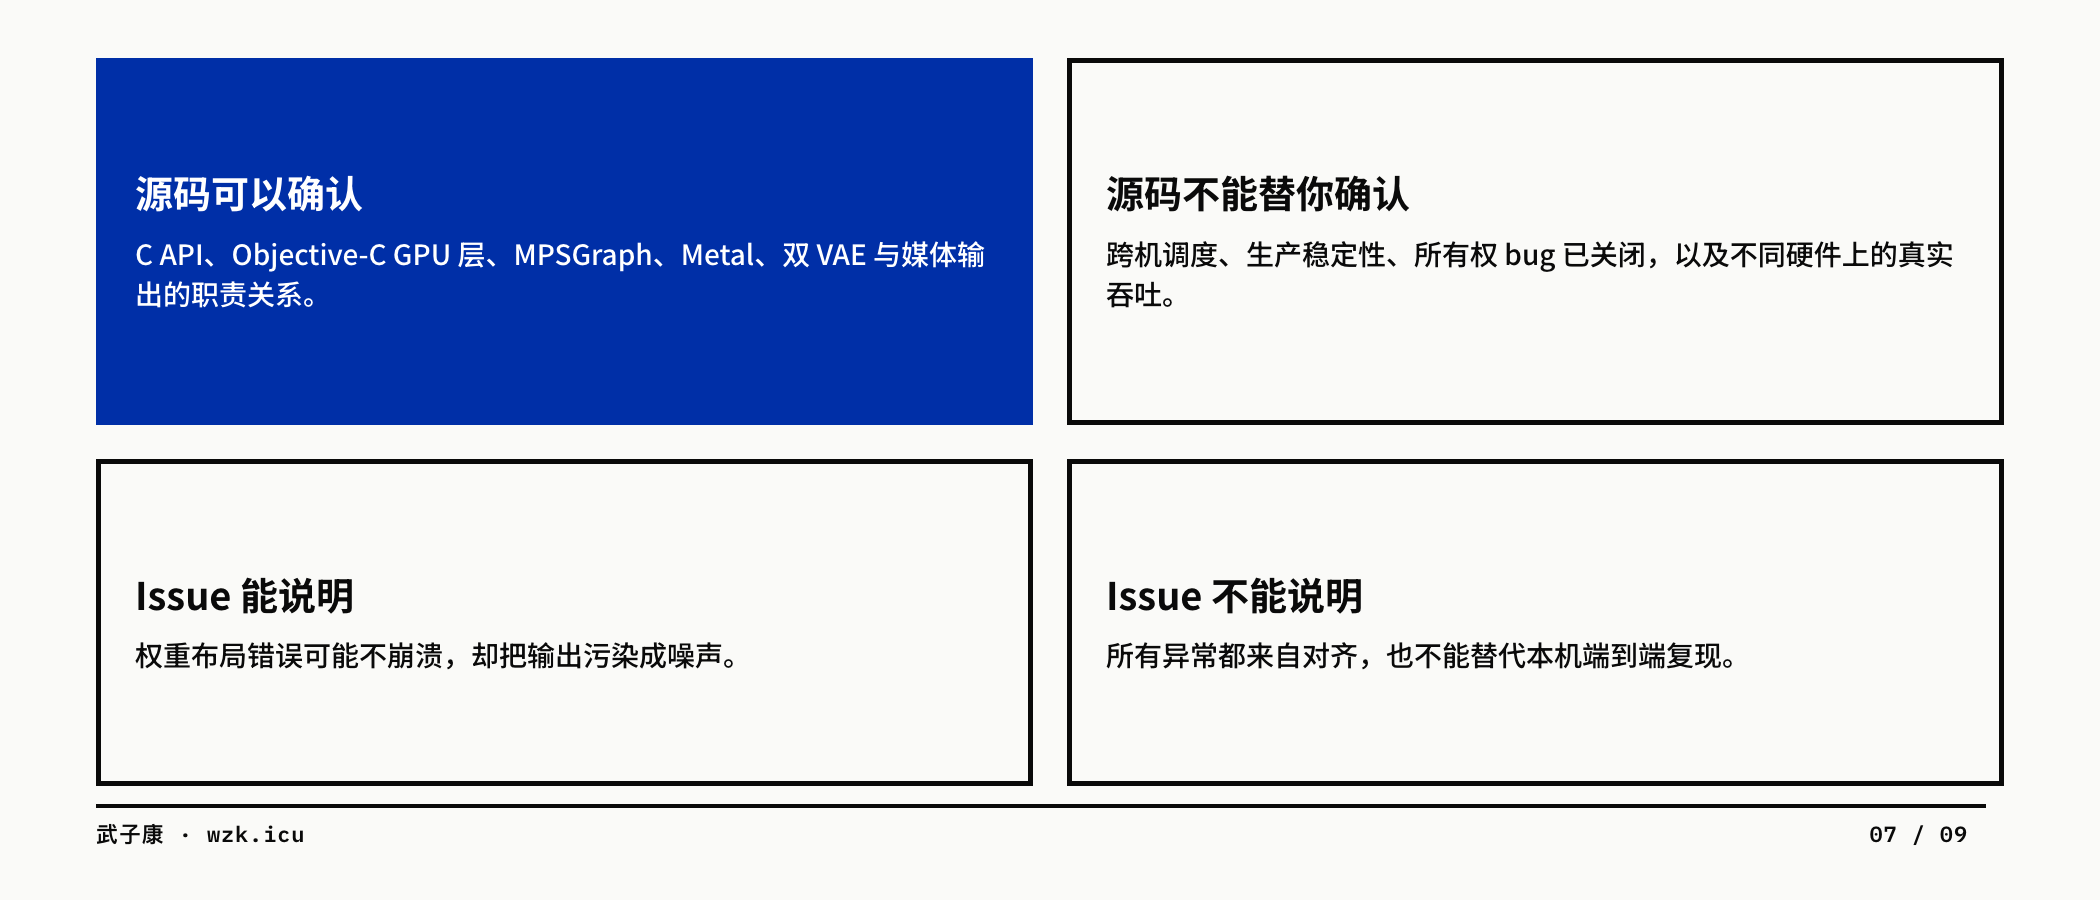
h3.c README 表明 prompt-to-video/audio、首尾帧条件和 ordered references 已能端到端工作。 这证明仓库不是只有 parser 或单算子实验。它仍不等于完整的 MiniMax H3 产品系统,也不 等于多租户模型服务。
固定版本能确认的是:
- 开放权重 H3 路径的本地原生执行;
- Apple Silicon 上的模型专用后端;
- 单次与交互式生成所需的缓存和媒体链路;
- 项目作者公开的特定硬件测量与数值检查。
本文没有在本地下载数十 GiB 权重并运行生成,没有做画质盲测,也没有验证多租户并发、
服务恢复或生产稳定性。状态应保持 NOT_RUN_H3C_LOCAL_RUNTIME,本地性能保持
UNKNOWN_LOCAL_PERFORMANCE。
最后留下两张工程表
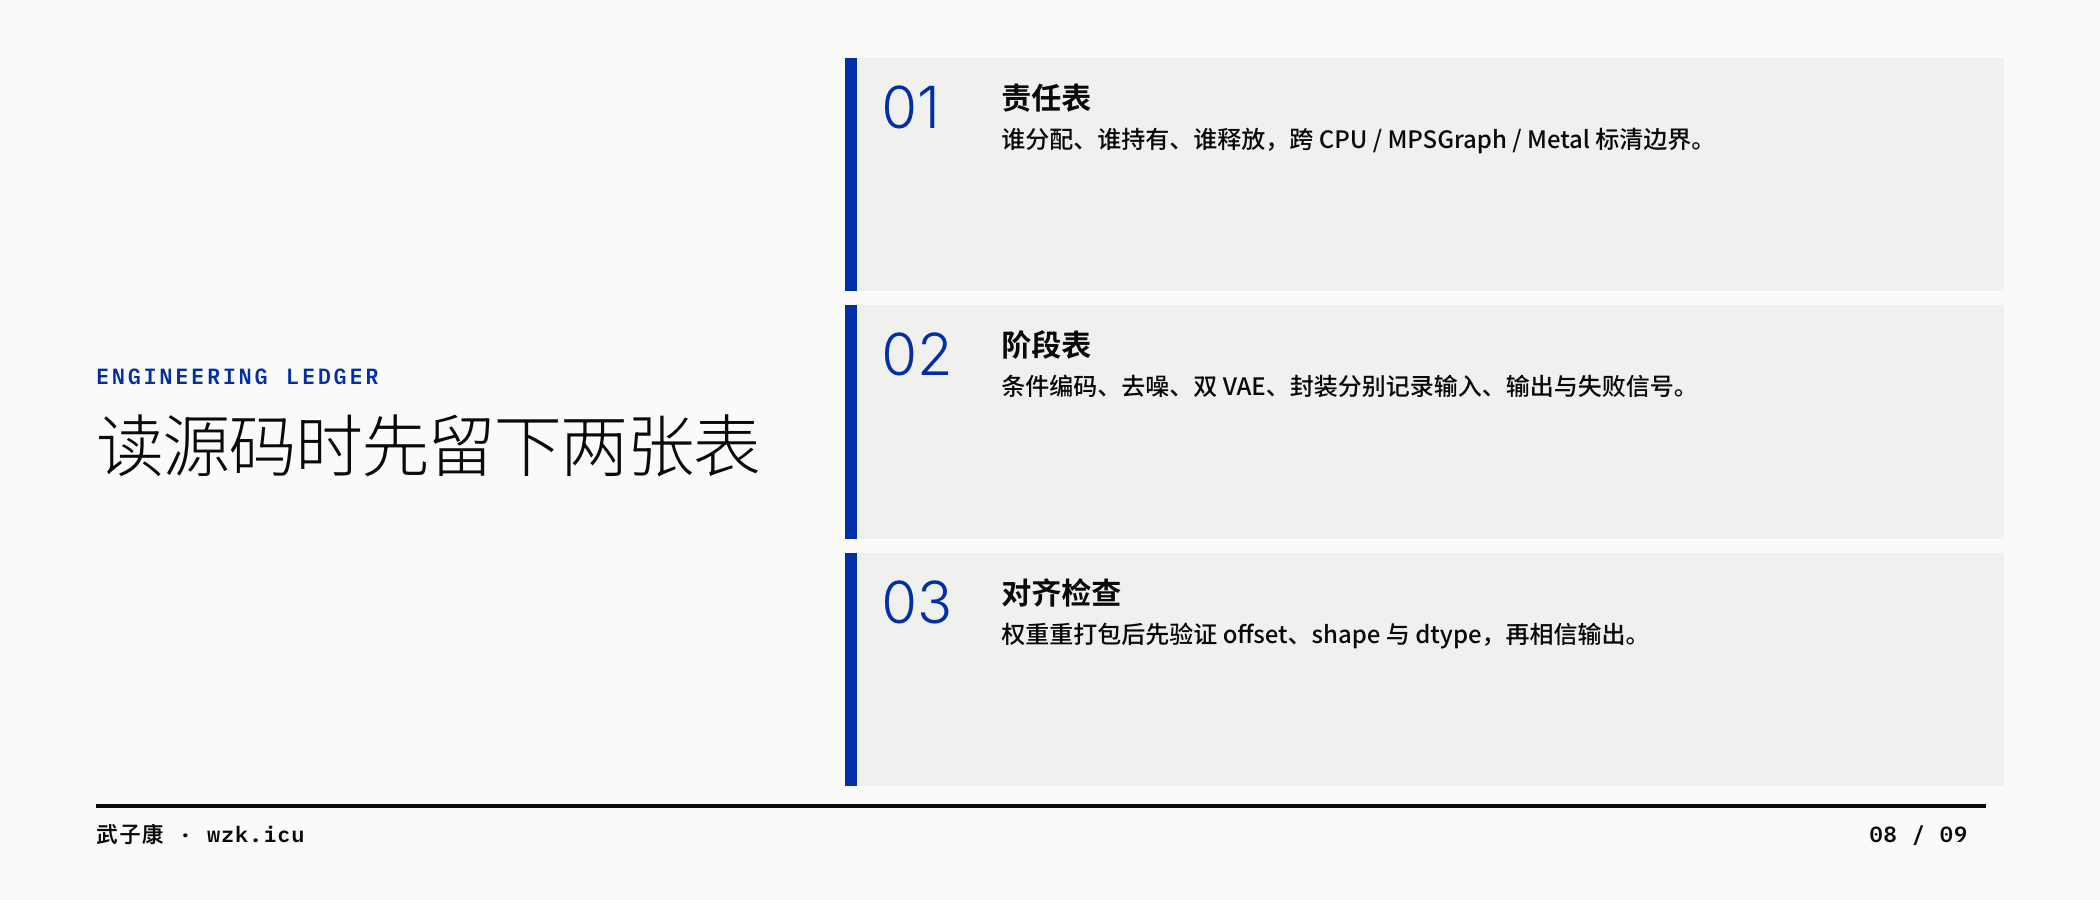
读完 h3.c,最有用的产物不是“C 比 Python 快”这句话,而是两张表。
第一张是阶段图:请求检查、条件编码、联合去噪、双 VAE 解码、媒体输出。它决定组件何时 装载、何时释放、错误在哪一层结算。
第二张是源码导航表:公共 API、模型编排、GPU 后端、专用 kernel、VAE 和 FFmpeg。它让 性能、内存和结果错误都能落到具体责任区。
当一个 Runtime 能明确回答“谁拥有这块数据、下一个消费者是谁、失败在哪一层结束”, 原生化才产生了工程价值。语言只是实现选择,阶段与所有权才是系统设计。
参考资料
- antirez/h3.c 固定源码:https://github.com/antirez/h3.c/tree/8974cc055ea9c02fcd14cc27dfda3e1027c05153
- 固定 README:https://raw.githubusercontent.com/antirez/h3.c/8974cc055ea9c02fcd14cc27dfda3e1027c05153/README.md
- 固定公共 API:https://raw.githubusercontent.com/antirez/h3.c/8974cc055ea9c02fcd14cc27dfda3e1027c05153/h3.h
- 固定主编排:https://raw.githubusercontent.com/antirez/h3.c/8974cc055ea9c02fcd14cc27dfda3e1027c05153/h3.c
- 官方仓库社区报告 Issue #18(AideYu):https://github.com/antirez/h3.c/issues/18
证据边界
- 固定源码中的 API、模块和调用关系:
SOURCE_VERIFIED。 - README 中的硬件、速度、内存和质量数据:
AUTHOR_REPORTED。 - 阶段图、责任区和排查顺序:作者工程分析。
- 本地 Apple Silicon 运行、画质盲测、多租户服务与生产稳定性:
NOT_RUN / UNKNOWN。