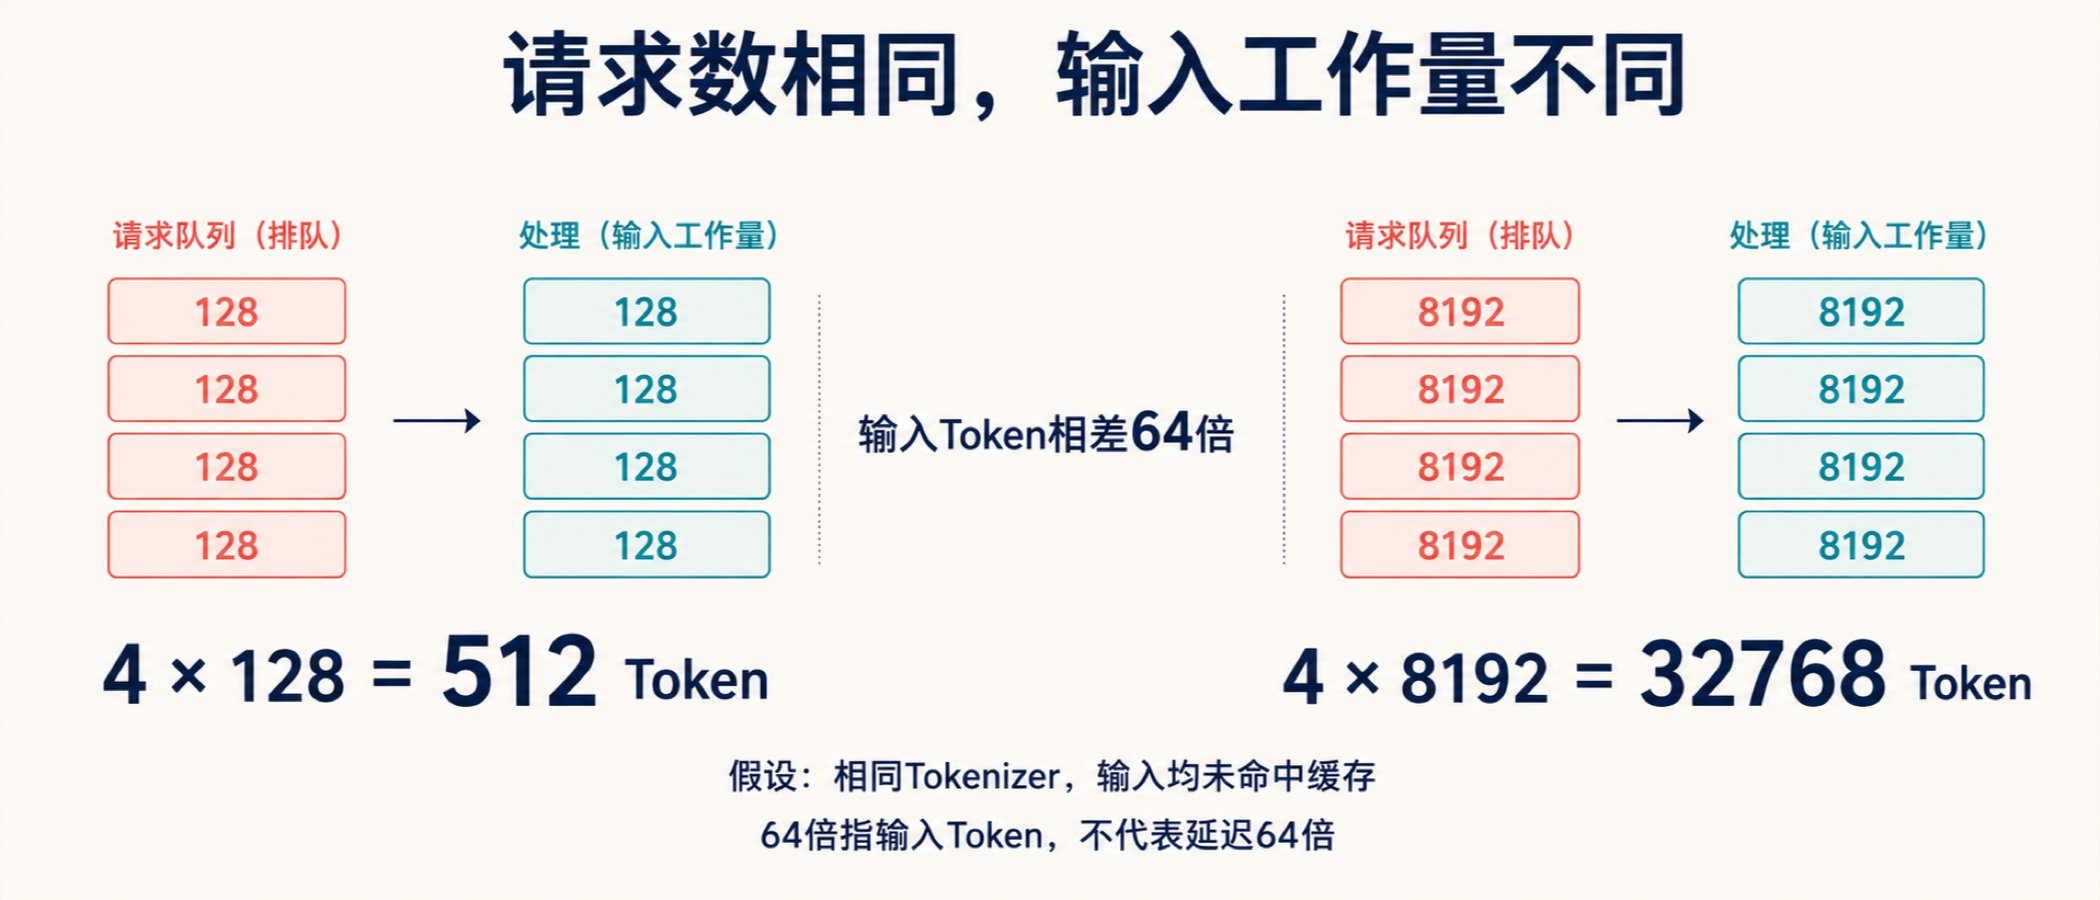
两份模型副本都显示“等待请求:4”,轮询路由看起来很公平。可 A 排着四条短问句,B 排着四份长文档。如果按相同 Tokenizer 计数,A 的每条输入是 128 Token,B 是 8192 Token,而且都没有可复用前缀,那么等待处理的输入分别是 512 和 32768 Token,相差 64 倍。
这不是“B 的等待时间必然是 A 的 64 倍”。真实耗时还取决于模型、批次、已在运行的生成和调度方式。这个手算只证明:请求数相同,不能推出剩余工作相同。多复制几份模型之后,服务仍可能一边排长队、一边留着余量。
Data Parallel(数据并行,简称 DP)在在线推理里的价值,是让不同请求进入不同模型副本。本文关注同一 Dense 模型的独立副本:怎样把新增副本变成可用服务能力,以及为什么“队列最短”和“缓存最热”都不能单独决定请求去向。文中数字是明确假设下的推导,不是 GPU 压测结果。
先确认路由背后有几份完整的服务能力
训练里的 PyTorch DistributedDataParallel 通过同步各副本梯度维持训练一致性。输入怎样划分仍由使用者负责,DDP 不自动替你切分样本。在线生成没有这轮反向梯度同步,不能把训练 DDP 的通信图直接搬过来解释独立推理副本。PyTorch DDP 文档
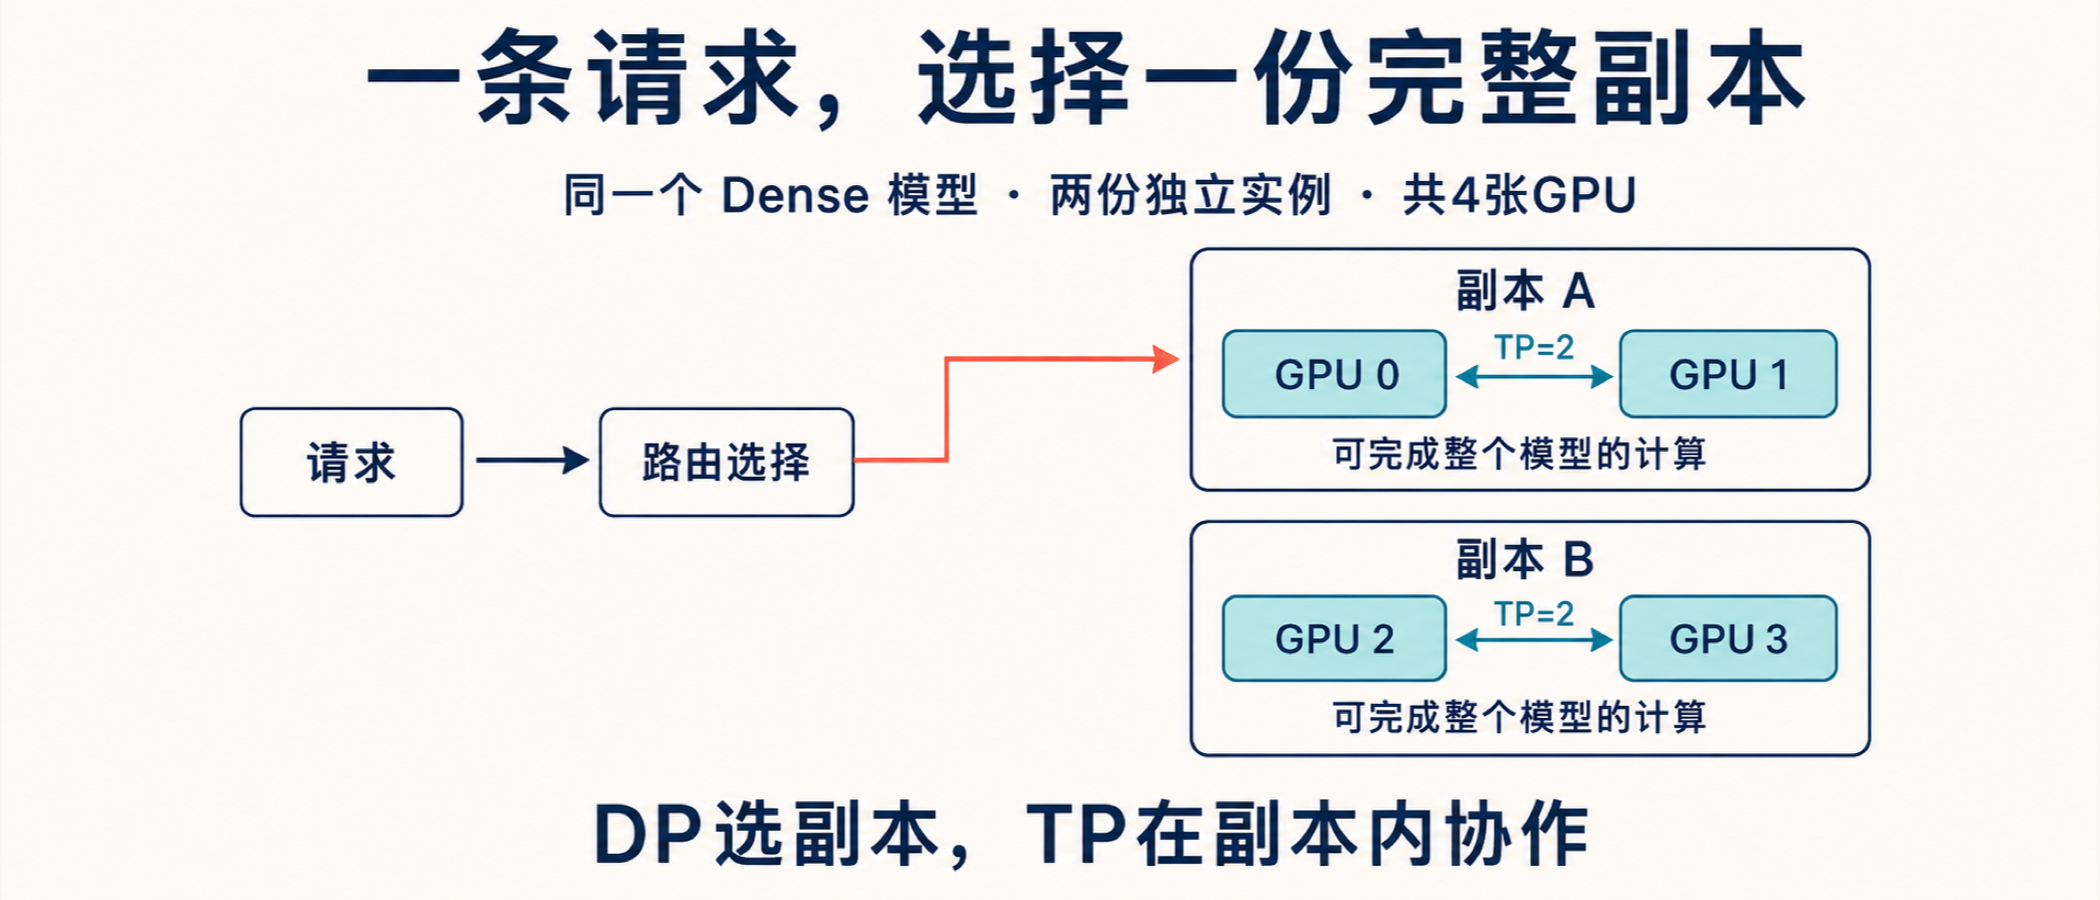
一份推理副本可以用一张 GPU,也可以由 TP 或 PP 组共同执行模型。例如,两份彼此独立的服务,每份使用两卡 TP,总共四张 GPU。路由器把一次请求送到其中一份,再由该副本内部的两卡完成计算。副本数量与 GPU 数不是同一个数。复制服务也不能让原本装不下的那一份模型自动装下。
相同模型的请求流
        ├─ 副本 A:两卡 TP,自己的请求与缓存状态
        └─ 副本 B:两卡 TP,自己的请求与缓存状态
一次请求选择一份副本。副本内部继续按 TP 执行。
在当前 vLLM 文档中,Dense 模型的外部副本方式是启动独立实例,由外部路由器分发 HTTP 请求,无须添加 --data-parallel-* 参数。不要把面向 MoE 的 external DP 参数当作“只要有多个服务就必须加”的通用开关。vLLM External Load Balancing
MoE 是这里必须留下的边界:vLLM 的某些 DP Attention 与专家并行组合仍需跨 Rank 对齐前向并同步专家层。看到 DP Rank 数增加,不能据此判断多了几份完全独立的故障域。vLLM Data Parallel Deployment
本文后续的 A、B 指可以独立服务的 Dense 副本,不把上面的耦合组、远程 KV 传输或 Prefill/Decode 分离混在同一个例子里。接入路由前,先核对端点背后的模型、版本、Tokenizer、Adapter 与完整执行组,避免把能连通的地址误算成可替换的服务能力。
请求数只给出数量,剩余工作决定等待
回到开头的四条请求。512 与 32768 是未命中前缀时的输入 Token 总量,只能粗略提醒 Prefill 工作可能不均。Prefill 是处理输入并建立相应状态的阶段。Decode 则逐步生成后续 Token。后者的最终输出长度通常在请求进入时未知,用户设置的最大输出长度只是上限。
即使 A 没有等待请求,它也可能正在为多条长回答持续 Decode。B 虽然有等待请求,却可能很快释放正在运行的序列。只数排队项漏掉了运行中的工作。只数 HTTP 连接,又把短回答、长回答和慢客户端混成同一种负载。
因此,路由需要把几种信号放在一起理解,而不是将其中一个直接改名为“剩余容量”:
| 路由看见的信号 | 它能提示什么 | 它没有回答什么 |
|---|---|---|
| 等待与运行请求数 | 请求积压在哪里 | 每条还需要多少计算 |
| 输入长度、可复用前缀估计 | 可能要补算多少输入 | 后续输出会持续多久 |
| KV 使用情况 | 状态存储是否接近约束 | 计算是否空闲、排队是否可接受 |
| 最近的首 Token 等待与完成速率 | 近期服务结果是否恶化 | 此刻新请求一定会怎样 |
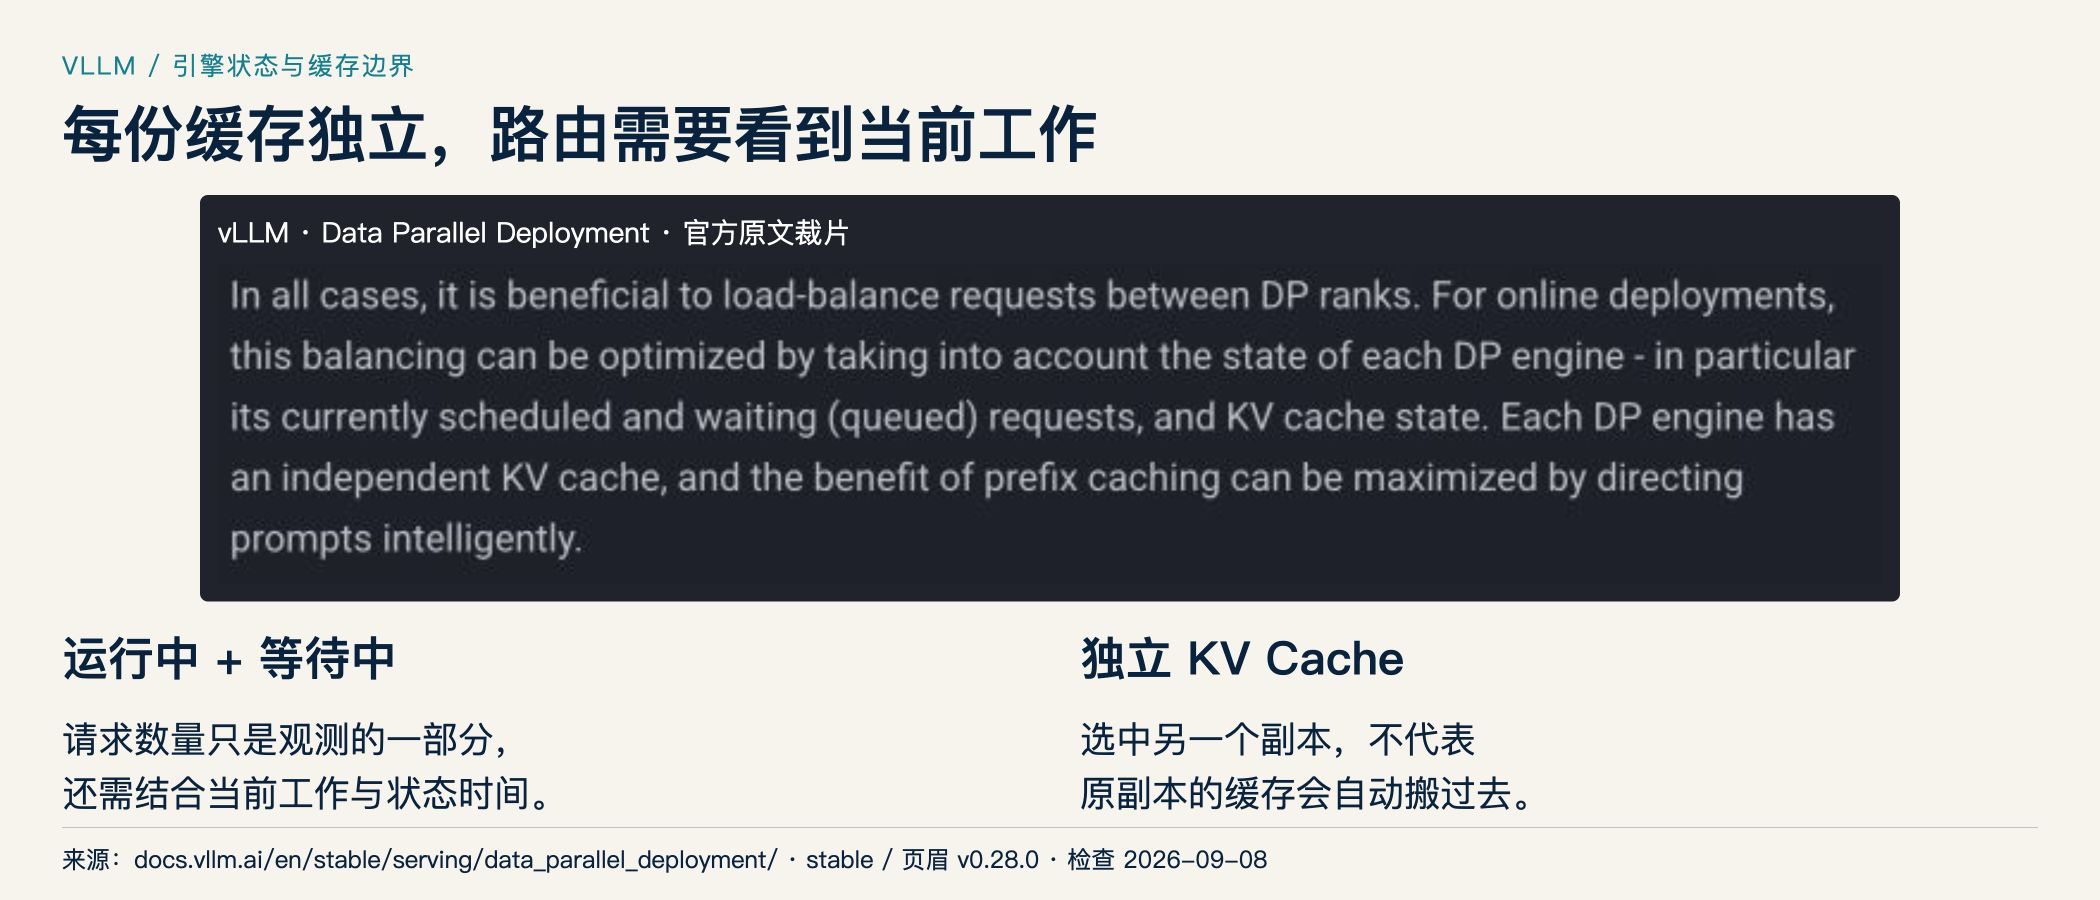
vLLM 的 DP 部署说明也把正在调度的请求、等待请求和每个引擎的 KV 状态列为负载均衡可考虑的信息。vLLM DP 状态说明
这些信号之间没有普适的线性换算:多一个等待请求不总是增加固定毫秒,高 KV 使用率也不等于同样高的算力利用率。比较时还要确认指标口径相同、采样时间足够新。如果两个副本的“队列长度”一个包含运行项、一个不包含,数值越精确,反而越容易把路由带偏。
对于长度相近、没有明显热点的请求,轮询仍是值得保留的基线。引入更复杂的评分,必须能证明它改善了实际等待或目标内完成量,而不是只让看板上的请求数更整齐。
缓存最热的副本,也可能最晚给出首个结果
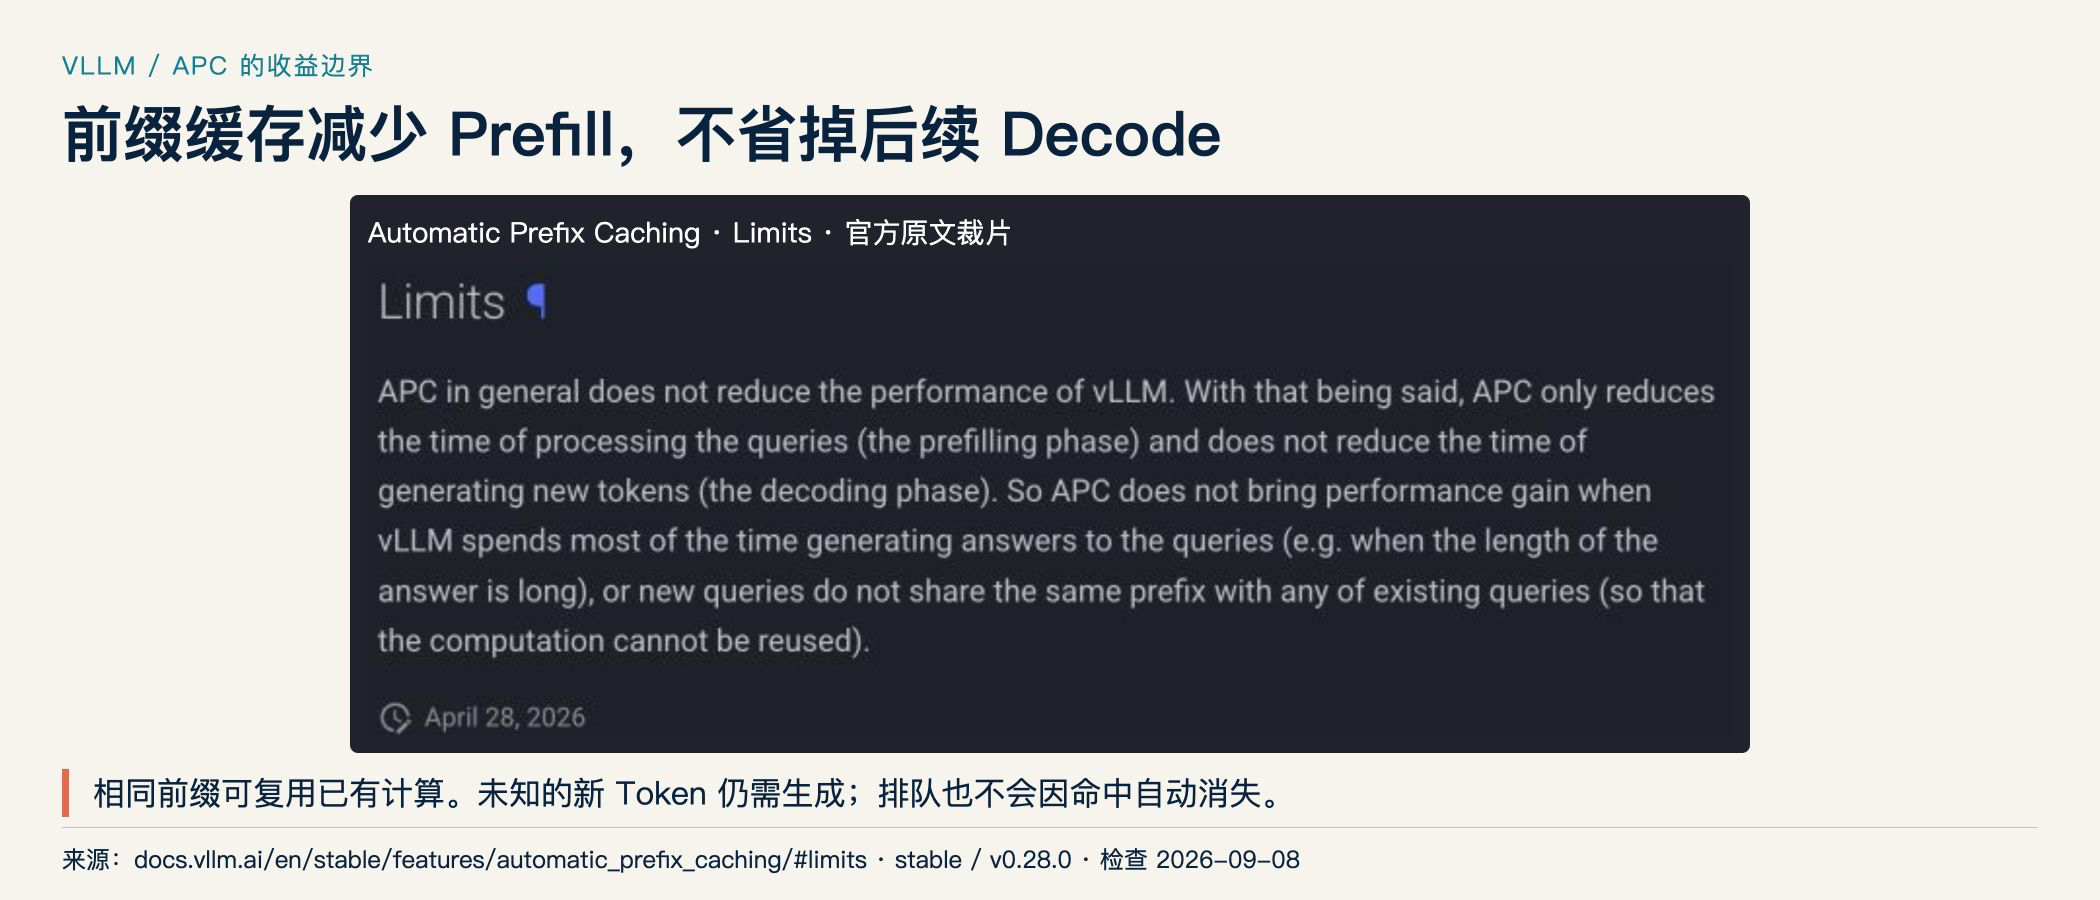
同一轮对话的后续请求,可能在 A 找到仍然有效的前缀 KV,而 B 没有。vLLM APC 可以复用匹配前缀的计算,减少 Prefill 工作。它不会替请求生成尚未生成的新 Token,所以不能把命中率提高直接解释成 Decode 一定加速。vLLM Automatic Prefix Caching
在独立缓存部署中,把请求送到 B 并不自动带走 A 的 KV。B 仍可能命中它自己的部分前缀。如果没有可用命中,就要补算相应输入。前缀也可能被淘汰,历史上发给 A 不等于这次一定命中。这里讨论的是下一次请求的目的地选择,不是在途生成的透明迁移。
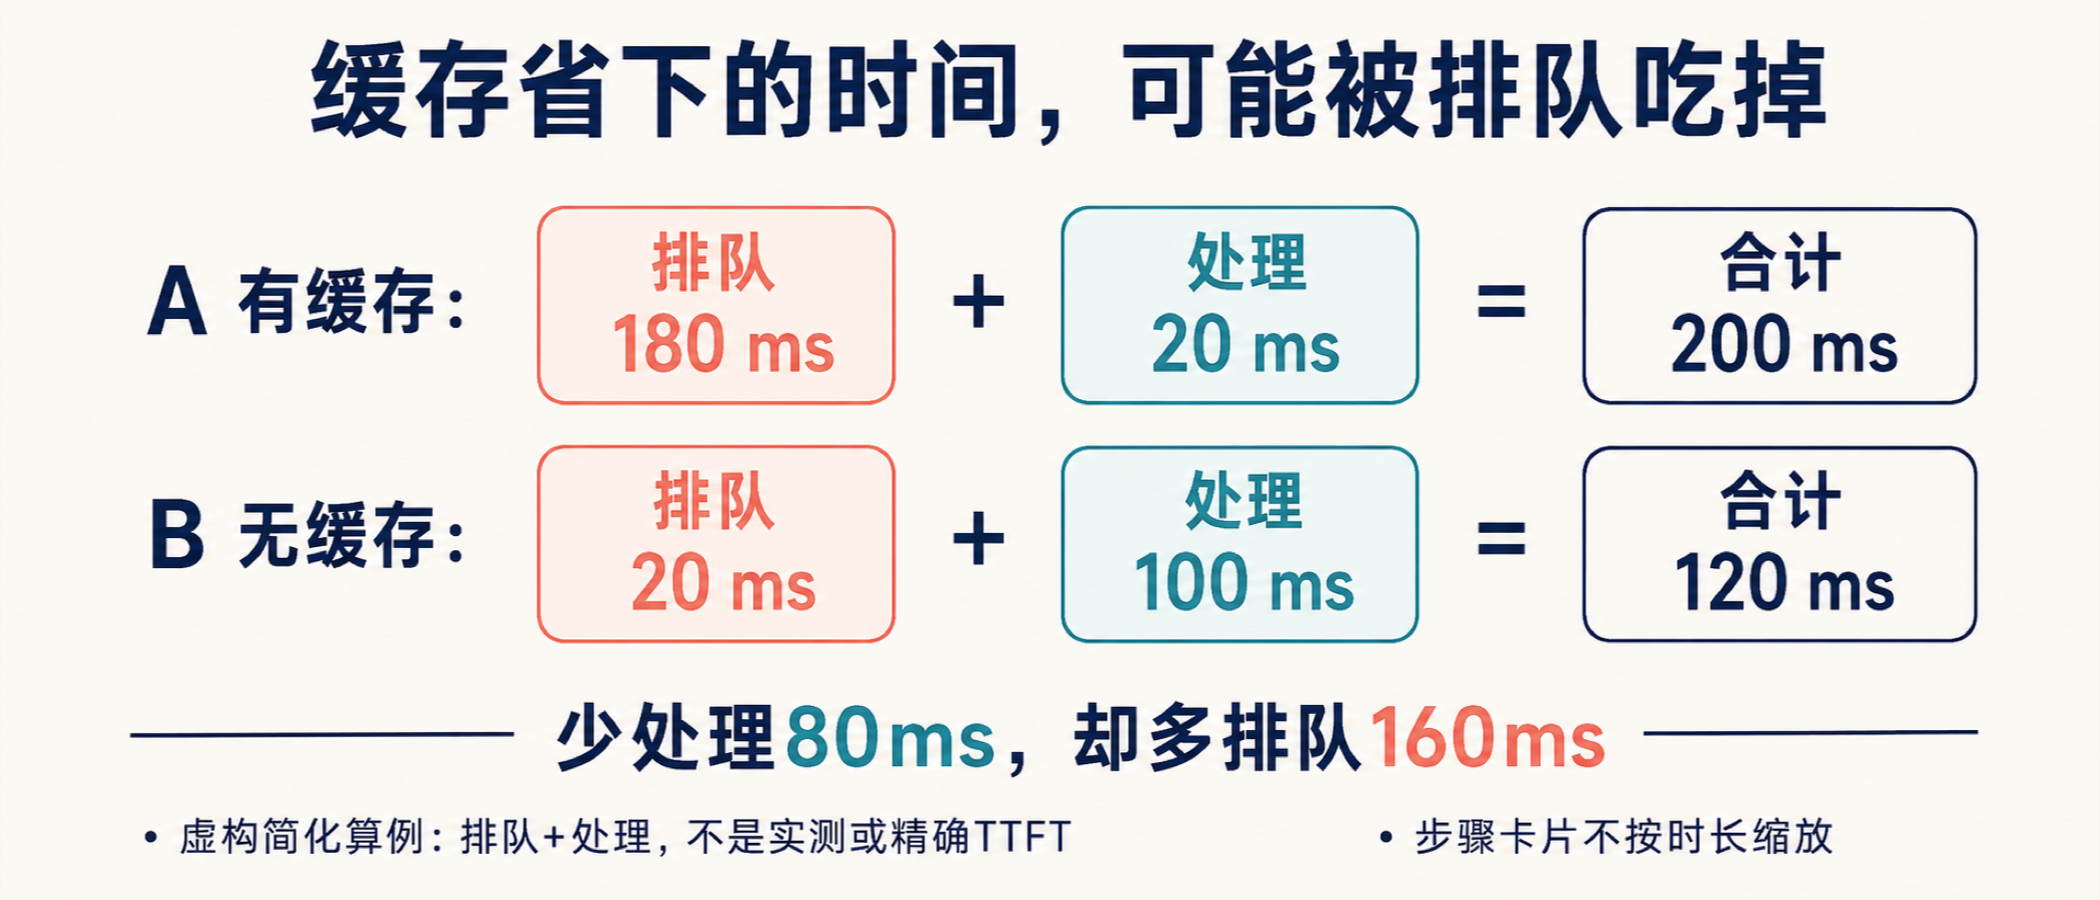
可以用一个局部时间模型理解这个取舍。令 Q 表示该请求开始获得有效处理前的等待估计,P 表示随后到首 Token 的处理估计。暂时忽略相同的网络与网关开销,也忽略连续批处理中等待与处理交错的复杂性,只比较 Q+P:
| 假设目的地 | 等待 Q | 到首 Token 的处理 P | 简化合计 |
|---|---|---|---|
| A:有可复用前缀,但排队更久 | 180 ms | 20 ms | 200 ms |
| B:无该前缀,但较空闲 | 20 ms | 100 ms | 120 ms |
A 的缓存让处理少了 80 ms,却多等了 160 ms,因此这个假设下 B 更早。如果 A 的等待降到 20 ms,其合计变成 40 ms,选择又会反转。所有毫秒都是为了说明条件而设定,不来自引擎跑分,Q 和 P 也不是未经校准就能直接取得的完美预测值。
在这个简化模型里,偏向热缓存副本的条件可以写成:它额外增加的等待,小于它预计节省的处理时间。这个关系是作者推导,不是 vLLM 或 SGLang 的内置评分公式,更不是完整客户端 TTFT 的精确分解。
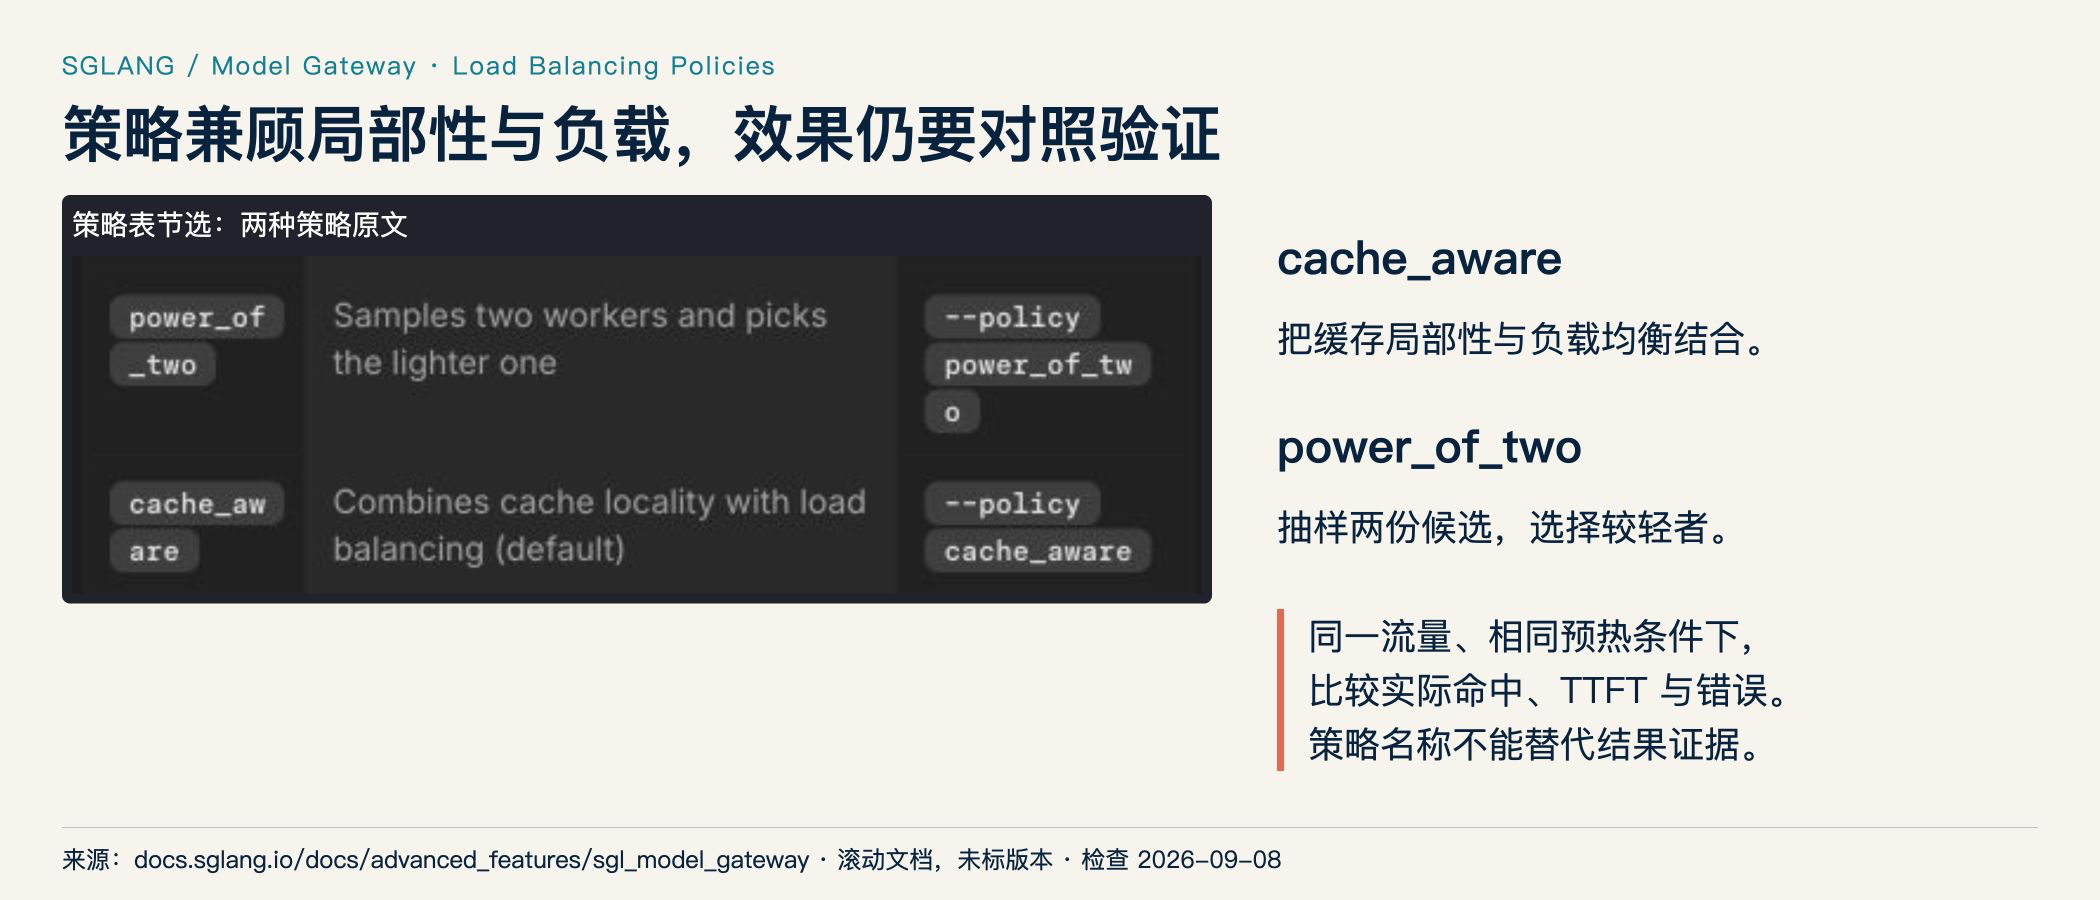
SGLang Model Gateway 的文档把 cache_aware 定义为同时考虑缓存局部性和负载均衡,并提供独立的平衡阈值配置。这说明“有缓存就永远粘住”的规则并非唯一选择。具体策略和阈值仍要针对版本、请求分布校准,不能从策略名称推断一定最优。SGLang Load Balancing Policies
空闲信号过期后,所有路由器可能挤向同一处
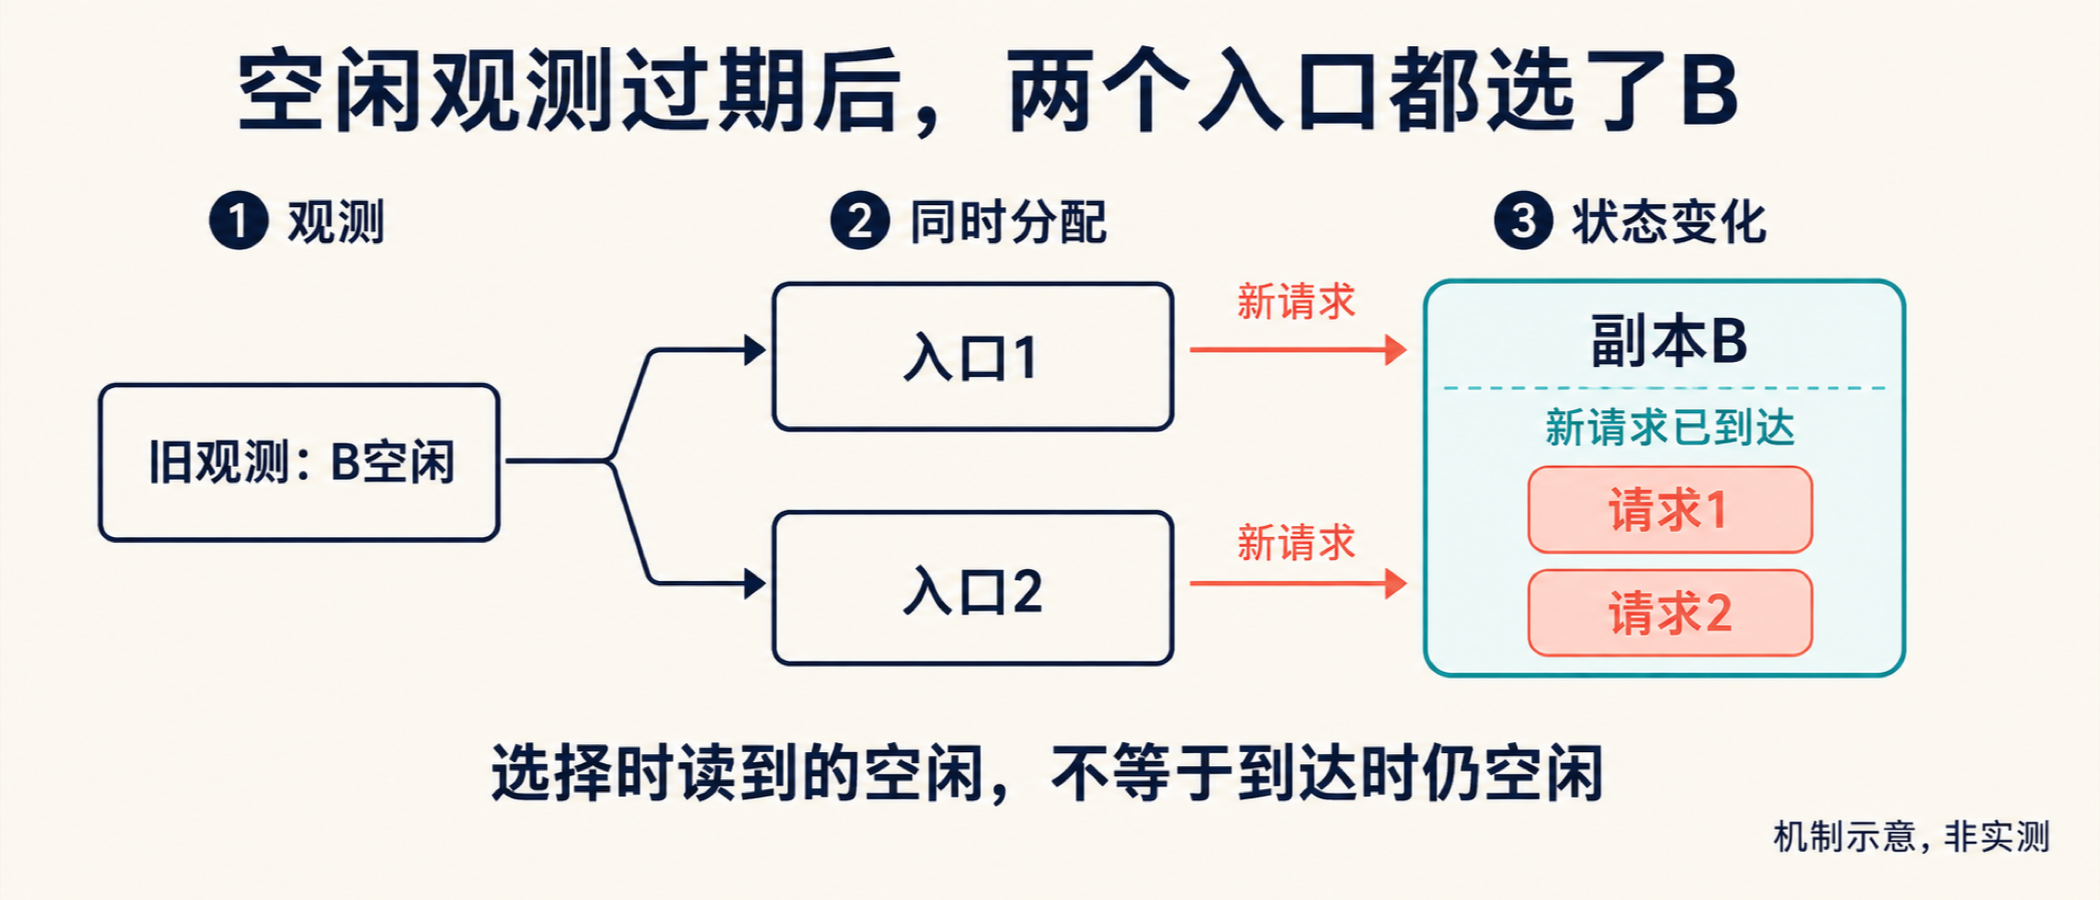
即使拿到了正确指标,决策仍会落后于系统。假设多个入口同时读到 B 很空闲,它们都把新请求发给 B。等下一轮指标更新时,B 已经成了热点。单次选择在当时看似合理,并不保证并发选择之后仍然合理。
缓存粘性也会放大这个问题:一个热门前缀可能把大量新请求持续吸向同一副本。若只按全局命中率优化,路由看起来更“聪明”,热点用户的首 Token 却可能更慢。
一种可检验的实现思路,是在选定副本时记录尚未被下一次遥测包含的分配量,再随着确认与完成回收。这是路由侧的短期估计,不是新的 GPU 容量事实。多入口各自计数仍可能遗漏对方分配,共享协调则增加成本。是否值得做,取决于观测是否真的显示同步追逐热点。较简单的随机抽样候选也可作为对照。SGLang 文档中的 power_of_two 就是抽取两个 worker 再选择较轻者,但“较轻”依赖的指标仍须核对。SGLang 路由策略
当所有兼容副本都没有可接受的余量时,排序不会创造容量。这时需要有界排队或明确拒绝,而不是把请求不断转发,直到超时。缓存偏好应排在兼容性、健康和接纳约束之后。请求取消也应沿链路传到实际执行端,并验证计算与缓存占用确实释放。仅关闭客户端连接不能当作释放完成的证据。
新副本加入后,权重加载和引擎预热完成,只能证明它开始具备接流量的条件,不代表业务前缀已经变热。退出副本则需要停止新分配、观察在途流式请求,再按明确的超时策略结束。故障后的重试是另一次执行。已经输出部分内容的响应如何续接、是否产生重复业务动作,要由上层协议定义,不能通过换一个副本自动解决。
用一次路由决策记录,检验新增副本是否有用
把路由策略放进真实系统前,先固定副本数量与每份副本的模型并行配置。这样比较的是“同一组服务如何接请求”,不会把增加 GPU 的收益误记到路由算法头上。
保留相同的整机到达时间序列、输入和输出上限,分别运行轮询与候选策略。至少区分冷缓存启动和相同预热过程后的运行,不把一条策略预热后的缓存留给另一条当作公平起点。除了同质短请求,还应放入长短混合、重复前缀热点和突发流量。输出长度不一定完全一致,要保留实际生成长度与结束原因,检查是否因更早截断而显得更快。
每次选择留下一个能回看因果的记录,而不是只留“选了 B”:
请求标识、模型/版本、输入长度、输出上限:待记录
候选端点与副本身份,排除原因:待记录
决策时指标时间、等待/运行项、KV 状态:未测
缓存可复用的估计,以及随后实际命中情况:未测
选定副本、选择原因、尚未确认的分配估计:待记录
服务端排队与处理记录、客户端首 Token 时间:未测
实际输出长度、逐请求平均 TPOT、完成/失败/取消:未测
用请求标识关联客户端和服务端事件,不直接相减未经校准的跨机时间戳。缓存预测与实际命中也要分开记录,否则“路由选错了”和“到达后缓存被淘汰了”会变成同一个问题。
评价时同时看首 Token 延迟、后续输出等待和错误率。逐请求平均 TPOT 是首 Token 之后的平均每 Token 时间,输出不足两个 Token 的样本单列,它不能揭示每次流式停顿。可以预先设定 TTFT 与 TPOT 上限,统计在窗口内同时满足两者的成功完成量。超时、拒绝、失败和未完成请求另列,不能只比较幸存请求的平均延迟。这里的目标内完成量不是回答语义正确性的证明,质量与业务验收仍需保留。
同一篇长文档在多个副本同时预热,可能减少单副本热点,也会重复占用缓存。短请求占多数时,简单策略可能已经足够。候选策略只有在目标流量下改善了服务结果,且遥测、协调与运维成本可以接受,才值得替换基线。
DP 复制的是服务能力,路由决定这些能力怎样被使用。请求数能告诉你发出了多少任务,缓存能告诉你可能省下多少重复计算,只有结合当前工作与后续结果,才知道请求是否送到了真正有余量的副本。
资料检查日期:2026-09-08。PyTorch 引用固定为 2.14。vLLM stable 与 SGLang 文档可能更新,实施前须核对安装版本。本文未运行多 GPU 部署、路由压测、缓存迁移或故障恢复实验。