我在一张 RTX A6000 48GB 上测了一套 27B FP8 的 vLLM 服务。跑分表第一眼很好看:长输出约 23.5 token/s,80 个 JSON Schema 样本全部通过,短时 soak 也是 100/100。
如果只看这些数字,很容易得出一句“可以上生产”。我重新检查原始 JSON、脚本和日志后,没有采用这个结论。真正能确认的是:这套服务已经通过一组有范围的实验室探针。它的交互速度、缓存收益、并发代价和部分协议能力已经有数据,但模型身份、真实 Agent 任务与生产稳定性还没有闭环。
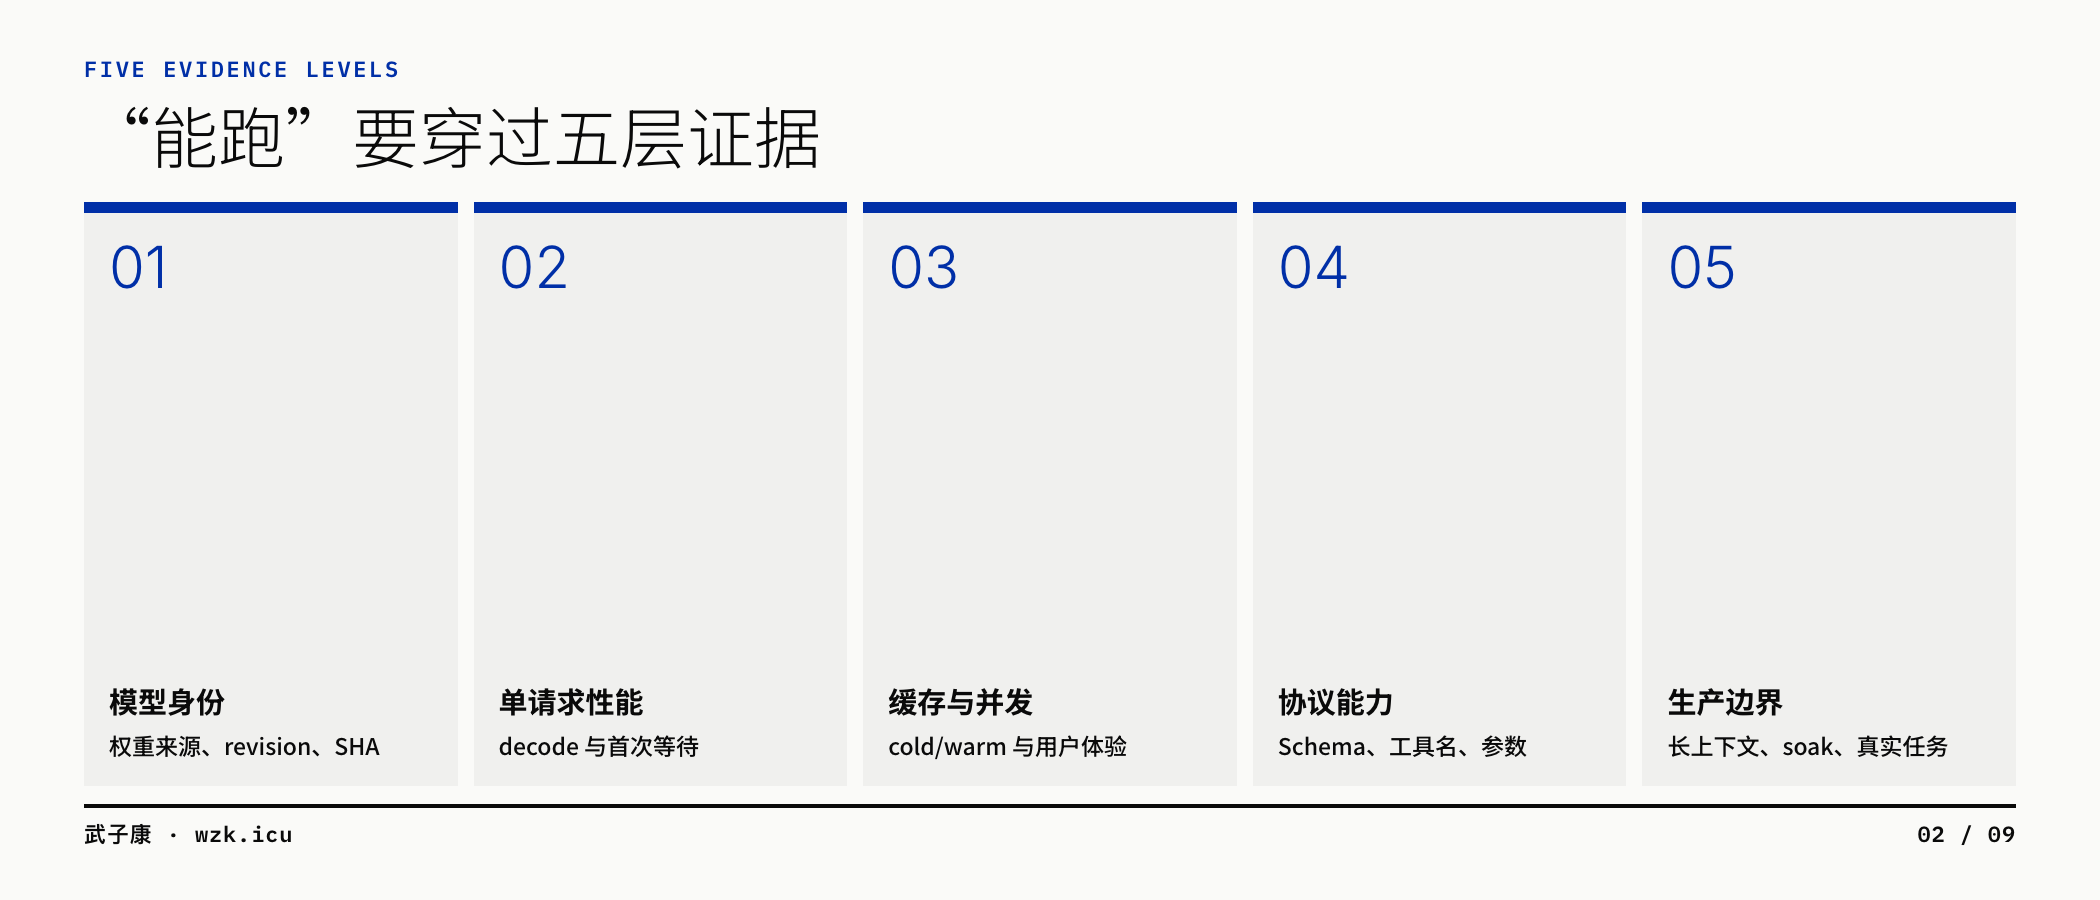
这次复盘最后留下的是一套五层证据表。以后再评估本地模型,可以先问清楚每个数字究竟证明了哪一层。
第一层:先确认你测的到底是谁
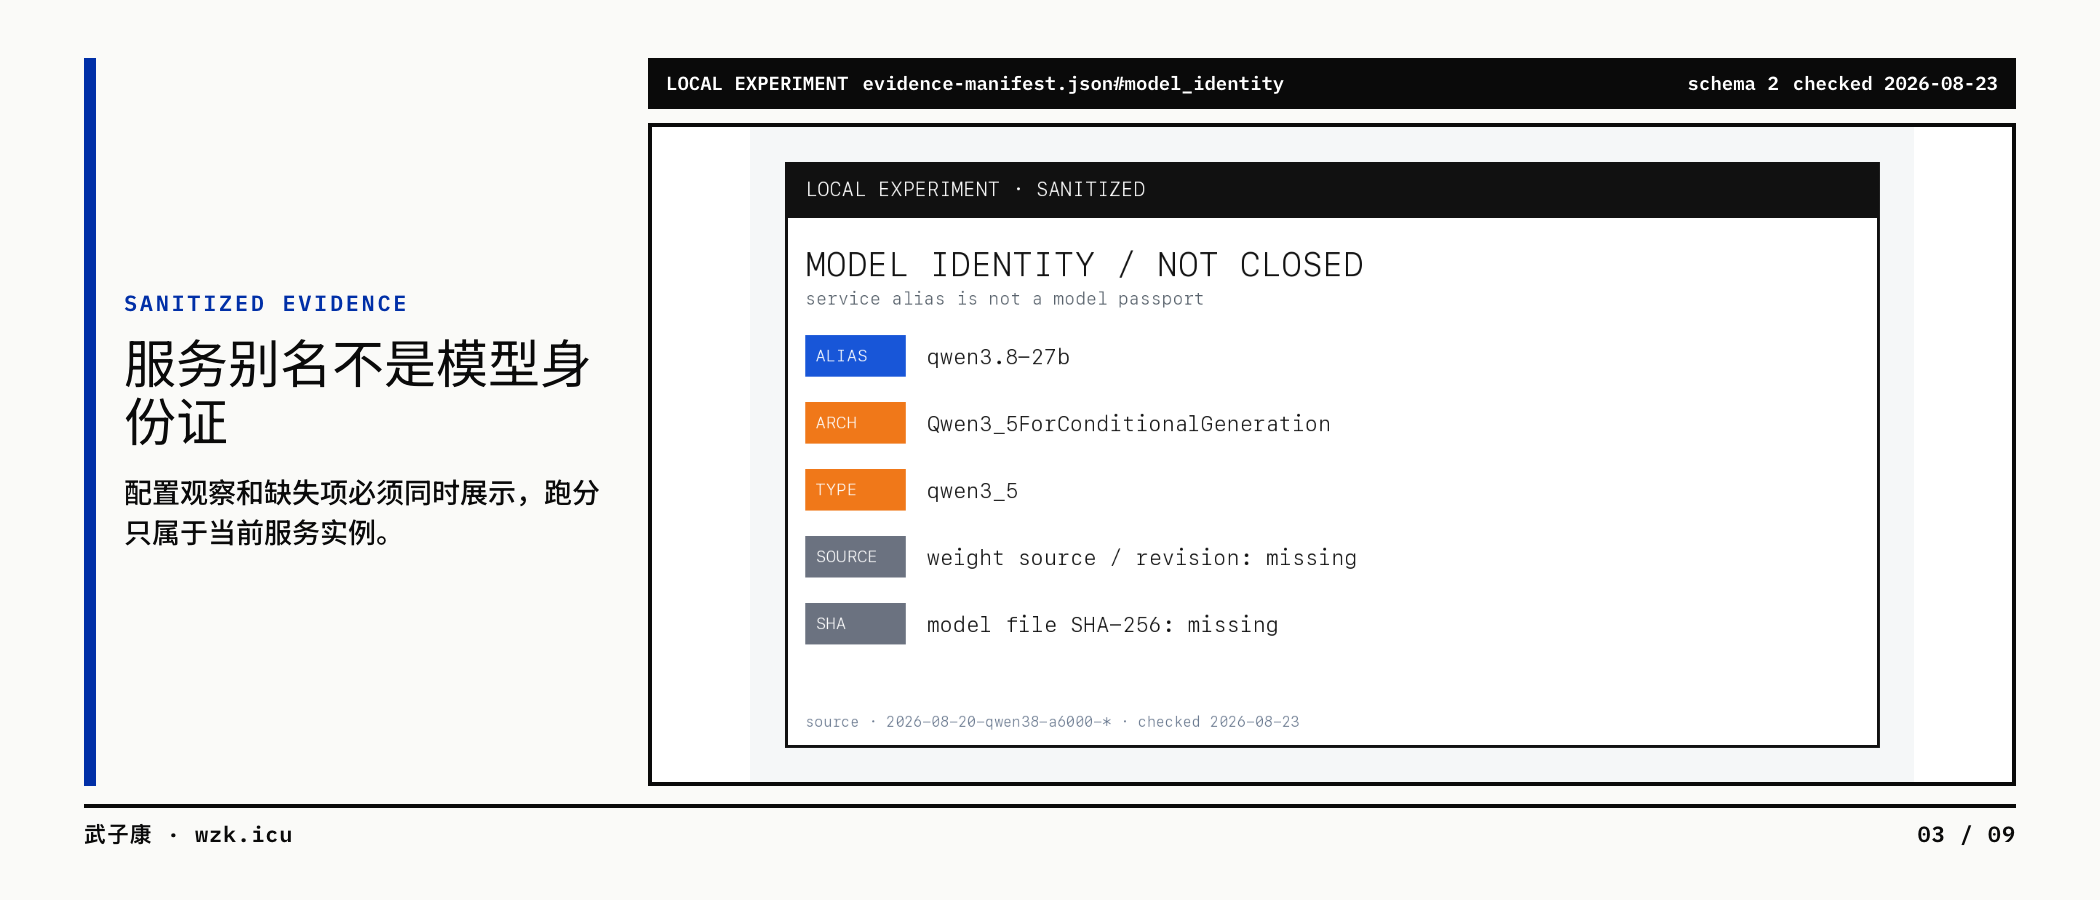
服务对外暴露的名字是 qwen3.8-27b,模型目录也叫 Qwen3.8-27B-FP8。但留下的配置摘录显示,架构类是 Qwen3_5ForConditionalGeneration,model_type 是 qwen3_5。
这只能证明“某个服务别名加载了一套被配置识别为 Qwen3.5 架构的 27B FP8 权重”。当前材料没有权重发布页、模型卡、下载 revision 和模型文件 SHA-256,因此无法证明它对应某个官方发布型号。
这一步看起来与性能无关,实际上决定了文章能不能被复现。服务名可以随手改,目录名也可以重命名。没有权重来源和哈希,23.5 token/s 只能属于这次服务实例,不能变成“某款官方模型在 A6000 上的速度”。
以后我会把模型身份单独列为部署验收项:
| 项目 | 当前状态 | 发布时如何表述 |
|---|---|---|
| 服务别名 | 已记录 | 只用于定位当前 API |
| 配置架构 | 已记录 | 写成观察结果 |
| 权重来源与 revision | 缺失 | 不推断官方型号 |
| 模型文件 SHA-256 | 缺失 | 不声称可精确复现 |
第二层:把“速度”拆成首次等待、持续生成和缓存命中
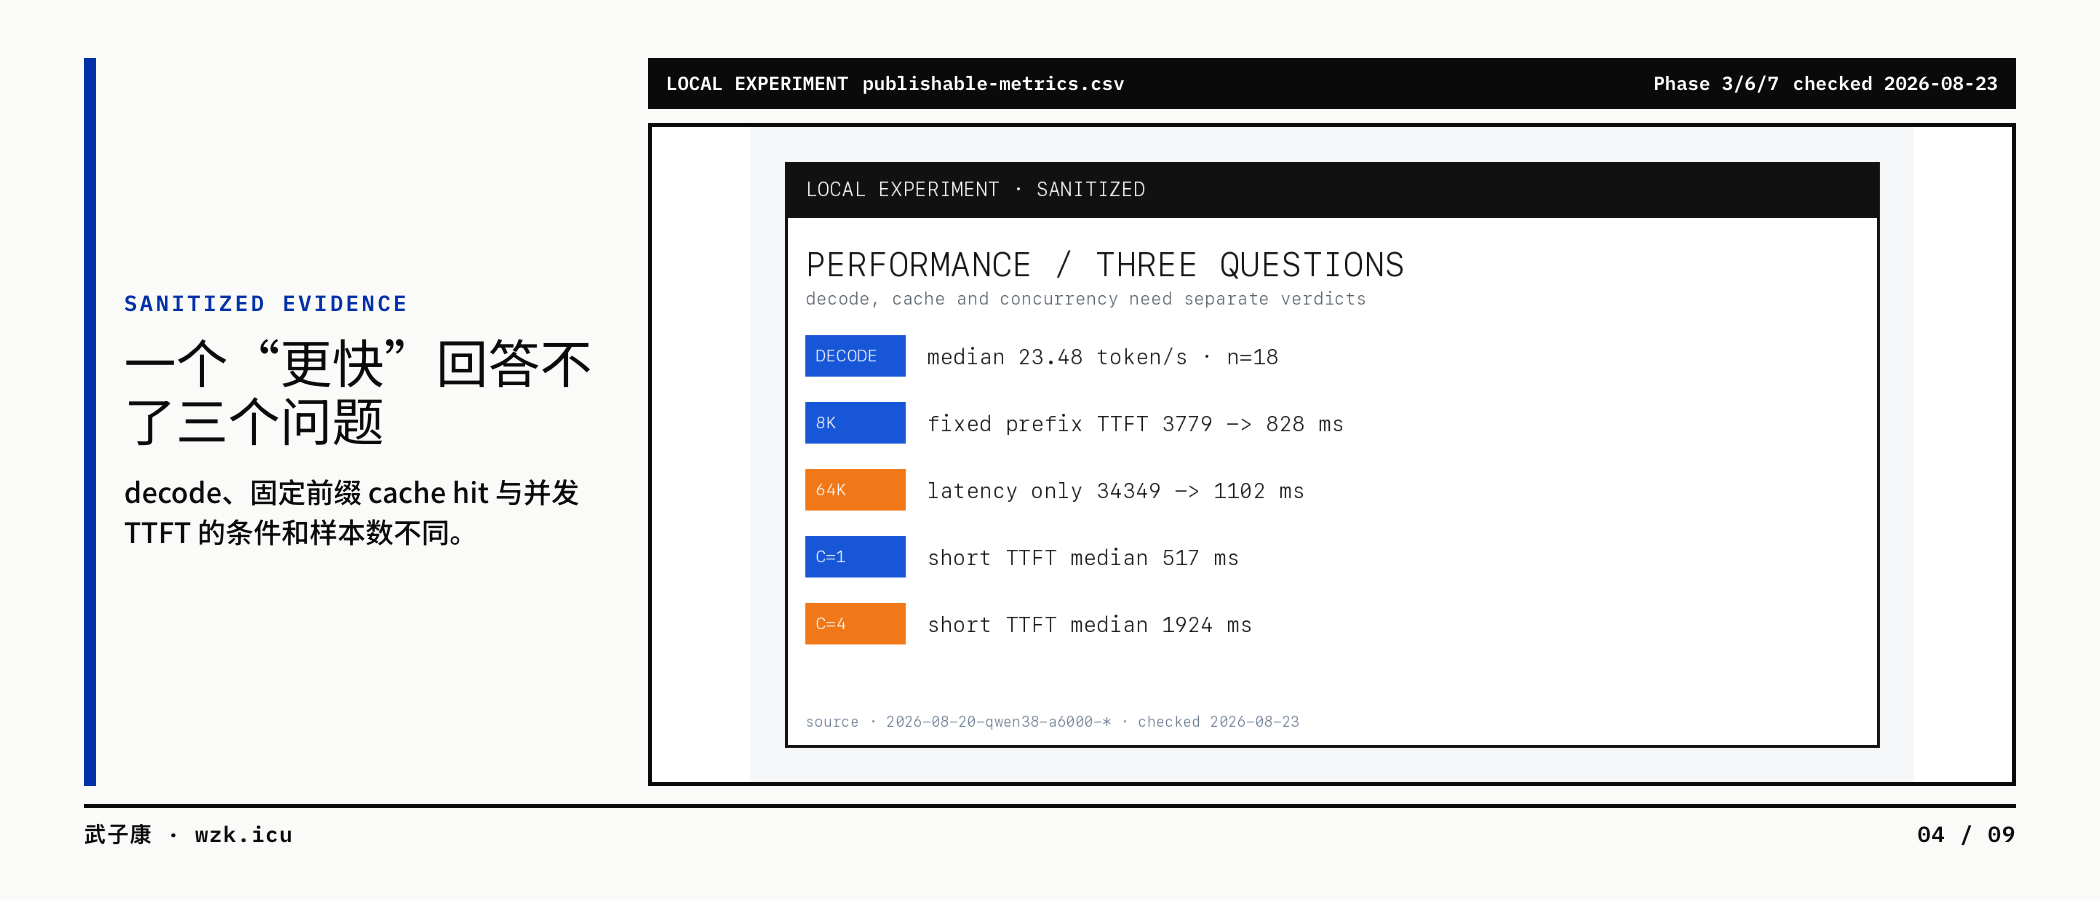
Phase 3 有 18 个长输出样本,decode 中位数是 23.48 token/s,范围约为 22.68–23.85 token/s。这组数据可以回答一个窄问题:在当时的服务配置下,单请求持续生成大约是什么节奏。
它回答不了首次响应要等多久。TTFT 会受到 prompt 长度、调度、缓存状态和并发影响。固定前缀实验把这个差别展示得很清楚:
| 固定前缀规模 | 第一次 TTFT | 后续请求 TTFT 中位数 |
|---|---|---|
| 8K | 3779 ms | 828 ms |
| 16K | 7569 ms | 573 ms |
| 32K | 15821 ms | 1147 ms |
| 64K | 34349 ms | 1102 ms |
这里能确认的是,同一组固定前缀被复用后,后续请求明显更快。不能直接写成“64K 仓库上下文只需 1.1 秒”,因为真实仓库会不断改变文件、工具结果和元数据。只要前缀不再完全匹配,实验里的收益就可能缩小。
对 Coding Agent 来说,这个边界比一个漂亮的倍数更重要。仓库快照、系统提示词和工具说明如果每轮都变化,缓存能力再强也吃不到命中。部署侧需要记录 cold 与 warm 两组 TTFT,并明确什么内容可以保持稳定前缀。
第三层:聚合吞吐和单用户体验不能共用一个“更快”
Phase 7 的短任务里,并发 1 时单请求 TTFT 中位数约为 517 ms,并发 4 时升到约 1924 ms。中、长任务也出现了同方向变化。
这不代表并发 4 配错了。提高并发可以增加单位时间完成的总 token 数,但请求要在调度器里共享计算资源,单个用户会更晚看到第一个 token。内部批处理服务关注聚合吞吐,交互式 Agent 更在意首字等待。两种目标需要不同的配置和验收指标。
因此,max-num-seqs=4 不能单独被评价为好或坏。至少要先回答三个问题:
- 同时活跃的真实会话有多少;
- 业务更在意每分钟总产出,还是一次对话的等待感;
- 超过目标 TTFT 后,是排队、降级还是扩副本。
没有这三个答案,继续比较并发 1、2、4 的跑分,只是在优化一个尚未定义的目标。
第四层:协议通过率要按能力面分别看
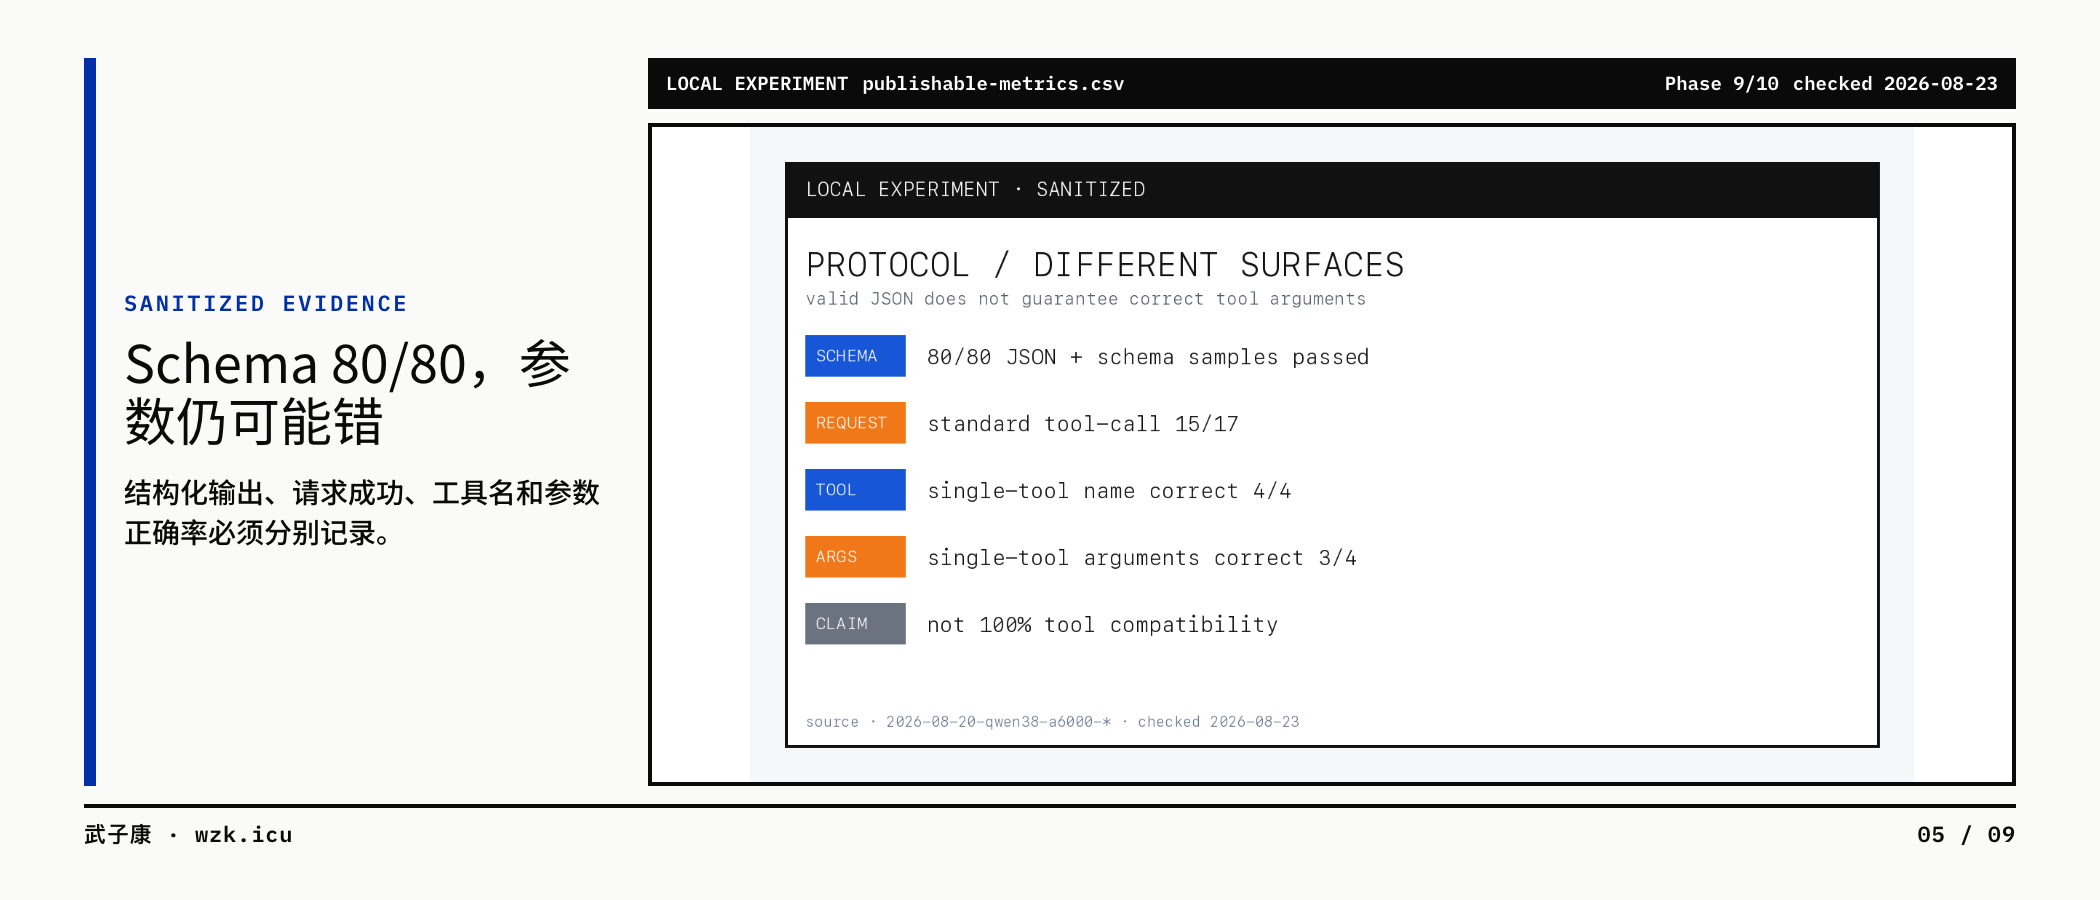
结构化输出测试共有 80 个样本,1K、8K、32K、64K 四组各 20 个,本轮全部通过 JSON 与 Schema 检查。这说明服务在这组受控任务中能够稳定返回目标结构。
工具调用没有同样整齐。启用标准 OpenAI tool-call 路径后,17 条探针中有 15 条请求成功。四个单工具样本的工具名都正确,但参数只有 3/4 正确。其中一个列表工具选择对了, pattern 参数却没有满足预期。
这两组结果放在一起,能得到一个更具体的判断:模型可以生成合法 JSON,不代表它一定能在真实工具合同里选对字段、填对参数、处理歧义并完成多轮恢复。生产验收应该分别记录:
- 输出能否解析;
- 是否满足 Schema;
- 工具名是否正确;
- 参数是否满足业务约束;
- 工具失败后能否调整;
- 多轮任务是否真正完成。
把这些项目压成一个“工具调用成功率”,会掩盖最需要修的那一层。
第五层:能接受请求、完成探针和可运行生产是三件事
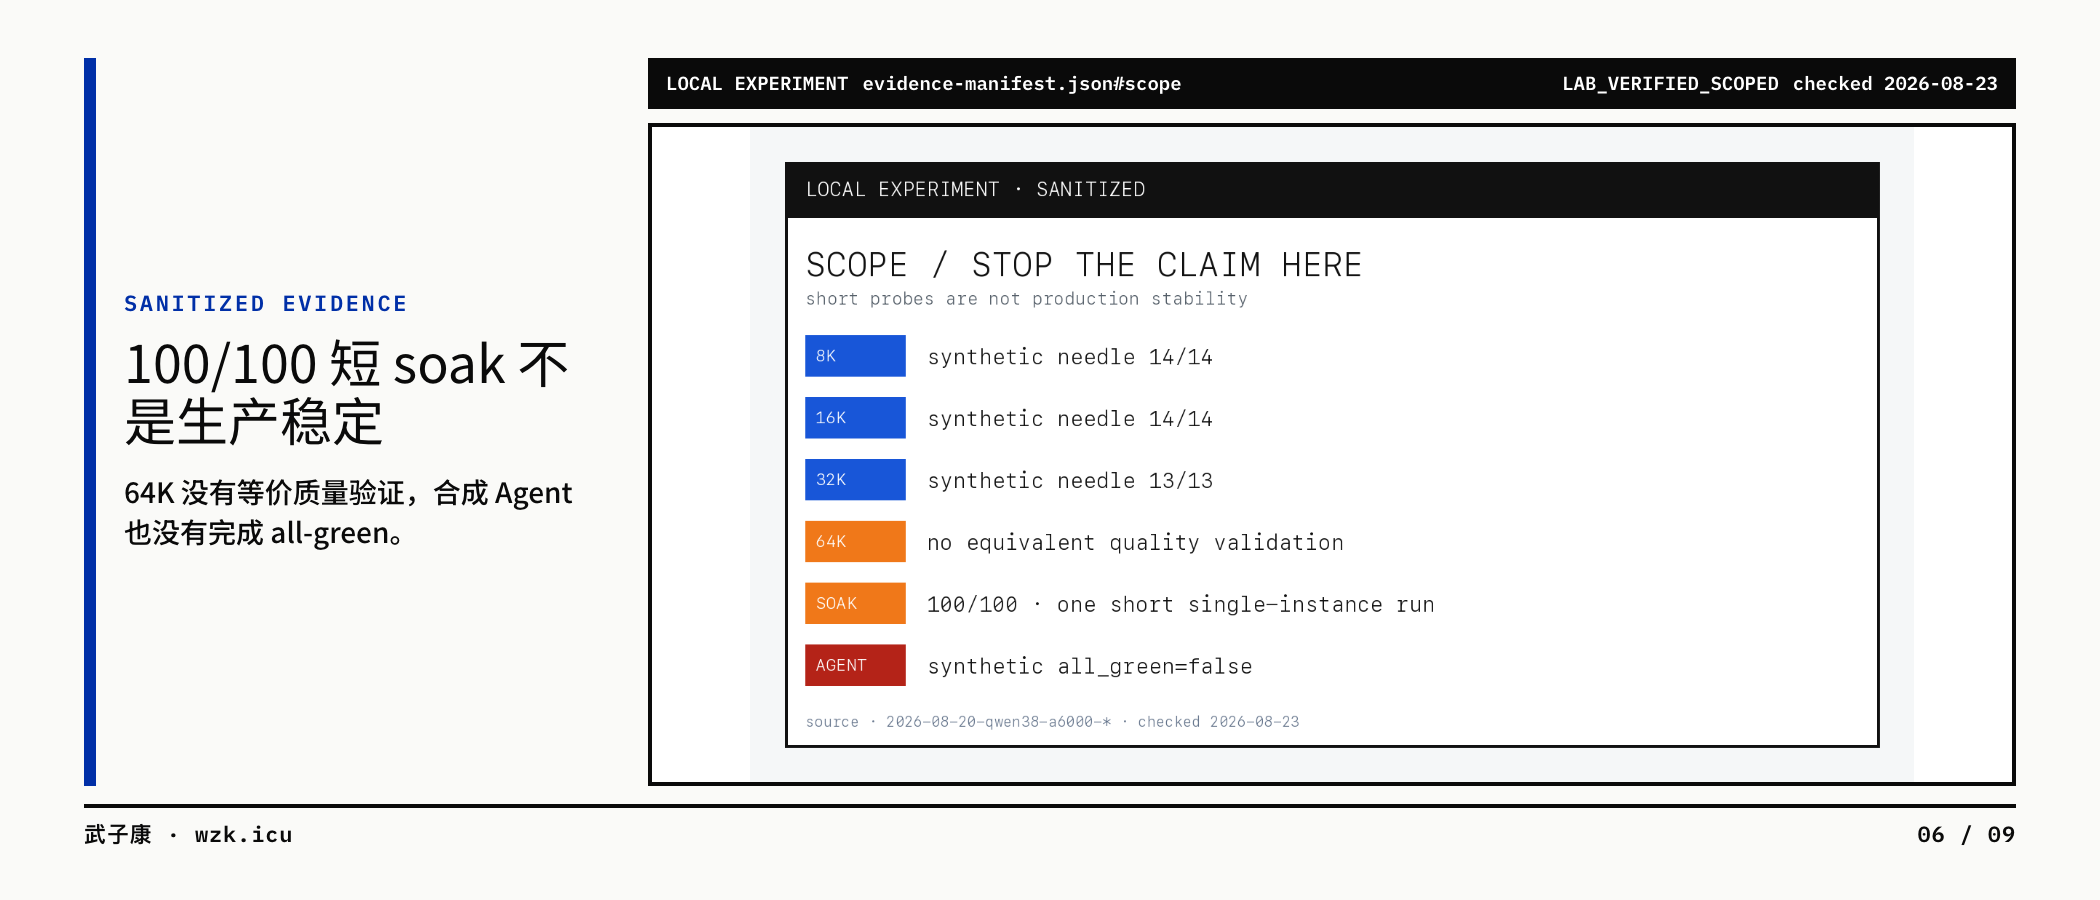
长上下文测试也有类似陷阱。8K、16K、32K 的合成 needle 分别是 14/14、14/14、 13/13。64K 固定前缀的时延探针可以完成,但没有同等的质量验证。于是“接口接受 64K”和“64K 内容仍然可靠”必须分开记录。
短时稳定性测试的 100 个请求全部返回成功,也只能证明当时单个实例完成了一次短 soak。它没有覆盖多日运行、容器重启、请求取消、GPU 错误、KV 压力恢复和上游重试。把 100/100 写成“生产稳定”,会把大量尚未测试的故障路径藏起来。
Agent 证据更需要降级。现有脚本使用内存字典模拟文件系统,测试工具会按预设条件返回结果。v2 标准工具版本最终 all_green=false,模型陷入多次 run_cmd 探索,没有完成修复闭环。这组记录可以帮助定位工具选择和提示词问题,但它既不是真实 Git 仓库,也没有执行真实测试,不能称为 Coding Agent E2E。
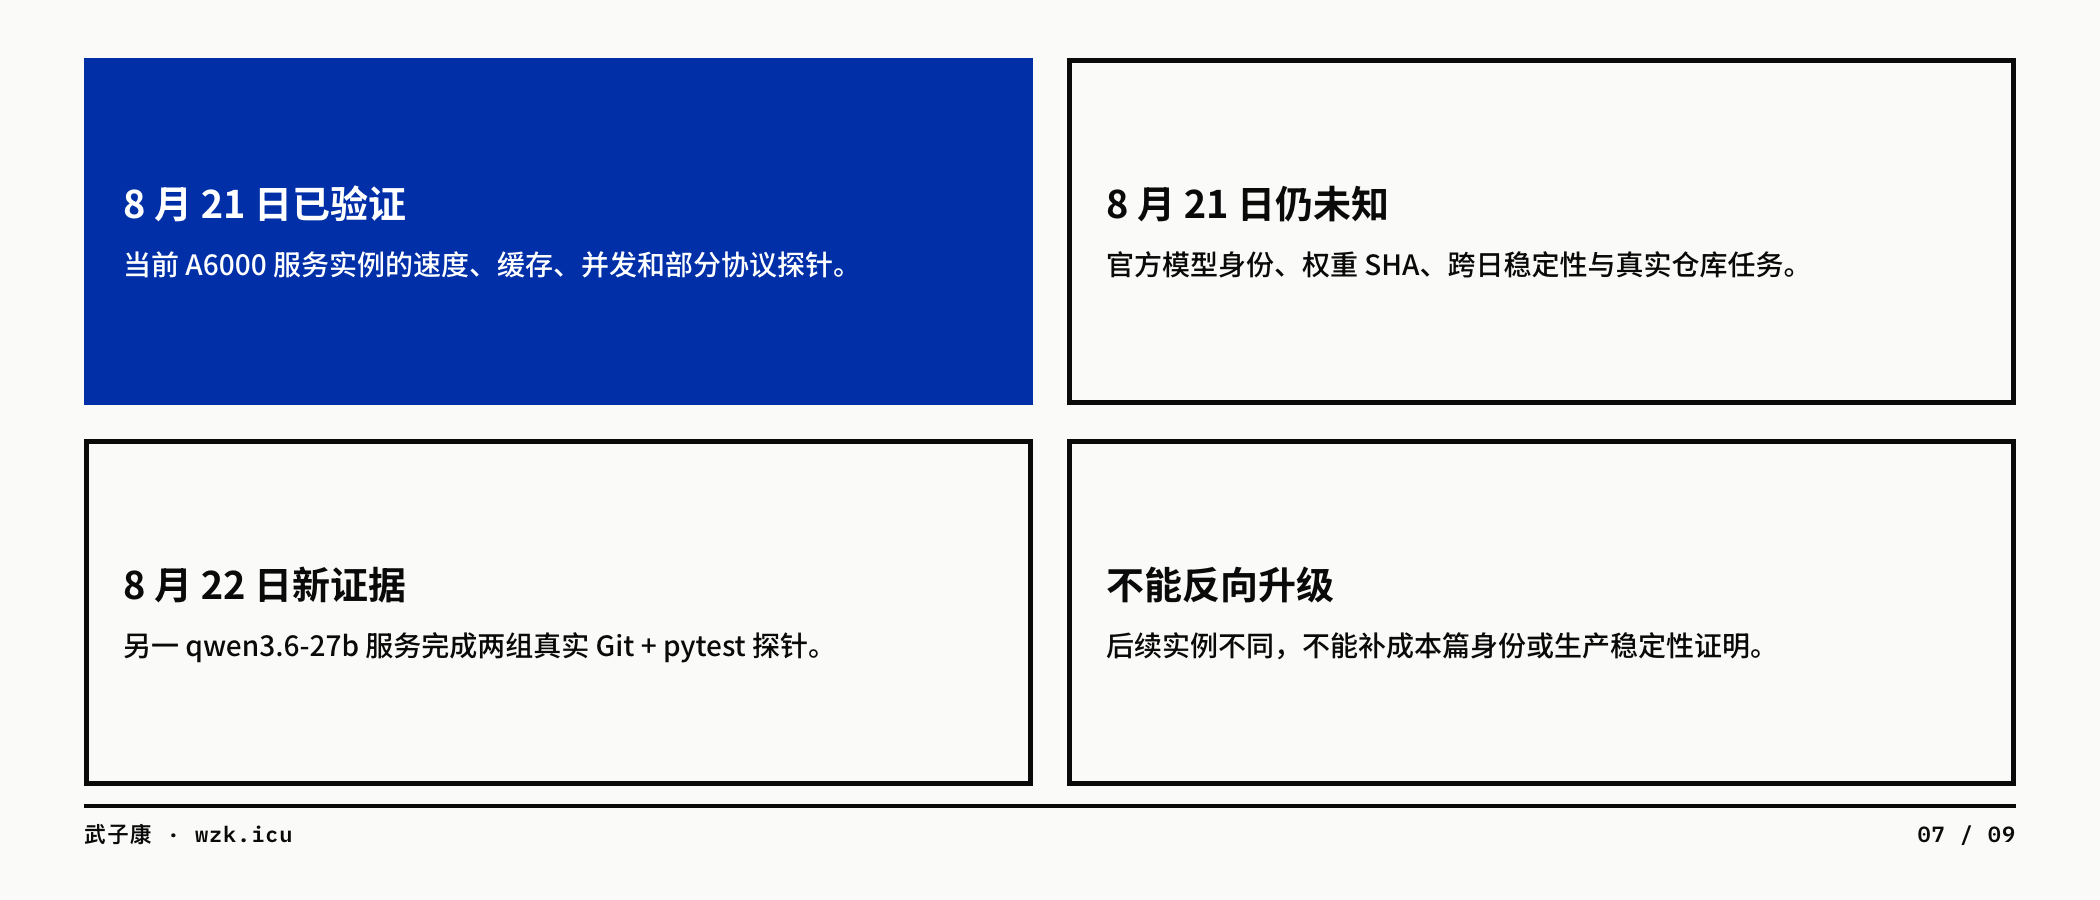
这组材料冻结于 2026 年 8 月 21 日。当时真正的下一关很具体:准备一个隔离 Git 仓库,让 Agent 读取真实文件、修改工作树、运行真实测试,至少保存一条成功 trace 和一条失败恢复 trace。验收要看仓库状态、测试结果和任务目标是否一起闭环,不能只看有没有发出工具调用。
8 月 22 日,我在恢复后的 qwen3.6-27b 服务上补做了两组真实 Git 探针,两组都完成了 pytest 与 diff 闭环,其中一组还恢复了一次补丁冲突。这是后续独立实验,不会反向补齐本篇服务别名 qwen3.8-27b 的模型身份,也不能把本篇短时跑分升级成生产结论。
一张可直接复用的部署验收表
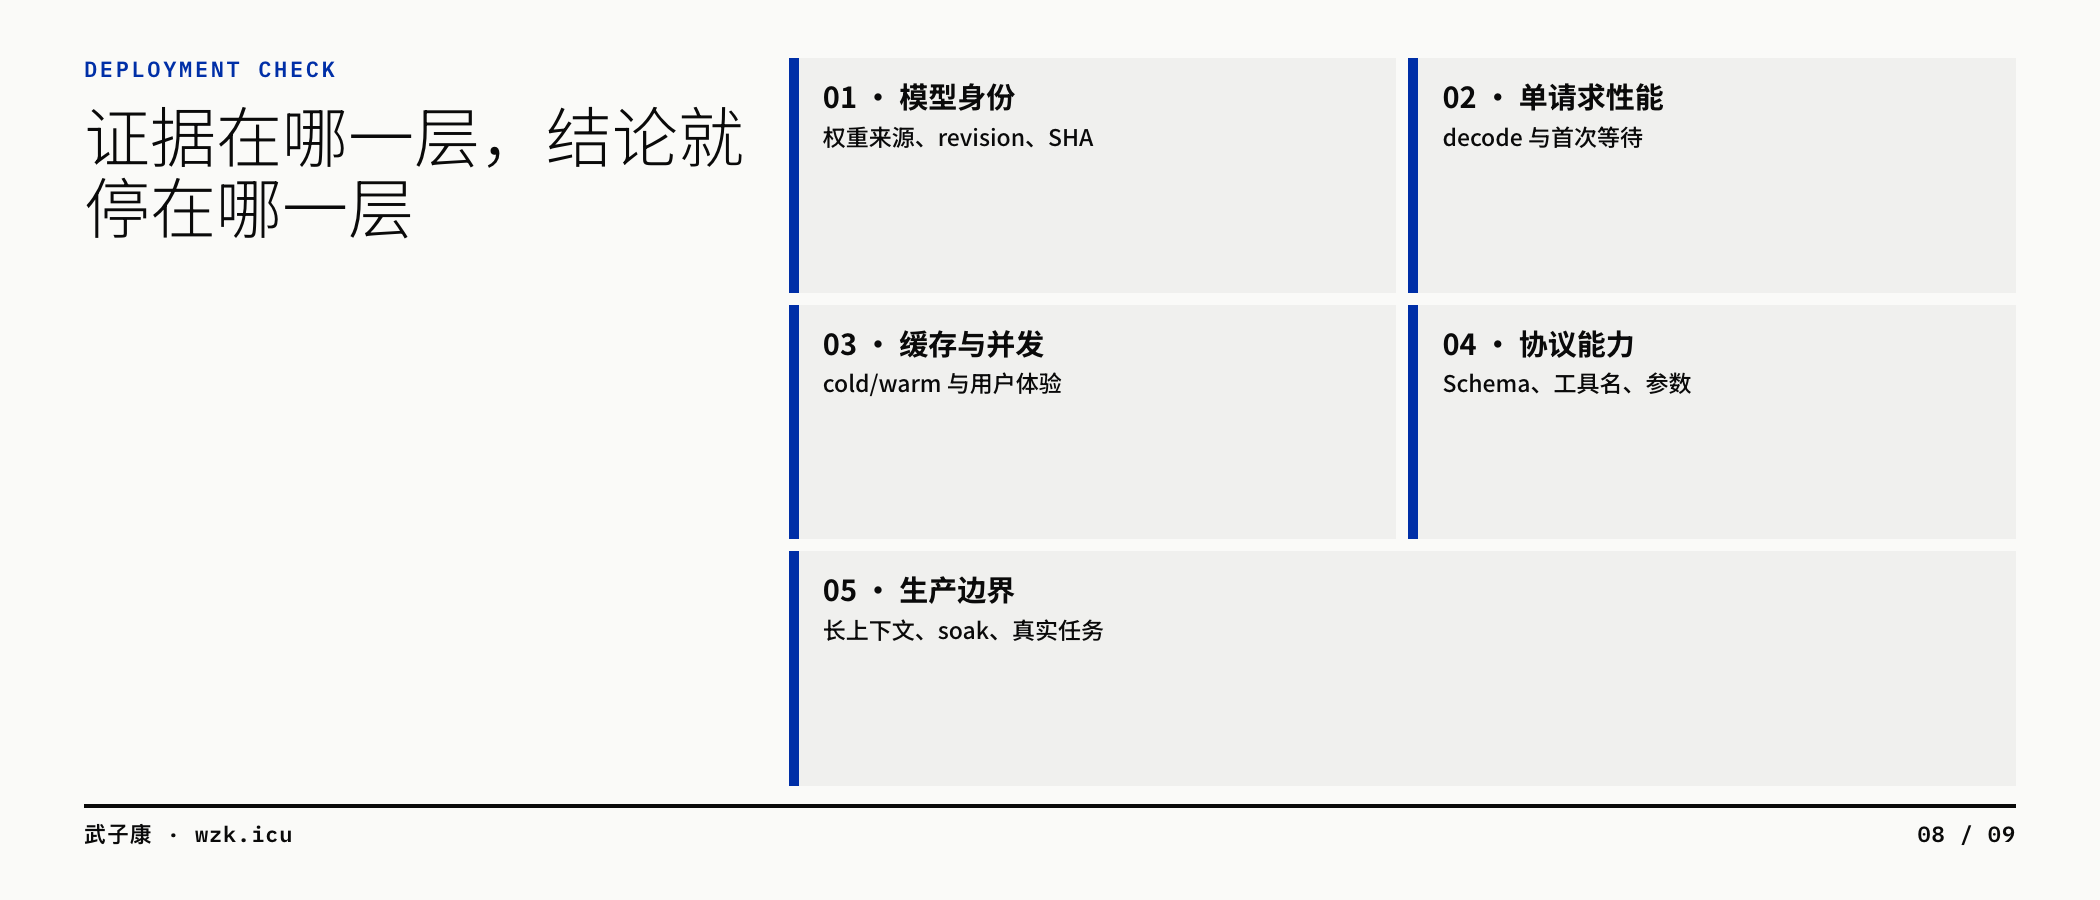
| 证据层 | 当前结论 | 状态 | 下一项最小动作 |
|---|---|---|---|
| 模型身份 | 服务别名和配置架构已知 | 未闭合 | 补权重来源、revision、文件 SHA |
| 单请求性能 | decode 约 23.48 token/s | 实验室已验证 | 固定环境复跑并保留 run_id |
| 缓存与并发 | 固定前缀收益明显;c=4 TTFT 更高 | 实验室已验证 | 用真实仓库快照测 cold/warm |
| 输出与工具协议 | Schema 80/80;标准工具 15/17 | 部分闭合 | 扩充参数错误和恢复用例 |
| 长上下文质量 | 合成 needle 验证到 32K | 部分闭合 | 64K+ 增加等价质量任务 |
| Agent 任务 | 仅合成环境,v2 未 all-green | 未闭合 | 运行真实 Git 仓库任务 |
| 稳定性 | 单次短 soak 100/100 | 未闭合 | 加跨日、重启与故障注入 |
这张表给我的最终判断是:单卡 A6000 上这套 27B FP8 服务已经值得继续工程化,但当前最合理的身份仍是“有边界的实验室候选”。下一轮不需要把所有 Phase 再跑一遍。先补齐模型身份,再用真实仓库任务验证工具闭环,最后针对候选生产配置做单变量 A/B,信息增量会比重复刷一轮总分更大。
漂亮的跑分可以证明某个探针通过。部署决策需要知道,哪些层已经有证据,哪些层仍然是空白。把这条边界写清楚,才是这次 A6000 实测最值得保留的结果。